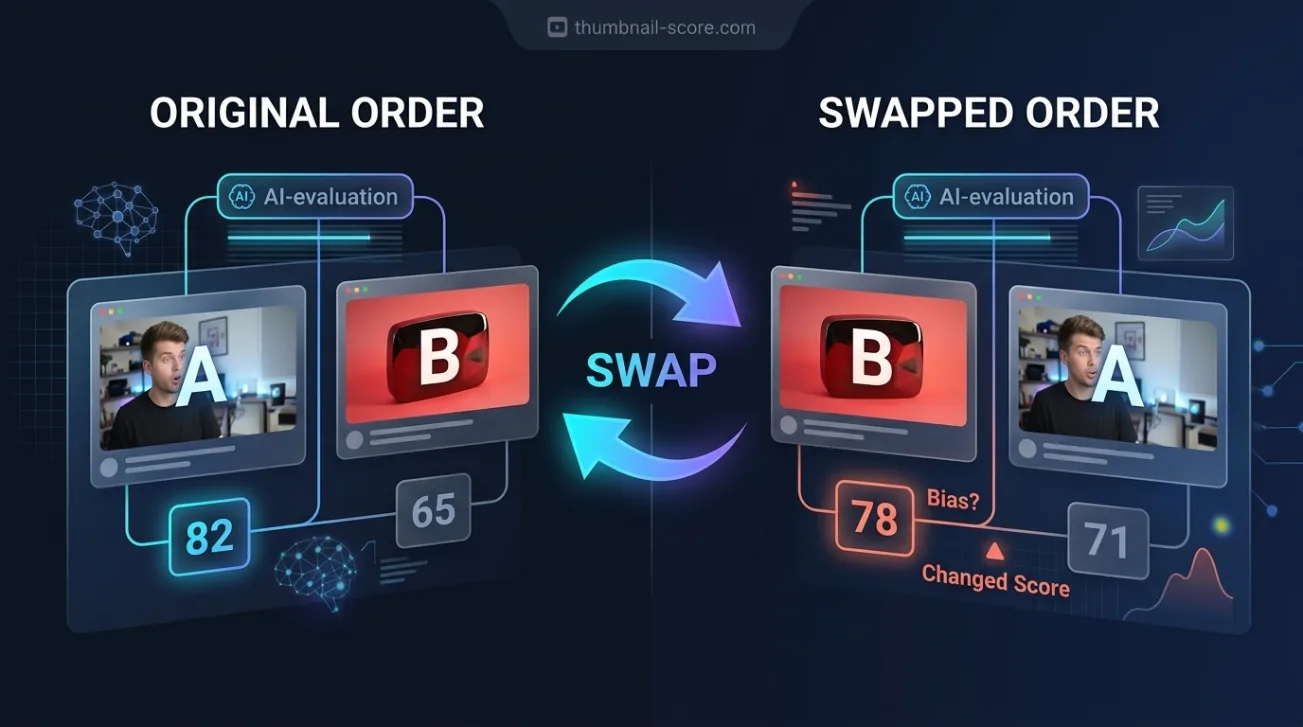
如果你曾将两张缩略图粘贴进AI聊天框,询问哪张会获得更多点击,那你其实做了一次没有控制变量的实验。我们做了一次有控制的实验:161组真实视频,我们已知哪组表现更好,每组向AI展示两次,顺序各一次。结果发现,AI先看到的缩略图很大程度上决定了它的答案。
关键结论
- 面对同一频道的两张缩略图,AI有64.7%的概率选择先看到的那张。若无位置偏好,正确率应接近50%。
- 当真实优胜者恰好先展示时,AI正确率为77.3%;当同一优胜者后展示时,正确率降至48.0%。
- 综合两种顺序,AI平均正确率为62.7%,与我们单独评分每张缩略图的得分完全一致。并排比较并未提升准确率。
- 在30.7%的组别中,仅因顺序改变,AI给出了相反答案。
- AI几乎从不承认不确定:典型答案声称85%置信度,而实际正确率约为63%。
AI能判断哪张缩略图表现更好吗?
有时可以,但单次回答不可信。综合两种顺序,我们测试的模型选对表现更佳缩略图的概率为62.7%——与我们单独评分每张缩略图的得分完全一致。但它的选择取决于先看到哪张图:优胜者先展示时正确率77.3%,后展示时仅48.0%。
简单来说,单次回答就像一枚偏向第一个选项的硬币。信息确实存在——当模型在两种顺序下给出相同答案时,正确率高于随机——但你必须问两次才能发现。
我们如何测试:真实配对、已知答案、双向展示
这些配对来自我们已发布的评分测试:同一频道发布的两支视频,发布时间相近,一支明显优于频道近期平均表现,另一支明显低于。使用同一频道可消除订阅数、受众和制作预算的影响,因此两支视频的差异主要体现在包装上。
我们使用了研究中一半频道的161组配对,另一半保持未动。AI——即驱动我们评分系统的同一视觉模型——被展示两张缩略图及其真实标题,被告知其中一张表现优于频道常规观看量,另一张表现较差,然后被要求判断哪张是优胜者。322个答案中有11个不可用,最终剩下150组配对在两种顺序下均获得回答。
为何每组必须展示两次
AI在比较两个选项时,可能因位置偏好而倾向某一侧,就像有些人总喜欢列表中的第一个选项。若存在这种偏好,而你只按一种顺序展示每组配对,就无法将其与真实能力区分开:当更好的缩略图恰好排在第一位时,总是选第一个图像的评判者看起来很厉害。
每组展示两次并调换顺序,可将两者区分开。能力应不受顺序影响,而位置偏好则会随顺序翻转。
先展示的缩略图赢得多数“争论”
在300个回答中,AI有64.7%的概率选择先看到的缩略图。这种偏好改变了单次回答的价值:
| 配对展示方式 | AI选中真实优胜者的频率 |
|---|---|
| 优胜者先展示 | 77.3% |
| 优胜者后展示 | 48.0% |
| 两种顺序平均 | 62.7% |
| 我们的评分系统,单独评分每张缩略图 | 62.7% |
| 两种顺序下答案一致且正确 | 47.3%(随机猜测:约25%) |
平均行是与单独评分每张缩略图的评分系统的公平比较,因为两者每组都只给出一个答案。在此基础上,两种方法打平,均为62.7%。并排比较并未增加准确率,反而增加了对顺序的依赖。
最后一行是更严格的测试:仅当AI在两种顺序下都选中同一张正确缩略图时,答案才算通过。随机猜测的评判者约有四分之一概率通过,而总是选第一张图像的评判者则永远不会通过。AI在47.3%的配对中通过,说明信号确实存在——只是与位置纠缠在一起。
近三分之一的配对中,AI改变了主意
在150组配对中的46组(30.7%),AI仅因顺序改变就给出了相反答案。两张缩略图和标题在两次提问中均未改变。
在其余104组中,AI保持一致,正确率为68.3%。我们的评分系统在相同104组中正确率为63.5%。这个差距太小,无法在当前样本量下确定,但它指向一个有用的方向:经得起顺序调换考验的答案,比未经测试的答案更有价值。
它的置信度数值并非概率
我们要求每次回答附带置信度数值,并告知AI 50代表抛硬币。它几乎未使用量表的下半部分。在全部300个回答中,其最低置信度为65,典型回答声称85,仅4个回答低于70。
与此同时,它实际正确率约为63%。它评为80至89分的答案正确率为61.6%;评为70至79分的答案正确率为63.5%。在它绝大多数答案所在的范围内,该数值无法告诉你哪些答案更可信。
它评为90分及以上的17个答案正确率为82.4%,这有一定提示意义,但17个样本太少,不足以依赖。实用解读很简单:AI比较时的自信语气是其默认模式,而非证据。
五分钟内检查任何AI缩略图评判工具的方法
我们只测试了一个模型,其他工具行为可能不同。你无需完全相信我们的结论,因为你可以快速自行验证:
- 选择两张你已知答案的缩略图:你自己频道近期发布的两支视频,一支明显高于常规观看量,另一支明显低于。
- 让AI判断哪支表现更好,先展示表现更强的那支。记录其答案及任何置信度。
- 开启新对话,确保AI不记得第一次答案,再以相反顺序提问。
- 至少重复十组配对。统计它选择先展示图像的频率,以及答案经得起顺序调换考验的频率。
- 仅信任经得起顺序调换考验的答案,完全忽略置信度数值。
如果你希望获得完全不依赖展示顺序的数值,可以单独为每张缩略图和标题评分。为每个选项单独评分,之后再比较,不存在“先展示”的位置偏好。
本实验未展示的内容
我们仅测试了一个模型和一套指令。不同模型,或同一模型以不同方式提问,可能对第一位置的偏好更强或更弱。重点不在于每个AI都如此,而在于单次比较无法告诉你你使用的AI是否如此。
我们选择的配对因表现差异显著,因此这些准确率数据描述的是明显优胜者对明显失败者,而非表现几乎相同的两张缩略图。所有频道均为成熟且使用英语的频道。
此外,这一切与真实A/B测试无关。真实测试面向真实观众,测量他们实际行为。本实验仅关注AI提前预测该结果的能力。
常见问题
AI聊天机器人能选出最佳YouTube缩略图吗?
部分能。我们测试的模型平均约63%的概率选中表现更佳的缩略图,虽优于随机,但并未优于单独评分每张缩略图。其答案高度依赖先看到哪张图,因此单次回复不可靠。调换顺序问两次,仅信任经得起调换考验的答案。
AI比较中的位置偏见是什么?
位置偏见是指因选项出现位置而非内容本身而偏好某选项。在我们的测试中,AI有64.7%的概率选择先看到的缩略图。解决方法是每组比较均以两种顺序展示,并将答案随顺序翻转的情况视为无答案。
单独评分缩略图还是并排比较更好?
在我们的测试中,两种方法平均准确率相同,均为62.7%。区别在于稳定性。单独评分每张缩略图,无论检查顺序如何,结果一致;而并排比较在近三分之一的配对中,答案随顺序改变。
为什么AI听起来如此确信它的答案?
因为自信措辞是其默认模式,而非真实测量。当被要求评估自身确定性时,我们测试的模型几乎从未低于70分(满分100),通常声称85分,而实际正确率约为63%。在此范围内,更高的声称置信度并不意味着更可靠的答案。
这是否意味着缩略图A/B测试毫无意义?
不。真实测试面向真实观众并测量其实际行为,这是任何预测都无法替代的。本实验仅涉及让AI提前猜测胜者。对于真实测试,更难的问题是:你看到的差异是否大于频道每次上传的正常波动。