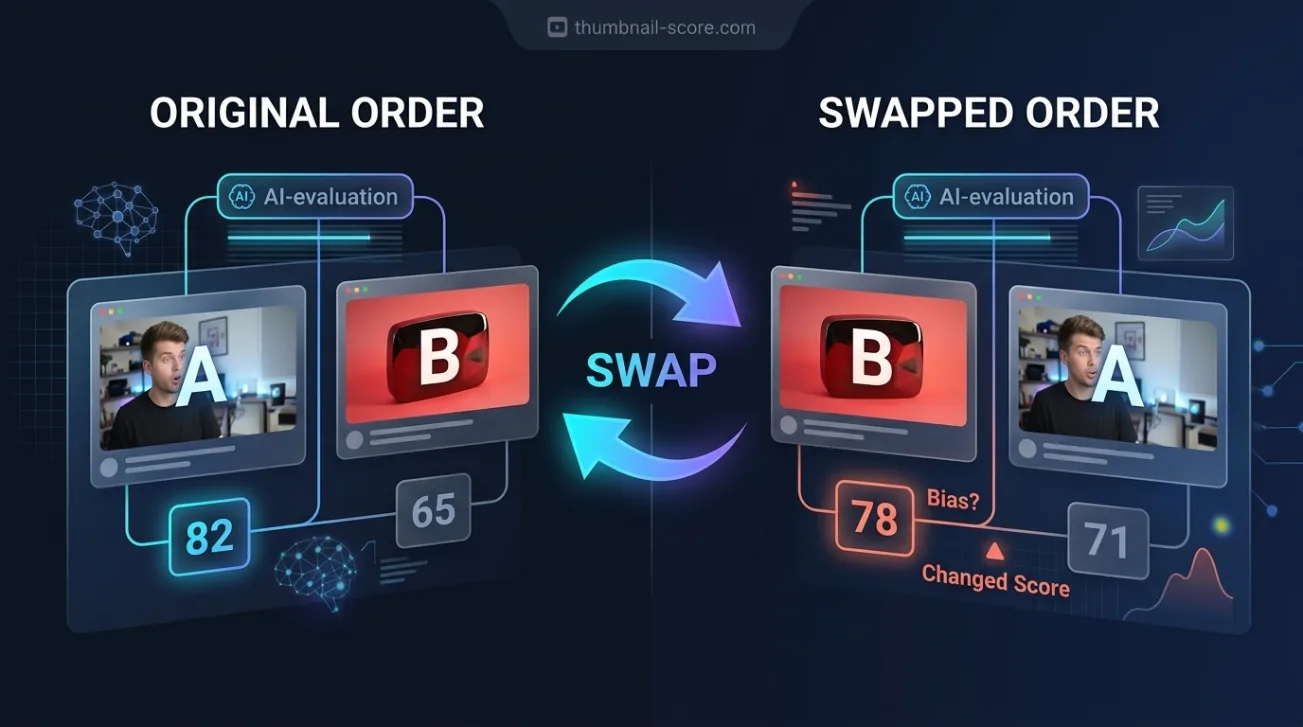
अगर आपने कभी दो थंबनेल AI चैट में पेस्ट किए और पूछा कि कौन सा अधिक क्लिक पाएगा, तो आपने बिना किसी नियंत्रण के एक प्रयोग किया। हमने एक नियंत्रण के साथ इसे किया: 161 वास्तविक वीडियो जोड़ियाँ जहाँ हम पहले से जानते थे कि कौन सा बेहतर प्रदर्शन करता है, प्रत्येक जोड़ी को AI को दो बार दिखाया गया, एक बार प्रत्येक क्रम में। जिस थंबनेल को यह पहले देखता था, वह इसके उत्तरों का एक बड़ा हिस्सा तय करता था।
मुख्य बिंदु
- एक ही चैनल के दो थंबनेल दिखाए जाने पर, AI ने 64.7% बार जो पहले आया उसे चुना। बिना स्थान पसंद के एक निर्णायक 50% के पास होता।
- जब वास्तविक विजेता पहले दिखाया गया, तो AI 77.3% बार सही था। जब वही विजेता दूसरे स्थान पर दिखाया गया, तो 48.0%।
- दोनों क्रमों के औसत से यह 62.7% बार सही था, जो प्रत्येक थंबनेल को अलग-अलग रेट करने वाले स्कोर से बिल्कुल मेल खाता है। साइड-बाय-साइड तुलना ने कोई सटीकता नहीं जोड़ी।
- 30.7% जोड़ियों पर, जब केवल क्रम बदला गया, तो इसने विपरीत उत्तर दिए।
- यह लगभग कभी संदेह नहीं जताता: एक आम उत्तर ने 85% आत्मविश्वास का दावा किया जबकि मॉडल लगभग 63% बार सही था।
क्या AI आपको बता सकता है कि दो थंबनेलों में से कौन सा बेहतर प्रदर्शन करेगा?
कभी-कभी, लेकिन एकल उत्तर से आप उस पर भरोसा नहीं कर सकते। दोनों क्रमों के औसत से, हमने जिस मॉडल का परीक्षण किया, वह 62.7% बार बेहतर प्रदर्शन करने वाला थंबनेल चुनता था — ठीक उतनी बार जितनी बार हमारा स्कोर प्रत्येक थंबनेल को अलग-अलग रेट करके प्रबंधित करता था। लेकिन इसका चयन इस पर निर्भर करता था कि यह कौन सी छवि पहले देखता था: 77.3% सही जब विजेता पहले आया, 48.0% जब वह दूसरे आया।
सरल शब्दों में, एकल उत्तर एक सिक्के की तरह व्यवहार करता है जो अक्सर पहले विकल्प पर गिरता है। जानकारी वहाँ है — जब मॉडल दोनों तरफ से एक ही उत्तर देता है, तो वह मौके से अधिक बार सही होता है — लेकिन आप इसे केवल दो बार पूछकर पाते हैं।
हमने इसका परीक्षण कैसे किया: ज्ञात उत्तर वाले वास्तविक जोड़े, दोनों तरह से दिखाए गए
जोड़ियाँ हमारे प्रकाशित परीक्षण से आईं: एक ही चैनल के दो वीडियो, जो एक दूसरे के करीब प्रकाशित किए गए, एक जो चैनल के अपने हाल के औसत से स्पष्ट रूप से बेहतर था और एक जो स्पष्ट रूप से पीछे रहा। एक ही चैनल का उपयोग करने से सदस्य संख्या, दर्शक और उत्पादन बजट रद्द हो जाते हैं, इसलिए दोनों के बीच अंतर मुख्य रूप से पैकेजिंग है।
हमने अध्ययन के चैनलों के आधे से 161 जोड़ियाँ लीं और बाकी आधे को अपरिवर्तित रखा। AI — वही दृष्टि मॉडल जो हमारे स्कोर को चलाता है — को दोनों थंबनेल उनके वास्तविक शीर्षकों के साथ दिखाए गए, और बताया गया कि एक ने चैनल के सामान्य दृश्यों से अधिक प्रदर्शन किया और एक ने कम, और पूछा गया कि कौन सा कौन है। 322 उत्तरों में से 11 अप्रयोज्य आए, जिससे 150 जोड़ियाँ दोनों क्रमों में उत्तर दिए गए।
क्यों प्रत्येक जोड़ी को दो बार दिखाना जरूरी था
दो विकल्पों की तुलना करने वाला AI सामग्री के बिना एक स्थान को पसंद कर सकता है, जैसे कुछ लोग सूची के पहले आइटम को पसंद करते हैं। अगर ऐसी पसंद है और आप हर जोड़ी को केवल एक तरह से दिखाते हैं, तो आप इसे कौशल से अलग नहीं कर सकते: एक निर्णायक जो हमेशा पहली छवि चुनता है, उसे तब बुद्धिमान लगता है जब बेहतर थंबनेल पहले सूचीबद्ध होता है।
हर जोड़ी को दो बार, क्रम बदलकर, दिखाने से दोनों को अलग किया जा सकता है। कौशल स्वैप से बचेगा। स्थान की पसंद उसके साथ उलट जाएगी।
पहले दिखाया गया थंबनेल अधिकांश बहसों में जीता
300 उत्तरों में, AI ने 64.7% बार जो थंबनेल उसे पहले दिखाया गया उसे चुना। यह पसंद किसी भी एकल उत्तर के मूल्य को बदल देती है:
| जोड़ी को कैसे दिखाया गया | AI ने कितनी बार वास्तविक विजेता को चुना |
|---|---|
| विजेता पहले दिखाया गया | 77.3% |
| विजेता दूसरे दिखाया गया | 48.0% |
| दोनों क्रमों का औसत | 62.7% |
| हमारा स्कोर, प्रत्येक थंबनेल को अलग-अलग रेट करके | 62.7% |
| दोनों क्रमों में एक ही सही उत्तर | 47.3% (यादृच्छिक अनुमान: लगभग 25%) |
औसत पंक्ति एक ऐसे स्कोर की निष्पक्ष तुलना है जो प्रत्येक थंबनेल को अपने आप में रेट करता है, क्योंकि दोनों प्रत्येक जोड़ी के लिए एक उत्तर देते हैं। उस आधार पर दोनों विधियाँ 62.7% पर बराबर थीं। साइड-बाय-साइड तुलना ने सटीकता नहीं जोड़ी; इसने क्रम पर निर्भरता जोड़ी।
अंतिम पंक्ति सख्त परीक्षण है: एक उत्तर केवल तभी गिना जाता है जब AI ने दोनों बार एक ही, सही थंबनेल चुना। यादृच्छिक अनुमान लगाने वाला निर्णायक इसे लगभग एक चौथाई बार पास करता, और जो हमेशा पहली छवि चुनता है वह कभी नहीं पास करता। AI ने 47.3% जोड़ियों पर पास किया, इसलिए संकेत वास्तविक है — यह केवल स्थान के साथ उलझा हुआ है।
यह लगभग एक तिहाई जोड़ियों पर अपना मन बदल गया
150 जोड़ियों में से 46 पर, 30.7%, AI ने केवल क्रम के आधार पर विपरीत उत्तर दिए। दोनों प्रश्नों के बीच दोनों थंबनेल या शीर्षकों में कोई बदलाव नहीं हुआ।
बाकी 104 जोड़ियों पर यह स्थिर था, और उन पर यह 68.3% बार सही था। हमारा स्कोर, उन्हीं 104 जोड़ियों पर, 63.5% बार सही था। यह अंतर इतना छोटा है कि इतनी जोड़ियों के साथ यह सुनिश्चित नहीं है, लेकिन यह कहीं उपयोगी ओर इशारा करता है: स्वैप से बचा उत्तर उस उत्तर से अधिक मूल्यवान है जिसका कभी परीक्षण नहीं किया गया।
इसकी आत्मविश्वास संख्या एक प्रायिकता नहीं है
हमने हर उत्तर के साथ एक आत्मविश्वास आंकड़ा मांगा और AI को बताया कि 50 का मतलब सिक्का उछालना है। इसने पैमाने के निचले आधे हिस्से का बहुत कम उपयोग किया। इसका सबसे निम्न घोषित आत्मविश्वास सभी 300 उत्तरों में 65 था, एक आम उत्तर ने 85 का दावा किया, और केवल 4 उत्तर 70 से नीचे आए।
इस बीच यह लगभग 63% बार सही था। जिन उत्तरों को इसने 80 से 89 के बीच रेट किया, वे 61.6% बार सही थे; जिन्हें 70 से 79 के बीच रेट किया, वे 63.5% बार सही थे। उस श्रेणी में जहाँ लगभग सभी उत्तर आते थे, संख्या आपको यह नहीं बताती कि कौन से उत्तरों पर विश्वास करें।
इसने 90 या उससे ऊपर रेट किए 17 उत्तर 82.4% बार सही थे, जो सुझाव देता है, लेकिन 17 बहुत कम हैं ताकि उन पर भरोसा किया जा सके। व्यावहारिक पठन सरल है: AI तुलना से आत्मविश्वास भरा लहजा इसका डिफ़ॉल्ट रजिस्टर है, सबूत नहीं।
पांच मिनट में किसी भी AI थंबनेल निर्णायक की जांच कैसे करें
हमने एक मॉडल का परीक्षण किया, और अन्य उपकरण अलग तरह से व्यवहार कर सकते हैं। आपको हमारे शब्दों पर भरोसा करने की आवश्यकता नहीं है, क्योंकि यह जांच खुद करने के लिए तेज है:
- दो थंबनेल चुनें जहाँ आप पहले से उत्तर जानते हैं: अपने चैनल के दो पिछले वीडियो, जो एक दूसरे के करीब प्रकाशित किए गए, एक स्पष्ट रूप से आपके सामान्य दृश्यों से ऊपर और एक स्पष्ट रूप से नीचे।
- AI से पूछें कि कौन सा बेहतर प्रदर्शन करता है, मजबूत वाला पहले दिखाकर। उसके उत्तर और कोई आत्मविश्वास नोट करें।
- एक नई बातचीत शुरू करें, ताकि यह अपना पहला उत्तर याद न रख सके, और फिर से पूछें लेकिन क्रम उलटकर।
- कम से कम दस जोड़ियों के साथ दोहराएं। गिनें कि यह कितनी बार जो छवि पहले आती है उसे चुनता है, और कितनी बार उसका उत्तर स्वैप से बचता है।
- केवल उन उत्तरों पर भरोसा करें जो स्वैप से बचते हैं, और आत्मविश्वास आंकड़े को पूरी तरह नजरअंदाज करें।
अगर आप एक ऐसी संख्या चाहते हैं जो प्रस्तुति क्रम पर बिल्कुल निर्भर न हो, तो आप प्रत्येक थंबनेल और शीर्षक को अलग-अलग स्कोर कर सकते हैं। प्रत्येक विकल्प के लिए अलग स्कोर, बाद में तुलना करके, कोई पहला स्थान पसंद नहीं करता।
यह प्रयोग क्या नहीं दिखाता
इसने एक मॉडल का परीक्षण एक सेट निर्देशों के साथ किया। एक अलग मॉडल, या उसी मॉडल को अलग तरह से पूछा जाना, पहले स्थान को अधिक या कम मजबूती से पसंद कर सकता है। बिंदु यह नहीं है कि हर AI इस तरह व्यवहार करता है; यह है कि एकल तुलना आपको नहीं बता सकती कि जिसे आप उपयोग कर रहे हैं वह ऐसा करता है या नहीं।
जोड़ियाँ चुनी गईं क्योंकि उनका प्रदर्शन तीव्र रूप से अलग था, इसलिए ये सटीकता आंकड़े स्पष्ट हिट्स के खिलाफ स्पष्ट मिस का वर्णन करते हैं, न कि दो थंबनेल जो लगभग समान प्रदर्शन करते थे। हर चैनल स्थापित और अंग्रेजी भाषा का था।
और यह सभी वास्तविक स्प्लिट टेस्टिंग के बारे में नहीं है। वास्तविक दर्शकों पर चलाया गया परीक्षण उन दर्शकों द्वारा वास्तव में किए गए कार्यों को मापता है। यह प्रयोग केवल एक AI के बारे में है जो उस परिणाम का पूर्वानुमान लगाने की कोशिश कर रहा है।
अक्सर पूछे जाने वाले प्रश्न
क्या AI चैटबॉट यूट्यूब थंबनेल चुन सकता है?
आंशिक रूप से। हमने जिस मॉडल का परीक्षण किया, वह औसतन लगभग 63% बार बेहतर प्रदर्शन करने वाला थंबनेल चुनता था, जो मौके से बेहतर है लेकिन प्रत्येक थंबनेल को अलग-अलग स्कोर करने से बेहतर नहीं है। इसका उत्तर उस छवि पर भारी निर्भर करता था जिसे यह पहले देखता था, इसलिए एकल उत्तर अविश्वसनीय है। दो बार पूछें, क्रम उलटकर, और केवल उन उत्तरों पर भरोसा करें जो स्वैप से बचते हैं।
AI तुलनाओं में स्थिति पूर्वाग्रह क्या है?
स्थिति पूर्वाग्रह एक विकल्प को उसके अंदर के बजाय जहाँ यह दिखाई देता है उसके कारण पसंद करने की प्रवृत्ति है। हमारे परीक्षण में, AI ने 64.7% बार जो थंबनेल उसे पहले दिखाया गया उसे चुना। इसका उपाय है हर तुलना दोनों क्रमों में प्रस्तुत करना और एक उत्तर जो उलट जाता है उसे बिल्कुल कोई उत्तर न मानना।
थंबनेल को अलग-अलग रेट करना बेहतर है या उन्हें साइड-बाय-साइड तुलना करना?
हमारे परीक्षण में दोनों औसतन 62.7% सटीकता के साथ बराबर थे। अंतर स्थिरता में था। प्रत्येक थंबनेल को अपने आप में रेट करने से जो क्रम में भी आप उन्हें जांचें, वही परिणाम मिलता है, जबकि साइड-बाय-साइड तुलना ने लगभग एक तिहाई जोड़ियों पर क्रम के साथ बदलने वाले उत्तर उत्पन्न किए।
AI अपने उत्तर के बारे में इतना यकीन क्यों लगता है?
क्योंकि आत्मविश्वास भरी भाषा इसका डिफ़ॉल्ट है, माप नहीं। अपनी निश्चितता का मूल्यांकन करने के लिए कहे जाने पर, हमने जिस मॉडल का परीक्षण किया, वह लगभग कभी 100 में से 70 से नीचे नहीं गया और आमतौर पर 85 का दावा किया, जबकि यह लगभग 63% बार सही था। उस श्रेणी में, उच्च घोषित आत्मविश्वास का मतलब अधिक विश्वसनीय उत्तर नहीं था।
क्या इसका मतलब है कि थंबनेल A/B टेस्टिंग बेकार है?
नहीं। एक वास्तविक परीक्षण आपके थंबनेल को वास्तविक दर्शकों को दिखाता है और वे क्या करते हैं उसे मापता है, जिसे कोई भविष्यवाणी प्रतिस्थापित नहीं कर सकती। यह प्रयोग केवल AI से पहले विजेता का अनुमान लगाने के बारे में है। एक वास्तविक परीक्षण के लिए, कठिन सवाल यह है कि क्या आप जो अंतर देखते हैं वह आपके चैनल के एक अपलोड से दूसरे तक सामान्य भिन्नता से बड़ा है।