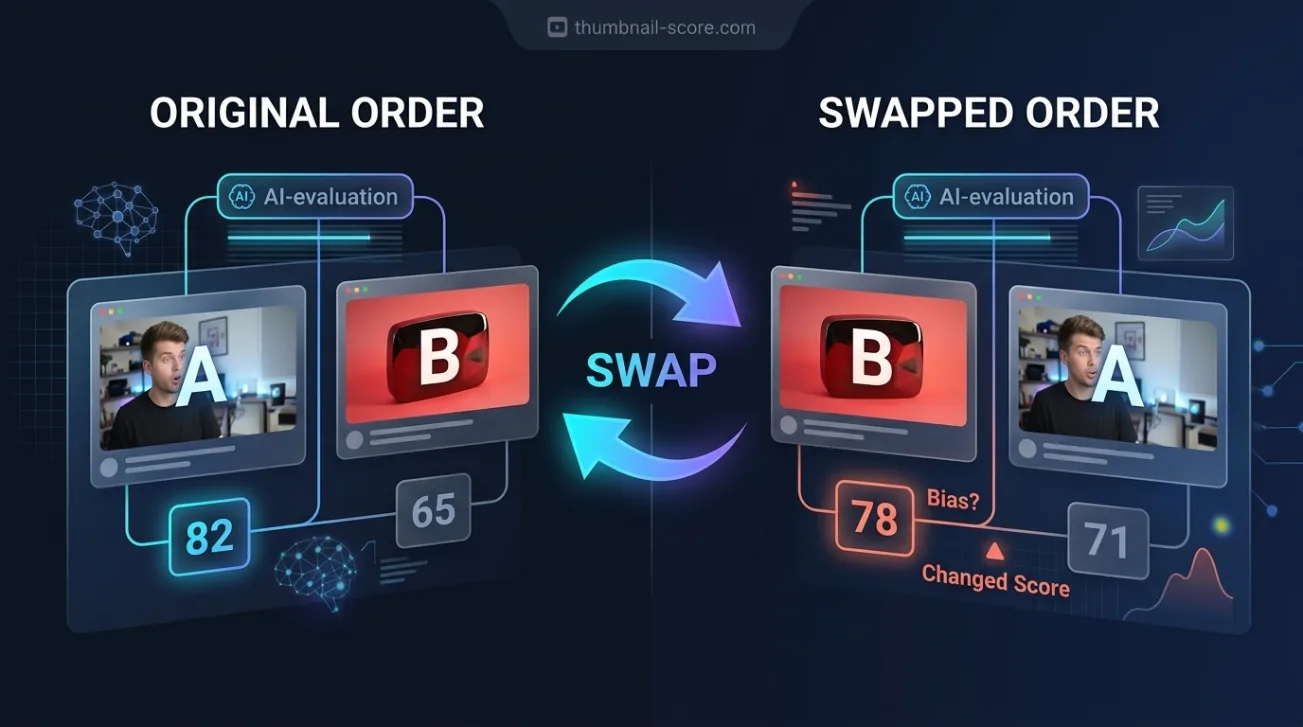
당신이 두 개의 썸네일을 AI 채팅에 붙여넣고 어떤 것이 더 많은 클릭을 얻을지 물어본 적이 있다면, 당신은 통제 없이 실험을 한 셈입니다. 우리는 통제된 실험을 했습니다: 이미 어느 쪽이 더 잘 작동했는지 알고 있는 161쌍의 실제 영상 쌍을 AI에게 각각 두 번씩, 순서를 바꿔가며 보여주었습니다. AI가 처음 본 썸네일이 그 답변의 상당 부분을 결정했습니다.
핵심 요약
- 같은 채널의 두 썸네일을 보여줬을 때, AI는 첫 번째로 보인 썸네일을 64.7%의 확률로 선택했습니다. 위치에 대한 선호가 없는 판정자는 50% 근처에 있을 것입니다.
- 실제 승자가 첫 번째로 보여졌을 때, AI는 77.3%의 확률로 맞혔습니다. 같은 승자가 두 번째로 보여졌을 때는 48.0%였습니다.
- 두 순서를 평균하면 62.7%의 확률로 맞혔고, 이는 각 썸네일을 개별적으로 평가하는 점수와 정확히 일치합니다. 옆에 나란히 비교하는 것은 정확도를 높이지 않았습니다.
- 순서만 바뀌었을 뿐인데 반대 답변을 한 경우는 30.7%였습니다.
- AI는 거의 의심을 인정하지 않았습니다: 일반적인 답변은 85%의 확신을 주장했지만, 모델은 약 63%의 확률로 맞혔습니다.
AI는 두 썸네일 중 어느 쪽이 더 잘 작동할지 말해줄 수 있을까요?
때때로 그렇습니다. 하지만 단일 답변으로는 신뢰할 수 없습니다. 두 순서를 평균하면, 우리가 테스트한 모델은 62.7%의 확률로 더 잘 작동하는 썸네일을 골랐습니다 — 각 썸네일을 개별적으로 평가한 점수와 정확히 같은 빈도입니다. 그러나 그 선택은 어떤 이미지를 먼저 보았는지에 따라 달라졌습니다: 승자가 먼저 보였을 때는 77.3%, 두 번째로 보였을 때는 48.0%였습니다.
간단히 말해, 단일 답변은 첫 번째 선택지를 더 자주 선택하는 동전처럼 행동합니다. 정보는 거기에 있지만 — 모델이 양쪽 순서에서 같은 답변을 줄 때는 우연보다 더 자주 맞춥니다 — 당신은 두 번 질문해야 그 정보를 찾을 수 있습니다.
우리가 어떻게 테스트했는지: 알려진 정답을 가진 실제 쌍, 양쪽 순서로 보여줌
쌍들은 우리가 발표한 점수 테스트에서 나왔습니다: 같은 채널에서 가까운 시기에 게시된 두 영상으로, 하나는 채널의 최근 평균보다 분명히 잘했고, 다른 하나는 분명히 못했습니다. 같은 채널을 사용함으로써 구독자 수, 시청자층, 제작 예산은 상쇄되므로, 두 영상의 차이는 대부분 포장(썸네일과 제목)에 있습니다.
우리는 연구의 채널 절반에서 나온 161쌍을 사용하고 나머지 절반은 그대로 두었습니다. AI — 우리 점수를 구동하는 동일한 시각 모델 — 에게 실제 제목과 함께 두 썸네일을 보여주고, 하나는 채널의 평균 조회수를 넘었고 하나는 못 넘었다고 알려주며, 어느 쪽인지 물었습니다. 322개 답변 중 11개는 사용할 수 없었고, 이로 인해 150쌍이 양쪽 순서로 답변을 받았습니다.
왜 모든 쌍을 두 번 보여줘야 했는지
두 옵션을 비교하는 AI는 내용과 무관하게 특정 위치를 선호할 수 있습니다. 마치 어떤 사람들은 목록의 첫 번째 항목을 선호하는 것처럼요. 그런 선호가 존재하고, 각 쌍을 한 번만 한 방향으로만 보여준다면, 그것을 능력과 구분할 수 없습니다: 항상 첫 번째 이미지를 고르는 판정자는 더 나은 썸네일이 첫 번째로 나열될 때마다 뛰어나 보일 것입니다.
모든 쌍을 두 번, 순서를 바꿔가며 보여주면 이 둘을 분리할 수 있습니다. 능력은 순서를 바꿔도 유지되어야 합니다. 위치 선호는 순서와 함께 뒤집혀야 합니다.
먼저 보여진 썸네일이 대부분의 논쟁에서 이겼습니다
300개의 답변 전체에서, AI는 먼저 보여진 썸네일을 64.7%의 확률로 골랐습니다. 이 선호는 단일 답변의 가치를 바꿉니다:
| 쌍을 보여준 방식 | AI가 실제 승자를 고른 빈도 |
|---|---|
| 승자 먼저 보여줌 | 77.3% |
| 승자 두 번째 보여줌 | 48.0% |
| 두 순서 평균 | 62.7% |
| 각 썸네일을 개별적으로 평가한 우리 점수 | 62.7% |
| 두 순서 모두에서 같은 정답을 선택함 | 47.3% (무작위 추정: 약 25%) |
평균 행은 각 썸네일을 개별적으로 평가하는 점수와 공정하게 비교할 수 있습니다. 왜냐하면 둘 다 쌍당 하나의 답변을 주기 때문입니다. 이 기준에서 두 방법은 62.7%로 동률이었습니다. 옆에 나란히 비교하는 것은 정확도를 높이지 않았고, 순서에 대한 의존성을 추가했습니다.
마지막 행은 더 엄격한 테스트입니다: AI가 두 번 모두 같은 정답 썸네일을 골랐을 때만 정답으로 간주합니다. 무작위로 추정하는 판정자는 약 4분의 1의 확률로 통과할 것이고, 항상 첫 번째 이미지를 고르는 판정자는 절대 통과하지 못할 것입니다. AI는 47.3%의 쌍에서 통과했으므로, 신호는 실제 존재하지만 위치와 얽혀 있습니다.
거의 3분의 1의 쌍에서 생각을 바꿨습니다
150쌍 중 46쌍(30.7%)에서, AI는 순서만 바뀌었을 뿐인데 반대 답변을 했습니다. 두 질문 사이에 썸네일이나 제목의 내용은 전혀 바뀌지 않았습니다.
나머지 104쌍에서는 일관성을 유지했고, 그 중 68.3%의 확률로 맞혔습니다. 우리 점수는 같은 104쌍에서 63.5%의 확률로 맞혔습니다. 이 차이는 이 정도의 쌍 수로는 확신할 수 없지만, 유용한 방향을 제시합니다: 순서를 바꿔도 살아남는 답변은 테스트되지 않은 답변보다 가치가 더 큽니다.
그것의 확신 수치는 확률이 아닙니다
우리는 모든 답변에 대해 확신 수치를 요청했고, AI에게 50은 동전 던지기와 같다고 말했습니다. AI는 스케일의 하반부를 거의 사용하지 않았습니다. 300개 답변 전체에서 가장 낮은 선언된 확신은 65였고, 일반적인 답변은 85를 주장했으며, 70 미만인 답변은 단 4개였습니다.
한편, AI는 약 63%의 확률로 맞혔습니다. 80~89 사이로 평가된 답변은 61.6%의 확률로 맞았고, 70~79 사이로 평가된 답변은 63.5%의 확률로 맞았습니다. 거의 모든 답변이 속한 범위에서 그 숫자는 어떤 답변을 믿어야 할지 알려주지 않았습니다.
90 이상으로 평가된 17개의 답변은 82.4%의 확률로 맞았고, 이는 시사하는 바가 있지만, 17개는 신뢰하기에는 너무 적습니다. 실용적인 해석은 간단합니다: AI 비교에서 자신감 있는 어조는 기본 설정이며 증거가 아닙니다.
5분 안에 어떤 AI 썸네일 판정자라도 확인하는 방법
우리는 한 모델을 테스트했고, 다른 도구는 다르게 작동할 수 있습니다. 당신은 우리 말을 그대로 믿을 필요도 없고, 직접 빠르게 확인할 수 있습니다:
- 이미 정답을 알고 있는 두 썸네일을 고르세요: 당신 채널의 과거 영상 두 개로, 가까운 시기에 게시되었고, 하나는 평소 조회수보다 분명히 높고, 다른 하나는 분명히 낮은 것.
- 더 강한 썸네일을 먼저 보여주며 AI에게 어느 쪽이 더 잘 작동했는지 물어보세요. 답변과 주어진 확신을 메모하세요.
- 새로운 대화를 시작하여 첫 번째 답변을 기억하지 못하게 하고, 순서를 바꿔서 다시 물어보세요.
- 적어도 10쌍으로 반복하세요. 먼저 보인 이미지를 고른 빈도와 순서를 바꿔도 답변이 살아남는 빈도를 세세요.
- 순서를 바꿔도 살아남는 답변만 믿고, 확신 수치는 완전히 무시하세요.
표현 순서에 전혀 의존하지 않는 숫자를 원한다면, 각 썸네일과 제목을 개별적으로 점수 매기기를 할 수 있습니다. 각 옵션에 대한 별도 점수를 나중에 비교하면, 선호할 첫 번째 위치가 없습니다.
이 실험이 보여주지 않는 것
이 실험은 한 모델과 한 세트의 지시사항으로 수행되었습니다. 다른 모델이나 동일한 모델에 다른 방식으로 질문하면, 첫 번째 위치를 더 강하게 또는 덜 선호할 수 있습니다. 핵심은 모든 AI가 이렇게 행동한다는 것이 아니라, 당신이 사용하는 AI가 그렇かどうか는 단일 비교로는 알 수 없다는 점입니다.
쌍들은 성과가 뚜렷하게 다른 경우를 선택했으므로, 이 정확도 수치는 뚜렷한 성공과 실패를 비교한 것이지, 거의 동일하게 작동한 두 썸네일을 비교한 것은 아닙니다. 모든 채널은 설립된 영어권 채널이었습니다.
또한 이 실험은 실제 A/B 테스트와는 무관합니다. 실제 시청자를 대상으로 한 테스트는 그 시청자들이 실제로 무엇을 했는지를 측정합니다. 이 실험은 AI가 그 결과를 미리 예측하려는 시도에만 관련됩니다.
자주 묻는 질문
AI 챗봇이 최고의 유튜브 썸네일을 고를 수 있나요?
일부는 그렇습니다. 우리가 테스트한 모델은 평균적으로 63%의 확률로 더 잘 작동하는 썸네일을 골랐고, 이는 우연보다는 낫지만, 각 썸네일을 개별적으로 점수 매기는 것보다 나은 것이 아닙니다. 그 답변은 어떤 이미지를 먼저 보았는지에 크게 의존하므로, 단일 답변은 신뢰할 수 없습니다. 순서를 바꿔 두 번 질문하고, 순서를 바꿔도 살아남는 답변만 믿으세요.
AI 비교에서의 위치 편향이란 무엇인가요?
위치 편향은 내용이 아니라 위치 때문에 특정 옵션을 선호하는 경향입니다. 우리의 테스트에서 AI는 먼저 보여진 썸네일을 64.7%의 확률로 선택했습니다. 해결책은 모든 비교를 양쪽 순서로 제시하고, 순서가 바뀌면 답변도 바뀌는 경우를 답변이 없는 것으로 간주하는 것입니다.
썸네일을 개별적으로 평가하는 것과 옆에 나란히 비교하는 것 중 어느 쪽이 더 나은가요?
우리 테스트에서는 두 방법 모두 평균적으로 62.7%의 정확도를 보였습니다. 차이는 안정성에 있습니다. 각 썸네일을 개별적으로 평가하면 어떤 순서로 확인하든 같은 결과를 얻지만, 옆에 나란히 비교하면 거의 3분의 1의 쌍에서 순서에 따라 답변이 바뀌었습니다.
왜 AI는 답변에 대해 그렇게 확신하는 것처럼 말하나요?
왜냐하면 자신감 있는 표현이 기본 설정이기 때문입니다. 자신의 확신을 평가하라고 요청했을 때, 우리가 테스트한 모델은 거의 100점 중 70점 이하로 내리지 않았고, 일반적으로 85점을 주장했지만, 실제로는 약 63%의 확률로 맞혔습니다. 그 범위 내에서는 더 높은 선언된 확신이 더 신뢰할 수 있는 답변을 의미하지 않았습니다.
이것은 썸네일 A/B 테스트가 무의미하다는 뜻인가요?
아니요. 실제 테스트는 실제 시청자에게 썸네일을 보여주고 그들이 실제로 무엇을 하는지를 측정합니다. 이는 어떤 예측도 대체할 수 없습니다. 이 실험은 AI에게 미리 승자를 맞추게 하는 것에만 관련됩니다. 실제 테스트에서는, 당신이 보는 차이가 채널의 일반적인 변동보다 큰지 여부가 더 어려운 질문입니다.