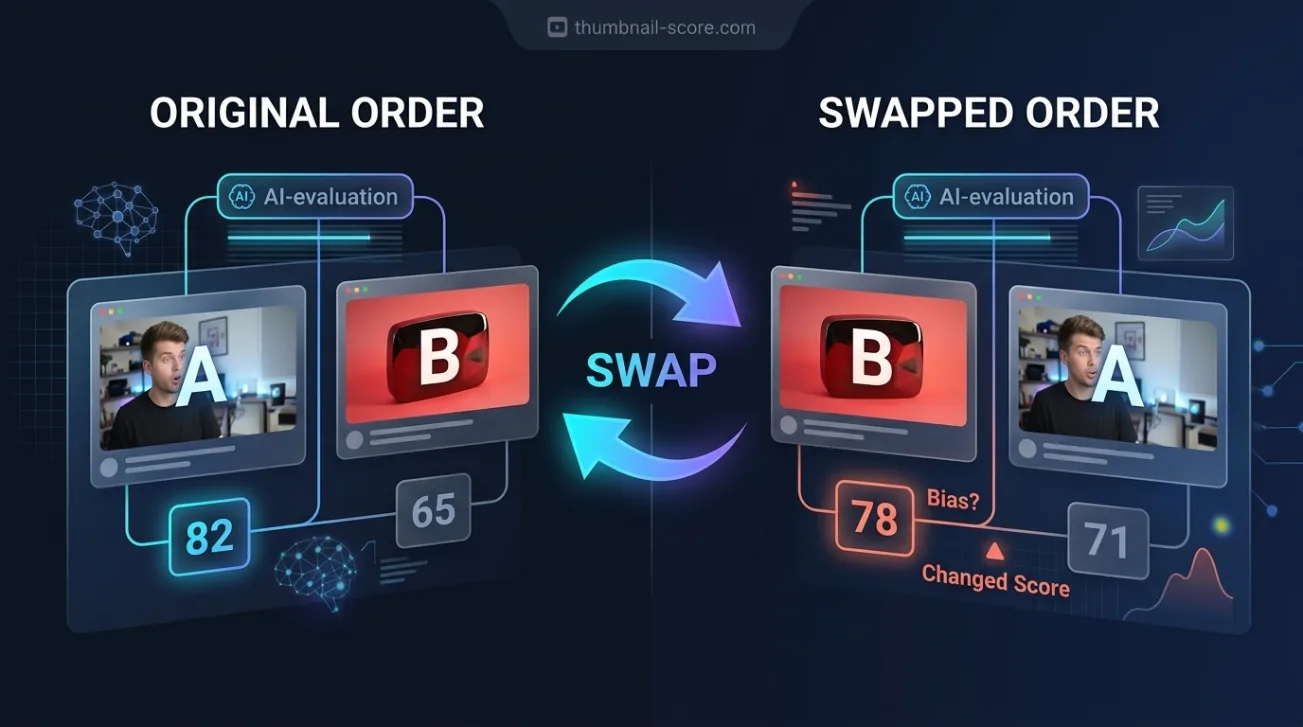
Если вы когда-либо вставляли две миниатюры в чат с ИИ и спрашивали, какая получит больше кликов, вы провели эксперимент без контроля. Мы провели его с контролем: 161 пара реальных видео, где мы уже знали, какая работала лучше, каждая пара показывалась ИИ дважды — в каждом порядке. Оказалось, что первая миниатюра, которую видел ИИ, определяла большую часть его ответов.
Ключевые выводы
- Показав две миниатюры из одного канала, ИИ выбирал ту, что шла первой, в 64,7% случаев. Судья без предпочтения по позиции сидел бы около 50%.
- Когда реальный победитель случайно показывался первым, ИИ был прав в 77,3% случаев. Когда тот же победитель показывался вторым — в 48,0%.
- В среднем по обоим порядкам он был прав в 62,7% случаев — точно совпадая с оценкой, которая оценивает каждую миниатюру отдельно. Сравнение рядом не добавило точности.
- Он давал противоположные ответы, когда менялся только порядок, в 30,7% пар.
- Он почти никогда не признавал сомнения: типичный ответ заявлял 85% уверенности, хотя модель была права примерно в 63% случаев.
Может ли ИИ сказать, какая из двух миниатюр будет работать лучше?
Иногда, но не так, чтобы вы могли доверять одному ответу. В среднем по обоим порядкам протестированная нами модель выбирала лучшую миниатюру в 62,7% случаев — ровно так же часто, как наша оценка, оценивающая каждую миниатюру отдельно. Но её выбор зависел от того, какое изображение она видела первым: 77,3% правильных ответов, когда победитель шёл первым, и 48,0%, когда вторым.
Проще говоря, один ответ ведёт себя как монетка, которая чаще выпадает на первый вариант. Информация там есть — когда модель даёт один и тот же ответ в обоих направлениях, она чаще права, чем случай — но вы узнаёте это, только спросив дважды.
Как мы тестировали: реальные пары с известным ответом, показанные в обоих порядках
Пары взяты из нашего опубликованного теста оценки: два видео с одного канала, опубликованные близко друг к другу, одно явно превзошло недавний средний показатель канала, а другое — явно уступило. Использование одного канала нивелирует количество подписчиков, аудиторию и бюджет производства, так что различие между ними в основном в упаковке.
Мы использовали 161 пару из половины каналов исследования, оставив другую половину нетронутой. ИИ — та же модель компьютерного зрения, что и в нашей оценке — видел обе миниатюры с реальными заголовками, ему сообщали, что одна превзошла обычное количество просмотров канала, а другая — уступила, и спрашивали, какая есть какая. Из 322 ответов 11 вернулись непригодными, осталось 150 пар, ответы на которые получены в обоих порядках.
Почему каждую пару нужно было показывать дважды
ИИ, сравнивающий два варианта, может предпочитать одну позицию независимо от содержания, как некоторые люди предпочитают первый пункт в списке. Если такое предпочтение существует, и вы всегда показываете каждую пару только в одном порядке, вы не можете отличить его от навыка: судья, который всегда выбирает первое изображение, выглядит гениальным, когда лучшая миниатюра случайно оказывается первой.
Показывая каждую пару дважды, с изменённым порядком, мы разделяем эти два эффекта. Навык должен сохраняться при смене порядка. Предпочтение позиции должно меняться вместе с ним.
Первой показанная миниатюра выигрывала большинство споров
В 300 ответах ИИ выбирал ту миниатюру, которую видел первой, в 64,7% случаев. Это предпочтение меняет ценность любого одного ответа:
| Как показывалась пара | Как часто ИИ выбирал реального победителя |
|---|---|
| Победитель показан первым | 77,3% |
| Победитель показан вторым | 48,0% |
| Среднее по обоим порядкам | 62,7% |
| Наша оценка, оценивающая каждую миниатюру отдельно | 62,7% |
| Один и тот же правильный ответ в обоих порядках | 47,3% (случайное угадывание: около 25%) |
Строка «среднее» — это честное сравнение с оценкой, которая оценивает каждую миниатюру отдельно, потому что оба дают один ответ на пару. На этом основании оба метода совпали на 62,7%. Сравнение рядом не добавило точности; оно добавило зависимость от порядка.
Последняя строка — более строгий тест: ответ засчитывается только если ИИ выбрал одну и ту же, правильную миниатюру оба раза. Судья, угадывающий наугад, прошёл бы его примерно в четверти случаев, а тот, кто всегда выбирает первое изображение, никогда бы не прошёл. ИИ прошёл в 47,3% пар, так что сигнал реальный — просто он переплетён с позицией.
Он менял мнение почти в трети пар
В 46 из 150 пар, то есть в 30,7%, ИИ давал противоположные ответы, зависящие только от порядка. Ничто в самих миниатюрах или заголовках не менялось между двумя вопросами.
В остальных 104 парах он был последователен, и в них он был прав в 68,3% случаев. Наша оценка на тех же 104 парах была правильной в 63,5% случаев. Эта разница слишком мала, чтобы быть уверенной при таком количестве пар, но она указывает на что-то полезное: ответ, который выдерживает смену порядка, стоит больше, чем тот, который никогда не проверялся.
Его число уверенности — не вероятность
Мы просили указывать уровень уверенности с каждым ответом и сообщили ИИ, что 50 означает подбрасывание монетки. Он почти не использовал нижнюю половину шкалы. Его самый низкий заявленный уровень уверенности среди всех 300 ответов был 65, типичный ответ заявлял 85, и только 4 ответа были ниже 70.
Между тем он был прав примерно в 63% случаев. Ответы, которые он оценил между 80 и 89, были правильными в 61,6% случаев; ответы, оценённые между 70 и 79 — в 63,5% случаев. В диапазоне, где почти все его ответы, число ничего не говорило о том, какие ответы стоит принимать.
17 ответов, которые он оценил 90 или выше, были правильными в 82,4% случаев — это наводит на мысль, но 17 — слишком мало, чтобы на это полагаться. Практический вывод прост: уверенный тон от ИИ — это его стандартный режим, а не доказательство.
Как проверить любого ИИ-судью миниатюр за пять минут
Мы протестировали одну модель, и другие инструменты могут вести себя иначе. Вам не нужно принимать нашу точку зрения на веру, потому что проверка быстро выполняется самостоятельно:
- Выберите две миниатюры, где вы уже знаете ответ: два прошлых видео с вашего канала, опубликованные близко друг к другу, одно явно выше обычного числа просмотров, а другое — явно ниже.
- Спросите ИИ, какое работало лучше, показав сильное первым. Запишите его ответ и любую уверенность, которую он даёт.
- Начните новую беседу, чтобы он не помнил свой первый ответ, и спросите снова, поменяв порядок.
- Повторите с как минимум десятью парами. Посчитайте, как часто он выбирает ту миниатюру, что идёт первой, и как часто его ответ выживает при смене порядка.
- Доверяйте только тем ответам, которые выживают при смене порядка, и полностью игнорируйте число уверенности.
Если вы предпочитаете число, которое вообще не зависит от порядка показа, вы можете оценить каждую миниатюру и заголовок отдельно. Отдельная оценка для каждого варианта, сравниваемая потом, не имеет первой позиции, которую можно предпочесть.
Что этот эксперимент не показывает
Он тестировал одну модель с одним набором инструкций. Другая модель, или та же модель, спрошенная иначе, могла бы сильнее или слабее предпочитать первую позицию. Смысл не в том, что каждый ИИ ведёт себя так, как этот, а в том, что одно сравнение не может сказать вам, ведёт ли себя так тот, который вы используете.
Пары выбирались, потому что они резко различались по результатам, так что эти цифры точности описывают явные хиты против явных промахов, а не две миниатюры, которые работали почти одинаково. Все каналы были устоявшимися и англоязычными.
И ничто из этого не касается реального A/B-тестирования. Тест, проведённый на реальных зрителях, измеряет, что они на самом деле сделали. Этот эксперимент касается только ИИ, пытающегося предсказать этот результат заранее.
Часто задаваемые вопросы
Может ли чат-бот ИИ выбрать лучшую миниатюру YouTube?
Частично. Протестированная нами модель выбирала лучшую миниатюру примерно в 63% случаев в среднем, что лучше случайного выбора, но совпадает с оценкой каждой миниатюры отдельно, а не превосходит её. Её ответ сильно зависел от того, какое изображение она видела первым, поэтому один ответ ненадёжен. Спросите дважды, поменяв порядок, и доверяйте только тем ответам, которые выживают при смене порядка.
Что такое позиционное предубеждение в сравнениях ИИ?
Позиционное предубеждение — это тенденция предпочитать вариант из-за его положения, а не содержания. В нашем тесте ИИ выбирал ту миниатюру, которую видел первой, в 64,7% случаев. Решение — показывать каждое сравнение в обоих порядках и считать ответ, который меняется, вообще не ответом.
Лучше оценивать миниатюры отдельно или сравнивать их рядом?
В нашем тесте оба метода были одинаково точны в среднем — 62,7%. Разница была в стабильности. Оценка каждой миниатюры отдельно даёт один и тот же результат независимо от порядка проверки, тогда как сравнение рядом давало ответы, меняющиеся с порядком почти в трети пар.
Почему ИИ звучит так уверенно в своём ответе?
Потому что уверенная формулировка — это его стандарт, а не измерение. Когда мы просили оценить свою уверенность, протестированная модель почти никогда не опускалась ниже 70 из 100 и обычно заявляла 85, хотя была права примерно в 63% случаев. В этом диапазоне более высокая заявленная уверенность не означала более надёжный ответ.
Значит ли это, что A/B-тестирование миниатюр бессмысленно?
Нет. Реальный тест показывает ваши миниатюры реальным зрителям и измеряет, что они делают — ничего не заменит это. Этот эксперимент касается только вопроса к ИИ, чтобы угадать победителя заранее. Для реального теста сложнее вопрос — достаточно ли велика разница, которую вы видите, по сравнению с нормальной вариацией вашего канала от одной загрузки к другой.