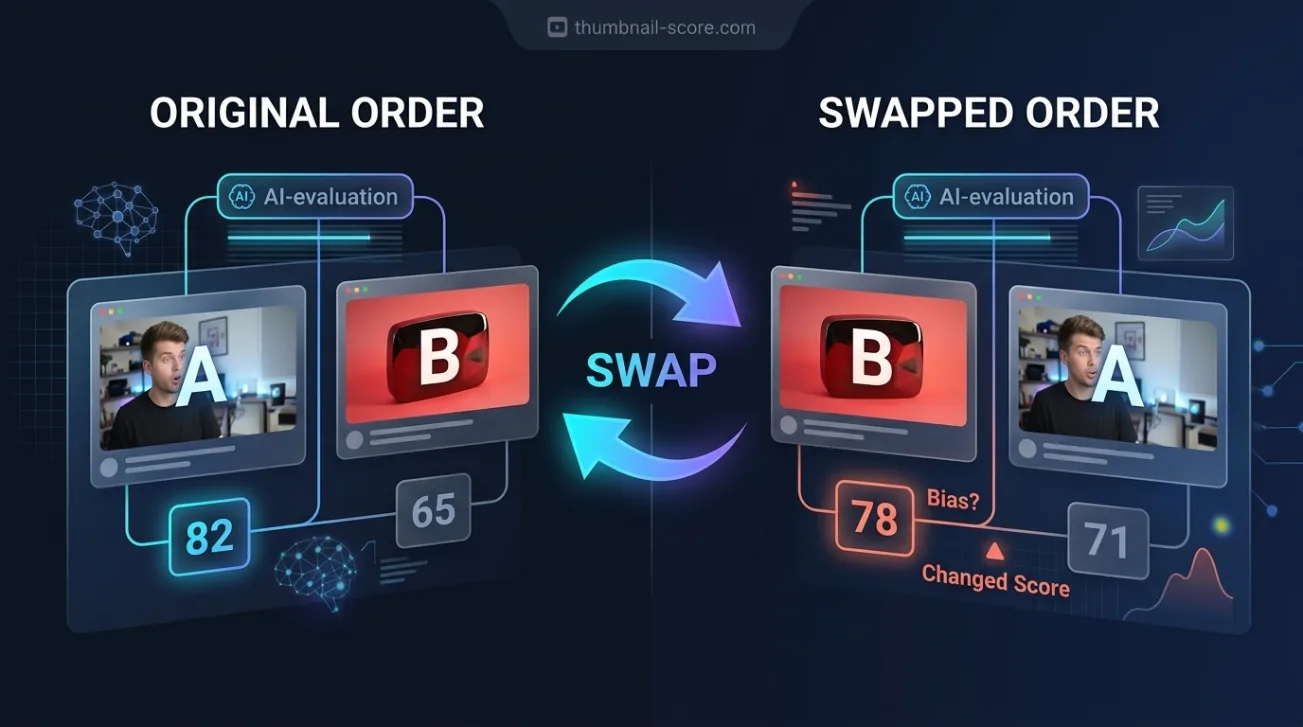
إذا قمت يومًا بلصق مُصغّرين في محادثة مع ذكاء اصطناعي وسألته أيهما سيحصل على مزيد من النقرات، فأنت قد أجريت تجربة دون تحكم. نحن أجرينا التجربة مع تحكم: 161 زوجًا من مقاطع الفيديو الحقيقية حيث كنا نعرف بالفعل أيها أداءً أفضل، عُرض كل زوج على الذكاء الاصطناعي مرتين، مرة في كل ترتيب. اتضح أن المُصغّر الذي رآه أولًا كان يحدد جزءًا كبيرًا من إجاباته.
النتائج الرئيسية
- عند عرض مُصغّرين من نفس القناة، اختار الذكاء الاصطناعي المُصغّر الأول في 64.7% من الحالات. القاضي الذي لا يفضل أي موضع سيكون قريبًا من 50%.
- عندما كان الفائز الحقيقي مُعرضًا أولًا، كان الذكاء الاصطناعي صحيحًا في 77.3% من الحالات. وعندما كان نفس الفائز مُعرضًا ثانيًا، كان صحيحًا في 48.0%.
- بمتوسط كلا الترتيبين، كان صحيحًا في 62.7% من الحالات، وهو ما يطابق تمامًا الدرجة التي تقيّم كل مُصغّر على حدة. لم يُضف المقارنة جنبًا إلى جنب أي دقة.
- أعطى إجابات متعارضة عندما تغيّر فقط الترتيب في 30.7% من الأزواج.
- نادرًا ما اعترف بالشك: كانت الإجابة النموذجية تدّعي ثقة بنسبة 85% بينما كان النموذج صحيحًا في حوالي 63% من الحالات.
هل يستطيع الذكاء الاصطناعي أن يخبرك أي مُصغّر من اثنين سيؤدي بشكل أفضل؟
أحيانًا، لكن ليس بطريقة يمكنك الوثوق بها من إجابة واحدة. بمتوسط كلا الترتيبين، اختار النموذج الذي اختبرناه المُصغّر الأداءً الأفضل في 62.7% من الحالات — تمامًا كما فعلت درجتنا التي تقيّم كل مُصغّر على حدة. لكن اختياره اعتمد على الصورة التي رآها أولًا: 77.3% صحيحًا عندما كان الفائز أولًا، و48.0% عندما كان ثانيًا.
ببساطة، تصرف الإجابة الواحدة كعملة تهبط على الخيار الأول في أغلب الأحيان. المعلومات موجودة هناك — عندما يعطي النموذج نفس الإجابة في كلا الاتجاهين، يكون صحيحًا أكثر من الصدفة — لكنك تجدها فقط بالسؤال مرتين.
كيف اختبرناه: أزواج حقيقية بإجابة معروفة، عُرضت كلا الاتجاهين
جاءت الأزواج من اختبارنا المنشور للدرجة: مقطعا فيديو من نفس القناة، نُشرا قريبين من بعضهما، أحدهما تفوق بوضوح على متوسط القناة الحديث، والآخر فشل بوضوح. استخدام نفس القناة يلغي عدد المشتركين، الجمهور وميزانية الإنتاج، لذا ما يختلف بين الاثنين هو في الغالب التغليف.
استخدمنا 161 زوجًا من نصف قنوات الدراسة وتركنا النصف الآخر دون تغيير. عُرض على الذكاء الاصطناعي — النموذج البصري نفسه الذي يدعم درجتنا — كلا المُصغّرين مع عناوينهما الحقيقية، وأُخبر أن أحدهما تفوق على مشاهدات القناة المعتادة والآخر لم يفعل، وسُئل أيهما أيهما. عادت 11 من 322 إجابة غير قابلة للاستخدام، مما ترك 150 زوجًا أُجيب عليها في كلا الترتيبين.
لماذا كان يجب عرض كل زوج مرتين
يمكن للذكاء الاصطناعي الذي يقارن خيارين أن يفضل موضعًا بغض النظر عن المحتوى، تمامًا كما يفضل بعض الناس العنصر الأول في القائمة. إذا كان هذا التفضيل موجودًا وأنت تعرض كل زوج مرة واحدة فقط، فلا يمكنك التمييز بينه وبين المهارة: القاضي الذي يختار دائمًا الصورة الأولى يبدو رائعًا كلما كان المُصغّر الأفضل مدرجًا أولًا.
عرض كل زوج مرتين، مع تبديل الترتيب، يفصل بين الاثنين. يجب أن تبقى المهارة ثابتة بعد التبديل. أما التفضيل للموضع فيجب أن ينقلب معه.
فاز المُصغّر المعروض أولًا في معظم المناقشات
في 300 إجابة، اختار الذكاء الاصطناعي المُصغّر الذي عُرض عليه أولًا في 64.7% من الحالات. هذا التفضيل يغيّر قيمة أي إجابة واحدة:
| كيف عُرض الزوج | كم مرة اختار الذكاء الاصطناعي الفائز الحقيقي |
|---|---|
| عُرض الفائز أولًا | 77.3% |
| عُرض الفائز ثانيًا | 48.0% |
| متوسط كلا الترتيبين | 62.7% |
| درجتنا، بتقييم كل مُصغّر على حدة | 62.7% |
| نفس الإجابة الصحيحة في كلا الترتيبين | 47.3% (التخمين العشوائي: حوالي 25%) |
الصف الأول هو المقارنة العادلة مع درجة تقيّم كل مُصغّر بمفرده، لأن كلاهما يعطي إجابة واحدة لكل زوج. في هذا الأساس، تعادل كلا الأسلوبين عند 62.7%. لم تُضف المقارنة جنبًا إلى جنب أي دقة؛ بل أضافت اعتمادًا على الترتيب.
الصف الأخير هو الاختبار الأشد صرامة: تُحسب الإجابة فقط إذا اختار الذكاء الاصطناعي المُصغّر الصحيح نفسه مرتين. القاضي الذي يخمن عشوائيًا سيجتازه حوالي ربع المرات، والقاضي الذي يختار دائمًا الصورة الأولى لن يجتازه أبدًا. اجتاز الذكاء الاصطناعي 47.3% من الأزواج، لذا فإن الإشارة حقيقية — لكنها متشابكة مع الموضع.
غيّر رأيه في ثلث الأزواج تقريبًا
في 46 من 150 زوجًا، أي 30.7%، أعطى الذكاء الاصطناعي إجابات متعارضة فقط بسبب الترتيب. لم يتغيّر شيء في أي من المُصغّرين أو العناوين بين السؤالين.
في الـ104 أزواج الأخرى كان متسقًا، وفيها كان صحيحًا في 68.3% من الحالات. درجتنا، في نفس الأزواج الـ104، كانت صحيحة في 63.5% من الحالات. هذا الفرق صغير جدًا بحيث لا يمكن التأكد منه بهذه الأعداد، لكنه يشير إلى شيء مفيد: الإجابة التي تنجو من التبديل تستحق أكثر من تلك التي لم تُختبر أبدًا.
رقم ثقته ليس احتمالًا
طلبنا رقم ثقة مع كل إجابة وأخبرنا الذكاء الاصطناعي أن 50 تعني رمي عملة. نادرًا ما استخدم النصف السفلي من المقياس. أقل ثقة ذكرها عبر جميع الإجابات الثلاثمائة كانت 65، والإجابة النموذجية ادّعت 85، وفقط 4 إجابات كانت أقل من 70.
في غضون ذلك، كان صحيحًا في حوالي 63% من الحالات. الإجابات التي قيّمها بين 80 و89 كانت صحيحة في 61.6% من الحالات؛ والإجابات التي قيّمها بين 70 و79 كانت صحيحة في 63.5% من الحالات. عبر النطاق الذي سقطت فيه معظم إجاباته، لم يخبرك الرقم بشيء عن أي الإجابات يجب أن تثق بها.
الـ17 إجابة التي قيّمها 90 أو أعلى كانت صحيحة في 82.4% من الحالات، وهو ما يوحي بشيء، لكن 17 قليل جدًا للاعتماد عليه. القراءة العملية بسيطة: النبرة الواثقة من مقارنة الذكاء الاصطناعي هي وضعه الافتراضي، وليس دليلًا.
كيف تتحقق من أي قاضٍ للصور المصغّرة بالذكاء الاصطناعي في خمس دقائق
اختبارنا نموذجًا واحدًا، وقد تتصرف أدوات أخرى بشكل مختلف. لا تحتاج إلى قبول كلمتنا في أي من الاتجاهين، لأن الفحص سريع التنفيذ بنفسك:
- اختر مُصغّرين تعرف بالفعل الإجابة: مقطعي فيديو سابقين من قناتك، نُشرا قريبين من بعضهما، أحدهما أعلى بوضوح من مشاهداتك المعتادة والآخر أقل بوضوح.
- اسأل الذكاء الاصطناعي أيهما أداءً أفضل، مع عرض الأقوى أولًا. سجّل إجابته وأي ثقة يعطيها.
- ابدأ محادثة جديدة، حتى لا يتذكر إجابته الأولى، واسأله مرة أخرى مع عكس الترتيب.
- كرر ذلك مع عشرة أزواج على الأقل. احسب كم مرة يختار الصورة التي تأتي أولًا، وكم مرة تبقى إجابته بعد التبديل.
- ثق فقط بالإجابات التي تنجو من التبديل، وتجاهل رقم الثقة تمامًا.
إذا كنت تفضل رقمًا لا يعتمد على ترتيب العرض على الإطلاق، يمكنك تقييم كل مُصغّر وعنوان على حدة. درجة منفصلة لكل خيار، تُقارن لاحقًا، لا تملك موضعًا أولًا لتفضيله.
ما لا يُظهره هذا التجربة
اختبارنا نموذجًا واحدًا بتعليمات واحدة. قد يفضل نموذج مختلف، أو نفس النموذج إذا سُئل بطريقة مختلفة، الموضع الأول بقوة أكبر أو أقل. النقطة ليست أن كل ذكاء اصطناعي يتصرف هكذا؛ بل أن مقارنة واحدة لا يمكنها أن تخبرك ما إذا كان الذكاء الاصطناعي الذي تستخدمه يتصرف كذلك.
اختيرت الأزواج لأنها اختلفت بوضوح في الأداء، لذا تصف أرقام الدقة هذه إصابات واضحة مقابل إخفاقات واضحة، وليس مُصغّرين أداءً شبه متطابق. كانت كل قناة راسخة وبلغتها الإنجليزية.
ولا يتعلّق أي من هذا باختبارات التقسيم الحقيقية. الاختبار الذي يُجرى على المشاهدين الحقيقيين يقيس ما فعله هؤلاء المشاهدون فعليًا. تتعلق هذه التجربة فقط بالذكاء الاصطناعي الذي يحاول التنبؤ بهذه النتيجة مسبقًا.
الأسئلة الشائعة
هل يستطيع روبوت الدردشة بالذكاء الاصطناعي اختيار أفضل مصغّر يوتيوب؟
جزئيًا. اختار النموذج الذي اختبرناه المُصغّر الأداءً الأفضل في حوالي 63% من الحالات في المتوسط، وهو ما يفوق الصدفة لكنه يطابق بدلاً من أن يتفوق على تقييم كل مُصغّر على حدة. اعتمدت إجابته بشدة على الصورة التي رآها أولًا، لذا فإن الرد الواحد غير موثوق. اسأل مرتين مع عكس الترتيب، وثق فقط بالإجابات التي تنجو من التبديل.
ما هو التحيز الموضعي في مقارنات الذكاء الاصطناعي؟
التحيز الموضعي هو ميل لتفضيل خيار بسبب مكان ظهوره وليس محتواه. في اختبارنا، اختار الذكاء الاصطناعي المُصغّر الذي عُرض عليه أولًا في 64.7% من الحالات. العلاج هو عرض كل مقارنة في كلا الترتيبين واعتبار الإجابة التي تنقلب كأنها لا إجابة على الإطلاق.
هل من الأفضل تقييم المُصغّرات بشكل منفصل أم مقارنتها جنبًا إلى جنب؟
في اختبارنا، كان كلا الأسلوبين متساويين في الدقة في المتوسط، عند 62.7%. كان الاختلاف في الاستقرار. يعطي تقييم كل مُصغّر على حدة نفس النتيجة مهما كان ترتيب فحصهما، بينما أنتجت المقارنة جنبًا إلى جنب إجابات تغيّرت مع الترتيب في ثلث الأزواج تقريبًا.
لماذا يبدو الذكاء الاصطناعي واثقًا جدًا من إجابته؟
لأن الصياغة الواثقة هي وضعه الافتراضي، وليس قياسًا. عند طلب تقييم يقينه، نادرًا ما انخفض النموذج الذي اختبرناه عن 70 من 100 وادّعى عادةً 85، بينما كان صحيحًا في حوالي 63% من الحالات. ضمن هذا النطاق، لم يعني ارتفاع الثقة المعلنة إجابة أكثر موثوقية.
هل يعني هذا أن اختبارات A/B للمُصغّرات عديمة الفائدة؟
لا. الاختبار الحقيقي يعرض مُصغّراتك للمشاهدين الحقيقيين ويقيس ما يفعلونه، وهو ما لا يعوّضه أي تنبؤ. تتعلق هذه التجربة فقط بطلب الذكاء الاصطناعي التنبؤ بالفائز مسبقًا. بالنسبة لاختبار حقيقي، السؤال الأصعب هو ما إذا كان الفرق الذي تراه أكبر من التباين الطبيعي لقناتك من تحميل إلى آخر.