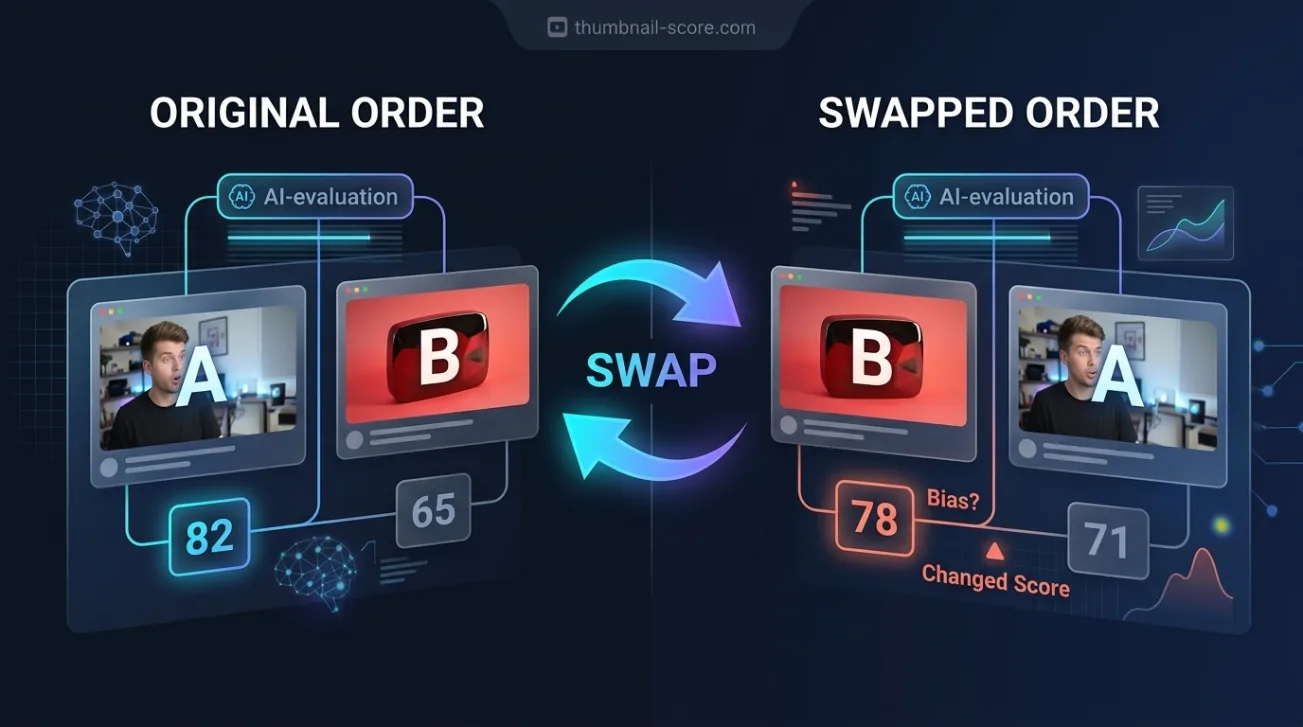
Se hai mai incollato due thumbnail in una chat AI chiedendo quale otterrà più clic, hai eseguito un esperimento senza controllo. Noi l'abbiamo fatto con un controllo: 161 coppie di video reali di cui sapevamo già quale aveva prestato meglio, mostrate all'IA due volte, una per ogni ordine. Il thumbnail che vedeva per primo ha deciso una grande parte delle sue risposte.
Conclusioni chiave
- Mostrati due thumbnail dello stesso canale, l'IA ha scelto quello che appariva per primo nel 64,7% dei casi. Un giudice senza preferenza per la posizione si attesterebbe intorno al 50%.
- Quando il vincitore reale era mostrato per primo, l'IA aveva ragione nel 77,3% dei casi. Quando lo stesso vincitore era mostrato per secondo, nel 48,0%.
- In media su entrambi gli ordini aveva ragione nel 62,7% dei casi, esattamente come un punteggio che valuta ogni thumbnail separatamente. Il confronto a fianco non ha aggiunto accuratezza.
- Ha dato risposte opposte quando l'unica cosa cambiata era l'ordine nel 30,7% delle coppie.
- Quasi mai ha ammesso dubbi: una risposta tipica dichiarava un'85% di fiducia, mentre il modello aveva ragione circa il 63% delle volte.
Può un'IA dirti quale dei due thumbnail performa meglio?
A volte, ma non in un modo su cui puoi contare da una singola risposta. In media su entrambi gli ordini, il modello che abbiamo testato ha scelto il thumbnail con prestazioni migliori nel 62,7% dei casi — esattamente quanto il nostro punteggio ottenuto valutando ogni thumbnail separatamente. Ma la sua scelta dipendeva da quale immagine vedeva per prima: 77,3% di risposte corrette quando il vincitore veniva mostrato per primo, 48,0% quando veniva mostrato per secondo.
Detto semplicemente, una singola risposta si comporta come una moneta che cade sull'opzione iniziale più spesso che no. L'informazione c'è — quando il modello dà la stessa risposta in entrambi gli ordini, ha ragione più spesso del caso — ma la trovi solo chiedendo due volte.
Come l'abbiamo testato: coppie reali con risposta nota, mostrate in entrambi gli ordini
Le coppie provenivano dal nostro test pubblicato del punteggio: due video dello stesso canale, pubblicati vicini nel tempo, uno che superava chiaramente la media recente del canale e uno che la sottovalutava. Usare lo stesso canale annulla il numero di iscritti, il pubblico e il budget di produzione, quindi ciò che differisce tra i due è soprattutto il packaging.
Abbiamo usato le 161 coppie da metà dei canali dello studio, lasciando l'altra metà intatta. L'IA — lo stesso modello visivo che alimenta il nostro punteggio — ha visto entrambi i thumbnail con i loro titoli reali, gli è stato detto che uno aveva superato le visualizzazioni abituali del canale e l'altro le aveva sottovalutate, e gli è stato chiesto quale fosse quale. Undici delle 322 risposte sono risultate inutilizzabili, lasciando 150 coppie risposte in entrambi gli ordini.
Perché ogni coppia doveva essere mostrata due volte
Un'IA che confronta due opzioni può preferire una posizione indipendentemente dal contenuto, proprio come alcune persone preferiscono il primo elemento di un elenco. Se tale preferenza esiste e mostri ogni coppia sempre nello stesso modo, non puoi distinguerla dall'abilità: un giudice che sceglie sempre la prima immagine sembra brillante ogni volta che il thumbnail migliore capita di essere elencato per primo.
Mostrare ogni coppia due volte, con l'ordine invertito, separa i due fattori. L'abilità dovrebbe sopravvivere allo scambio. Una preferenza per una posizione dovrebbe invertirsi con essa.
Il thumbnail mostrato per primo ha vinto la maggior parte degli scontri
Su 300 risposte, l'IA ha scelto il thumbnail che le era stato mostrato per primo nel 64,7% dei casi. Questa preferenza cambia il valore di qualsiasi singola risposta:
| Come è stata mostrata la coppia | Quante volte l'IA ha scelto il vincitore reale |
|---|---|
| Vincitore mostrato per primo | 77,3% |
| Vincitore mostrato per secondo | 48,0% |
| Media su entrambi gli ordini | 62,7% |
| Il nostro punteggio, valutando ogni thumbnail separatamente | 62,7% |
| Stessa risposta corretta in entrambi gli ordini | 47,3% (indovinare a caso: circa 25%) |
La riga media è il confronto equo con un punteggio che valuta ogni thumbnail da solo, perché entrambi danno una risposta per coppia. Su questo terreno i due metodi sono pari al 62,7%. Il confronto a fianco non ha aggiunto accuratezza; ha aggiunto una dipendenza dall'ordine.
L'ultima riga è il test più rigoroso: una risposta conta solo se l'IA ha scelto lo stesso thumbnail corretto entrambe le volte. Un giudice che indovina a caso supererebbe questo test circa un quarto delle volte, e uno che sceglie sempre la prima immagine non lo supererebbe mai. L'IA lo ha superato nel 47,3% delle coppie, quindi il segnale è reale — ma è intrecciato con la posizione.
Ha cambiato idea su quasi un terzo delle coppie
Su 46 delle 150 coppie, il 30,7%, l'IA ha dato risposte opposte dipendendo solo dall'ordine. Nulla riguardo a nessuno dei due thumbnail o titoli era cambiato tra le due domande.
Sulle altre 104 coppie è stata coerente, e su quelle aveva ragione nel 68,3% dei casi. Il nostro punteggio, sulle stesse 104 coppie, aveva ragione nel 63,5% dei casi. Questo divario è troppo piccolo per essere sicuro con questo numero di coppie, ma indica qualcosa di utile: una risposta che sopravvive allo scambio vale più di una mai testata.
Il suo numero di fiducia non è una probabilità
Abbiamo chiesto un valore di fiducia con ogni risposta e abbiamo detto all'IA che 50 significava un lancio di moneta. Ha usato a malapena la metà inferiore della scala. La sua fiducia dichiarata più bassa su tutte le 300 risposte era 65, una risposta tipica dichiarava 85, e solo 4 risposte erano sotto 70.
Nel frattempo aveva ragione circa il 63% delle volte. Le risposte che ha valutato tra 80 e 89 erano corrette nel 61,6% dei casi; quelle valutate tra 70 e 79 erano corrette nel 63,5% dei casi. Nell'intervallo in cui quasi tutte le sue risposte cadevano, il numero non ti diceva nulla su quali risposte credere.
Le 17 risposte che ha valutato 90 o più erano corrette nell'82,4% dei casi, il che è indicativo, ma 17 sono troppo poche per affidarvisi. La lettura pratica è semplice: un tono fiducioso da un confronto AI è il suo registro predefinito, non una prova.
Come verificare qualsiasi giudice AI di thumbnail in cinque minuti
Abbiamo testato un modello, e altri strumenti potrebbero comportarsi diversamente. Non devi prendere la nostra parola in entrambi i casi, perché il controllo è rapido da eseguire da soli:
- Scegli due thumbnail di cui già conosci la risposta: due video passati del tuo canale, pubblicati vicini nel tempo, uno chiaramente sopra le tue visualizzazioni abituali e uno chiaramente sotto.
- Chiedi all'IA quale ha performato meglio, mostrando per primo quello più forte. Annota la sua risposta e qualsiasi fiducia che fornisce.
- Avvia una nuova conversazione, in modo che non possa ricordare la sua prima risposta, e chiedi di nuovo con l'ordine invertito.
- Ripeti con almeno dieci coppie. Conta quante volte sceglie l'immagine che appare per prima, e quante volte la sua risposta sopravvive allo scambio.
- Fidati solo delle risposte che sopravvivono allo scambio, e ignora completamente il numero di fiducia.
Se preferisci un numero che non dipenda affatto dall'ordine di presentazione, puoi valutare ogni thumbnail e titolo separatamente. Un punteggio separato per ogni opzione, confrontato in seguito, non ha una prima posizione da preferire.
Cosa questo esperimento non mostra
Ha testato un modello con un insieme di istruzioni. Un modello diverso, o lo stesso modello interrogato in modo diverso, potrebbe preferire la prima posizione più o meno fortemente. Il punto non è che ogni IA si comporta così, ma che un singolo confronto non può dirti se quella che stai usando lo fa.
Le coppie sono state scelte perché differivano nettamente nelle prestazioni, quindi queste cifre di accuratezza descrivono colpi chiari contro mancate chiare, non due thumbnail che performavano quasi identicamente. Ogni canale era consolidato e in lingua inglese.
E niente di tutto ciò riguarda il vero test A/B. Un test eseguito su spettatori reali misura ciò che quegli spettatori hanno effettivamente fatto. Questo esperimento riguarda solo un'IA che cerca di prevedere quel risultato in anticipo.
Domande frequenti
Può un chatbot AI scegliere il miglior thumbnail YouTube?
Parzialmente. Il modello che abbiamo testato ha scelto il thumbnail con prestazioni migliori circa il 63% delle volte in media, il che batte il caso ma corrisponde piuttosto che supera il punteggio di ogni thumbnail separatamente. La sua risposta dipendeva fortemente da quale immagine vedeva per prima, quindi una singola risposta non è affidabile. Chiedi due volte con l'ordine invertito, e fidati solo delle risposte che sopravvivono allo scambio.
Cos'è il bias di posizione nei confronti AI?
Il bias di posizione è la tendenza a preferire un'opzione a causa della sua posizione piuttosto che del suo contenuto. Nel nostro test, l'IA ha scelto il thumbnail mostrato per primo nel 64,7% dei casi. La soluzione è presentare ogni confronto in entrambi gli ordini e considerare una risposta che cambia come nessuna risposta.
È meglio valutare i thumbnail separatamente o confrontarli a fianco?
Nel nostro test i due metodi erano ugualmente accurati in media, al 62,7%. La differenza era la stabilità. Valutare ogni thumbnail da solo dà lo stesso risultato indipendentemente dall'ordine in cui li controlli, mentre il confronto a fianco ha prodotto risposte che cambiavano con l'ordine in quasi un terzo delle coppie.
Perché l'IA sembra così sicura della sua risposta?
Perché un linguaggio fiducioso è il suo default, non una misura. Chiesto di valutare la propria certezza, il modello che abbiamo testato quasi mai scendeva sotto 70 su 100 e tipicamente dichiarava 85, mentre aveva ragione circa il 63% delle volte. In questo intervallo, una fiducia dichiarata più alta non significava una risposta più affidabile.
Questo significa che i test A/B sui thumbnail sono inutili?
No. Un test reale mostra i tuoi thumbnail a spettatori reali e misura ciò che fanno, cosa che nessuna previsione può sostituire. Questo esperimento riguarda solo chiedere a un'IA di indovinare il vincitore in anticipo. Per un test reale, la domanda più difficile è se la differenza che vedi è maggiore della variazione normale del tuo canale da un upload all'altro.