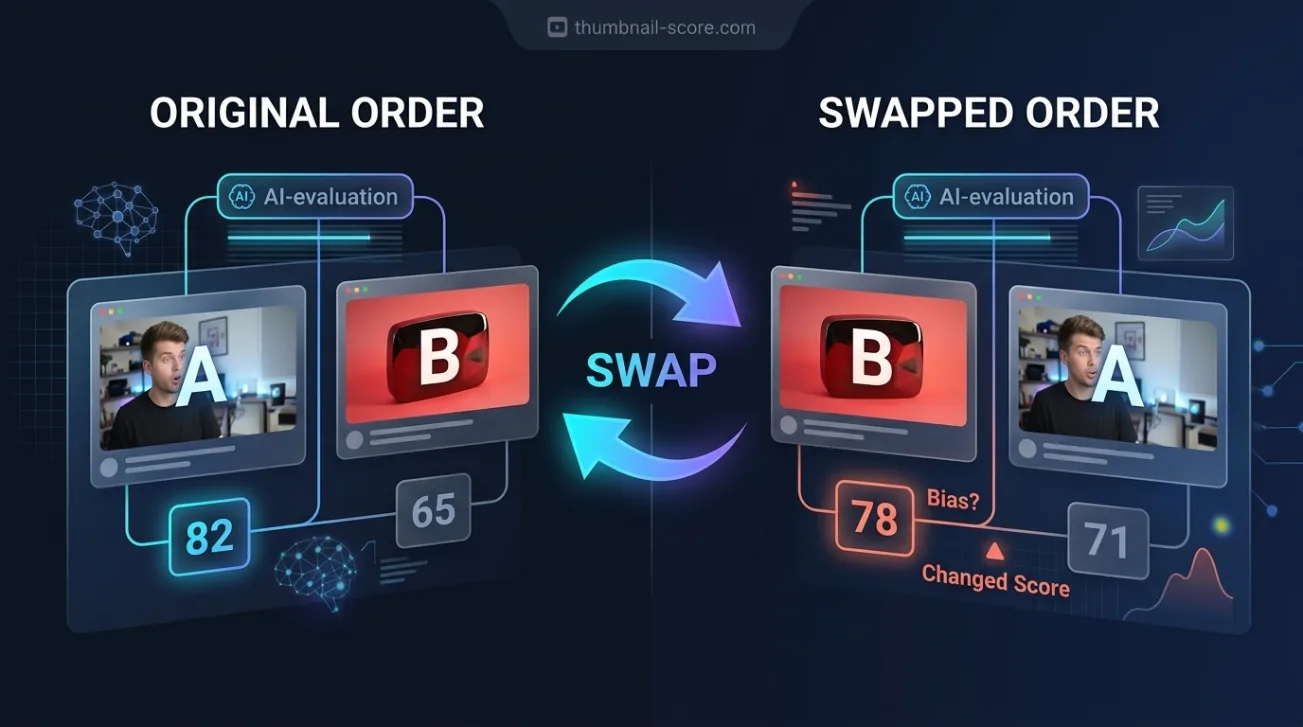
ถ้าคุณเคยวางภาพปกสองภาพลงในแชท AI แล้วถามว่าภาพไหนจะได้คลิกมากกว่า คุณกำลังทำการทดลองโดยไม่มีการควบคุม เราทำการทดลองนี้ด้วยการควบคุม: 161 คู่ของวิดีโอจริงที่เรารู้อยู่แล้วว่าอันไหนทำได้ดีกว่า แต่ละคู่ถูกแสดงให้ AI ดูสองครั้ง ครั้งละลำดับหนึ่ง ผลปรากฏว่าภาพปกที่ AI เห็นก่อนหน้ามีอิทธิพลต่อคำตอบของมันอย่างมาก
ข้อสรุปสำคัญ
- เมื่อแสดงภาพปกสองภาพจากช่องเดียวกัน AI จะเลือกภาพที่ปรากฏก่อน 64.7% ของเวลา ผู้ตัดสินที่ไม่มีอคติต่อตำแหน่งควรจะอยู่ใกล้ 50%
- เมื่อภาพที่ชนะจริงปรากฏก่อน AI ตอบถูก 77.3% ของเวลา แต่เมื่อภาพเดียวกันนั้นปรากฏหลัง กลับตอบถูกเพียง 48.0%
- เฉลี่ยจากทั้งสองลำดับ AI ตอบถูก 62.7% ของเวลา ซึ่งเท่ากับคะแนนที่ประเมินภาพปกแต่ละภาพแยกกัน การเปรียบเทียบแบบเคียงข้างกันไม่เพิ่มความแม่นยำ
- มันให้คำตอบตรงกันข้ามเมื่อเปลี่ยนแค่ลำดับใน 30.7% ของคู่
- มันแทบไม่เคยยอมรับความไม่แน่นอน: คำตอบทั่วไปอ้างความมั่นใจ 85% ขณะที่โมเดลตอบถูกจริงประมาณ 63% ของเวลา
AI สามารถบอกคุณได้ไหมว่าภาพปกไหนจะทำผลงานดีกว่ากัน?
บางครั้ง แต่ไม่ใช่ในลักษณะที่คุณจะเชื่อถือได้จากคำตอบเดียว เฉลี่ยจากทั้งสองลำดับ โมเดลที่เราทดสอบเลือกภาพปกที่ทำผลงานดีกว่า 62.7% ของเวลา — เท่ากับคะแนนของเราที่ประเมินภาพปกแต่ละภาพแยกกัน แต่คำตอบของมันขึ้นอยู่กับภาพที่มันเห็นก่อน: ถูก 77.3% เมื่อภาพที่ชนะปรากฏก่อน และ 48.0% เมื่อปรากฏหลัง
กล่าวง่ายๆ คำตอบเดียวมีพฤติกรรมเหมือนเหรียญที่มักจะออกด้านแรกมากกว่า ข้อมูลมีอยู่จริง — เมื่อโมเดลให้คำตอบเดียวกันทั้งสองทาง มันมักจะถูกมากกว่าการเดา — แต่คุณจะพบมันได้ก็ต่อเมื่อถามสองครั้ง
เราทดสอบอย่างไร: คู่ของภาพจริงที่รู้คำตอบแล้ว แสดงทั้งสองทาง
คู่ภาพเหล่านี้มาจากทดสอบที่เราเผยแพร่ของคะแนน: วิดีโอสองคลิปจากช่องเดียวกัน ที่เผยแพร่ใกล้กัน หนึ่งคลิปที่ชนะค่าเฉลี่ยล่าสุดของช่อง และอีกคลิปที่ต่ำกว่าอย่างชัดเจน การใช้ช่องเดียวกันช่วยตัดจำนวนผู้ติดตาม กลุ่มผู้ชม และงบประมาณการผลิต ดังนั้นสิ่งที่ต่างกันระหว่างสองคลิปนี้จึงเป็นส่วนใหญ่คือการจัดแพ็คเกจ
เราใช้คู่ภาพ 161 คู่จากครึ่งหนึ่งของช่องในงานศึกษา และเก็บอีกครึ่งไว้ไม่แตะต้อง AI — โมเดลภาพเดียวกับที่ขับเคลื่อนคะแนนของเรา — ได้เห็นภาพปกทั้งสองพร้อมชื่อจริง ถูกบอกว่าอันหนึ่งทำได้ดีกว่าค่าเฉลี่ยของช่อง และอีกอันทำได้แย่กว่า แล้วถูกถามว่าอันไหนคืออันไหน จาก 322 คำตอบ มี 11 คำตอบที่ใช้ไม่ได้ จึงเหลือ 150 คู่ที่ได้รับคำตอบทั้งสองลำดับ
ทำไมต้องแสดงแต่ละคู่สองครั้ง
AI ที่เปรียบเทียบตัวเลือกสองตัวอาจชอบตำแหน่งหนึ่งโดยไม่ขึ้นกับเนื้อหา คล้ายกับคนบางรายที่ชอบรายการแรกในรายการ ถ้ามีอคตินี้อยู่และคุณแสดงแต่ละคู่เพียงทางเดียว คุณจะไม่สามารถแยกมันออกจากทักษะได้: ผู้ตัดสินที่เลือกภาพแรกเสมอจะดูฉลาดเมื่อภาพที่ดีกว่า恰好ปรากฏเป็นอันแรก
การแสดงแต่ละคู่สองครั้ง โดยสลับลำดับ ช่วยแยกทั้งสองอย่าง ทักษะควรยังคงอยู่หลังจากสลับ แต่อคติต่อตำแหน่งควรกลับด้านตามลำดับ
ภาพปกที่ปรากฏก่อนชนะการโต้แย้งส่วนใหญ่
จาก 300 คำตอบ AI เลือกภาพที่มันเห็นก่อน 64.7% ของเวลา อคตินี้เปลี่ยนคุณค่าของคำตอบแต่ละข้อ:
| วิธีการแสดงคู่ภาพ | ความถี่ที่ AI เลือกภาพที่ชนะจริง |
|---|---|
| ภาพที่ชนะปรากฏก่อน | 77.3% |
| ภาพที่ชนะปรากฏหลัง | 48.0% |
| เฉลี่ยจากทั้งสองลำดับ | 62.7% |
| คะแนนของเรา ประเมินภาพแต่ละภาพแยกกัน | 62.7% |
| คำตอบถูกต้องเหมือนกันทั้งสองลำดับ | 47.3% (การเดาแบบสุ่ม: ประมาณ 25%) |
แถวเฉลี่ยคือการเปรียบเทียบที่ยุติธรรมกับคะแนนที่ประเมินภาพแต่ละภาพแยกกัน เพราะทั้งสองให้คำตอบหนึ่งข้อต่อคู่ บนพื้นฐานนี้ ทั้งสองวิธีเสมอกันที่ 62.7% การเปรียบเทียบแบบเคียงข้างกันไม่เพิ่มความแม่นยำ มันเพิ่มการพึ่งพาลำดับ
แถวสุดท้ายคือการทดสอบที่เข้มงวดกว่า: นับคำตอบก็ต่อเมื่อ AI เลือกภาพที่ถูกต้องเหมือนกันทั้งสองครั้ง ผู้ตัดสินที่เดาแบบสุ่มจะผ่านเกณฑ์นี้ประมาณหนึ่งในสี่ของเวลา และผู้ที่เลือกภาพแรกเสมอจะไม่ผ่านเลย AI ผ่านเกณฑ์นี้ใน 47.3% ของคู่ ดังนั้นสัญญาณจึงมีอยู่จริง — แต่มันพันกันกับตำแหน่ง
มันเปลี่ยนใจในเกือบหนึ่งในสามของคู่
ใน 46 จาก 150 คู่ หรือ 30.7% AI ให้คำตอบตรงกันข้ามเพียงเพราะลำดับเปลี่ยน ไม่มีอะไรเปลี่ยนแปลงในภาพหรือชื่อทั้งสองระหว่างคำถามสองข้อ
ในอีก 104 คู่ที่เหลือ มันมีความสม่ำเสมอ และในคู่เหล่านั้น มันตอบถูก 68.3% ของเวลา คะแนนของเราในคู่เดียวกัน 104 คู่นั้น ตอบถูก 63.5% ของเวลา ช่องว่างนี้เล็กเกินไปที่จะมั่นใจได้ด้วยจำนวนคู่ที่มี แต่มันชี้ไปยังสิ่งที่มีประโยชน์: คำตอบที่ยังคงอยู่หลังจากสลับลำดับมีคุณค่ามากกว่าคำตอบที่ไม่เคยถูกทดสอบ
ตัวเลขความมั่นใจของมันไม่ใช่ความน่าจะเป็น
เราขอตัวเลขความมั่นใจกับคำตอบทุกข้อ และบอก AI ว่า 50 หมายถึงการโยนเหรียญ มันแทบไม่ใช้ครึ่งล่างของสเกล ค่าความมั่นใจต่ำสุดที่มันให้ไว้จากคำตอบทั้ง 300 ข้อคือ 65 คำตอบทั่วไปอ้าง 85 และมีเพียง 4 คำตอบที่ต่ำกว่า 70
ขณะเดียวกัน มันตอบถูกประมาณ 63% ของเวลา คำตอบที่มันให้คะแนนระหว่าง 80 ถึง 89 ถูก 61.6% ของเวลา; คำตอบที่ให้คะแนนระหว่าง 70 ถึง 79 ถูก 63.5% ของเวลา ในช่วงที่คำตอบส่วนใหญ่ของมันตกอยู่ ตัวเลขไม่ได้บอกคุณเลยว่าควรเชื่อคำตอบไหน
คำตอบ 17 ข้อที่มันให้คะแนน 90 หรือสูงกว่า ถูก 82.4% ของเวลา ซึ่งน่าสนใจ แต่ 17 ข้อนั้นน้อยเกินไปที่จะพึ่งพาได้ การตีความที่ใช้งานได้จริงคือง่ายๆ: น้ำเสียงมั่นใจจาก AI ในการเปรียบเทียบคือรูปแบบเริ่มต้นของมัน ไม่ใช่หลักฐาน
วิธีตรวจสอบ AI ที่ประเมินภาพปกใดๆ ใน 5 นาที
เราทดสอบโมเดลหนึ่งตัว และเครื่องมืออื่นๆ อาจมีพฤติกรรมต่างกัน คุณไม่จำเป็นต้องเชื่อคำพูดของเรา เพราะการตรวจสอบนี้ทำเองได้เร็ว:
- เลือกภาพปกสองภาพที่คุณรู้คำตอบอยู่แล้ว: วิดีโอสองคลิปจากช่องของคุณเอง ที่เผยแพร่ใกล้กัน หนึ่งคลิปที่ชัดเจนว่าเหนือค่าเฉลี่ยของคุณ และอีกคลิปที่ต่ำกว่า
- ถาม AI ว่าอันไหนทำผลงานดีกว่า โดยแสดงภาพที่แข็งแกร่งกว่าก่อน จดคำตอบและระดับความมั่นใจที่มันให้
- เริ่มการสนทนาใหม่ เพื่อให้มันจำคำตอบแรกไม่ได้ และถามอีกครั้งโดยสลับลำดับ
- ทำซ้ำกับอย่างน้อยสิบคู่ นับว่ามันเลือกภาพที่ปรากฏก่อนบ่อยแค่ไหน และคำตอบของมันยังคงเหมือนเดิมหลังสลับลำดับบ่อยแค่ไหน
- เชื่อเฉพาะคำตอบที่ยังคงเหมือนเดิมหลังสลับลำดับ และไม่สนใจตัวเลขความมั่นใจทั้งหมด
ถ้าคุณต้องการตัวเลขที่ไม่ขึ้นกับลำดับการนำเสนอเลย คุณสามารถ ประเมินภาพปกและชื่อแต่ละอันแยกกัน คะแนนแยกสำหรับแต่ละตัวเลือก แล้วเปรียบเทียบภายหลัง จะไม่มีตำแหน่งแรกให้ชอบ
การทดลองนี้ไม่ได้แสดงอะไร
มันทดสอบโมเดลหนึ่งตัวด้วยคำแนะนำชุดหนึ่ง โมเดลต่างๆ หรือโมเดลเดียวกันที่ถูกถามต่างกัน อาจมีอคติต่อตำแหน่งแรกมากหรือน้อยกว่า จุดไม่ใช่ว่า AI ทุกตัวมีพฤติกรรมแบบนี้ แต่คือการเปรียบเทียบเดียวไม่สามารถบอกคุณได้ว่า AI ที่คุณใช้อยู่มีพฤติกรรมแบบนี้หรือไม่
คู่ภาพถูกเลือกเพราะมีความแตกต่างอย่างชัดเจนในผลการดำเนินงาน ดังนั้นตัวเลขความแม่นยำเหล่านี้อธิบายการตีที่ชัดเจนเทียบกับการพลาดที่ชัดเจน ไม่ใช่ภาพปกสองภาพที่ทำผลงานใกล้เคียงกันมาก ทุกช่องเป็นช่องที่มีอยู่แล้วและใช้ภาษาอังกฤษ
และไม่มีสิ่งใดในนี้เกี่ยวกับการทดสอบแบบแบ่งจริง การทดสอบที่ทำกับผู้ชมจริงวัดสิ่งที่ผู้ชมเหล่านั้นทำจริง การทดลองนี้เกี่ยวข้องเฉพาะกับ AI ที่พยายามทำนายผลลัพธ์นั้นล่วงหน้า
คำถามที่พบบ่อย
AI แชทบอทสามารถเลือกภาพปก YouTube ที่ดีที่สุดได้ไหม?
บางส่วน โมเดลที่เราทดสอบเลือกภาพปกที่ทำผลงานดีกว่าประมาณ 63% ของเวลาโดยเฉลี่ย ซึ่งดีกว่าการเดา แต่เท่ากับการประเมินภาพปกแต่ละภาพแยกกัน ไม่ใช่ดีกว่า คำตอบของมันขึ้นอยู่กับภาพที่มันเห็นก่อนอย่างมาก ดังนั้นคำตอบเดียวจึงไม่น่าเชื่อถือ ถามสองครั้งโดยสลับลำดับ และเชื่อเฉพาะคำตอบที่ยังคงเหมือนเดิมหลังสลับ
อคติต่อตำแหน่งในการเปรียบเทียบ AI คืออะไร?
อคติต่อตำแหน่งคือแนวโน้มที่จะชอบตัวเลือกหนึ่งเพราะตำแหน่งที่มันปรากฏ มากกว่าเนื้อหาที่มันมี ในทดสอบของเรา AI เลือกภาพที่มันเห็นก่อน 64.7% ของเวลา วิธีแก้คือแสดงการเปรียบเทียบแต่ละคู่ในทั้งสองลำดับ และถือว่าคำตอบที่เปลี่ยนแปลงเมื่อสลับลำดับไม่ใช่คำตอบเลย
การประเมินภาพปกแยกกันดีกว่าหรือการเปรียบเทียบเคียงข้างกันดีกว่า?
ในการทดสอบของเรา ทั้งสองวิธีมีความแม่นยำเท่ากันโดยเฉลี่ย ที่ 62.7% ความแตกต่างคือความเสถียร การประเมินภาพแต่ละภาพแยกกันให้ผลลัพธ์เดียวกันไม่ว่าคุณจะตรวจสอบในลำดับใด ในขณะที่การเปรียบเทียบเคียงข้างกันให้คำตอบที่เปลี่ยนไปตามลำดับในเกือบหนึ่งในสามของคู่
ทำไม AI ถึงดูมั่นใจในคำตอบของมันมากนัก?
เพราะน้ำเสียงมั่นใจคือรูปแบบเริ่มต้นของมัน ไม่ใช่การวัดค่า เมื่อถูกขอให้ประเมินความมั่นใจของตัวเอง โมเดลที่เราทดสอบแทบไม่เคยต่ำกว่า 70 จาก 100 และมักอ้าง 85 ขณะที่ตอบถูกจริงประมาณ 63% ของเวลา ในช่วงนี้ ความมั่นใจที่ระบุสูงขึ้นไม่ได้หมายความว่าคำตอบน่าเชื่อถือมากขึ้น
นี่หมายความว่าการทดสอบ A/B ภาพปกไม่มีประโยชน์หรือเปล่า?
ไม่ใช่ การทดสอบจริงแสดงภาพปกของคุณให้ผู้ชมจริงดูและวัดสิ่งที่พวกเขาทำ ซึ่งไม่มีการคาดการณ์ใดๆ สามารถแทนที่ได้ การทดลองนี้เกี่ยวข้องเฉพาะกับการถาม AI ให้เดาผู้ชนะล่วงหน้า สำหรับการทดสอบจริง คำถามที่ยากกว่าคือ ความแตกต่างที่คุณเห็นนั้นใหญ่กว่าความแปรปรวนปกติของช่องคุณจากอัปโหลดหนึ่งไปอีกอัปโหลดหนึ่งหรือไม่