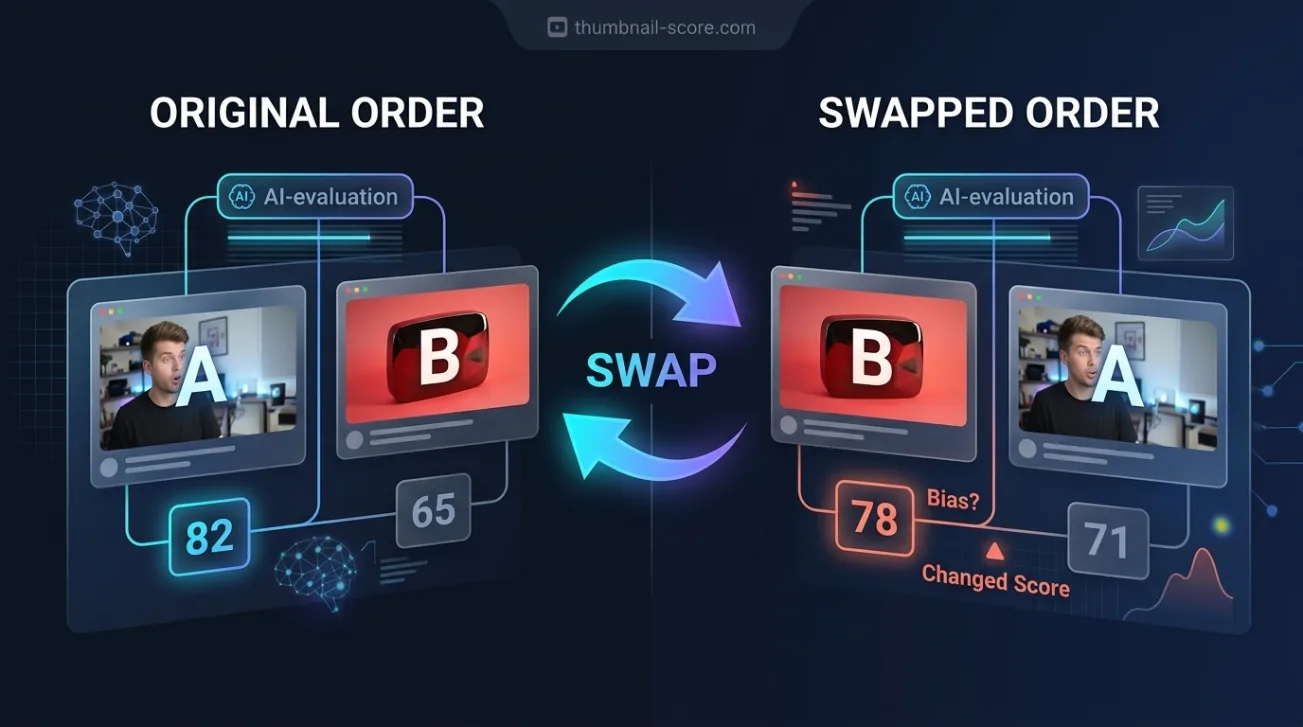
İki thumbnail’ı bir AI sohbetine yapıştırıp hangisinin daha fazla tıklanacağını sorduysanız, kontrolsüz bir deney yapmışsınızdır. Biz kontrolü olan bir deney yaptık: 161 gerçek video çifti, her çiftin zaten hangisinin daha iyi performans gösterdiğini biliyorduk ve her çifti AI’ya iki kez, her seferinde farklı sırayla gösterdik. AI’nın ilk gördüğü thumbnail, cevaplarının büyük bir kısmını belirledi.
Temel çıkarımlar
- Aynı kanaldan iki thumbnail gösterildiğinde, AI ilk geleni %64,7 oranında seçti. Konum tercihi olmayan bir jüri yaklaşık %50 civarında kalırdı.
- Gerçek kazanan ilk gösterildiğinde, AI %77,3 oranında doğru cevap verdi. Aynı kazanan ikinci gösterildiğinde ise bu oran %48,0 oldu.
- Her iki sırayı da ortalama aldığımızda, AI %62,7 oranında doğru cevap verdi — bu, her thumbnail’ı ayrı ayrı puanlayan skorla tam olarak aynıydı. Yan yana karşılaştırma doğruluk eklememişti.
- Sıra dışında hiçbir şey değişmediğinde, çiftlerin %30,7’sinde tam tersi cevaplar verdi.
- Çok nadiren şüphe ifade etti: tipik bir cevap %85 güven iddia ederken, model yaklaşık %63 oranında doğruydu.
AI, iki thumbnail arasından hangisinin daha iyi performans göstereceğini söyleyebilir mi?
Bazen, ancak tek bir cevaptan güvenilir şekilde yararlanamazsınız. Her iki sırayı da ortalama aldığımızda, test ettiğimiz model %62,7 oranında daha iyi performans gösteren thumbnail’ı seçti — bu, her thumbnail’ı ayrı ayrı puanlayan skorun elde ettiği oranla tam olarak aynıydı. Ancak seçimi, ilk gördüğü resme bağlıydı: kazanan ilk geldiğinde %77,3 doğru, ikinci geldiğinde %48,0 doğru.
Basitçe söylemek gerekirse, tek bir cevap, ilk seçeneğe daha sık düşen bir madeni para gibi davranır. Bilgi orada — model her iki yönde de aynı cevabı verdiğinde, şansın üzerinde doğru cevap verir — ancak bunu sadece iki kez sorduğunuzda keşfedersiniz.
Nasıl test ettik: bilinen cevaplı gerçek çiftler, her iki yönde de gösterildi
Çiftler, skor testimizden geldi: aynı kanaldan, yakın tarihlerde yayınlanan iki video — biri kanalın son zamanlardaki ortalamasını açıkça aştı, diğeri açıkça altında kaldı. Aynı kanalı kullanmak, abone sayısı, izleyici kitlesi ve üretim bütçesini iptal eder, böylece iki video arasındaki fark çoğunlukla paketlemede kalır.
Çalışmanın yarısındaki kanallardan gelen 161 çifti kullandık ve diğer yarısını dokunulmamış bıraktık. AI — skorumuzu çalıştıran aynı görsel model — her iki thumbnail’ı gerçek başlıklarıyla birlikte gördü, birinin kanalın normal izlenme sayısını aştığını, diğerinin altında kaldığını bildirildi ve hangisinin hangisi olduğunu sorduk. 322 cevaptan 11’i kullanılamaz çıktı, bu da her iki sırayla cevaplanan 150 çift bıraktı.
Neden her çift iki kez gösterilmeliydi
İki seçeneği karşılaştıran bir AI, içerikten bağımsız olarak bir konumu tercih edebilir — tıpkı bazı insanların bir listedeki ilk öğeyi tercih etmesi gibi. Eğer bu tercih varsa ve her çifti sadece bir şekilde gösteriyorsanız, bunu beceriden ayırt edemezsiniz: her zaman ilk resmi seçen bir jüri, daha iyi thumbnail rastgele ilk sıraya geldiğinde harika görünür.
Her çifti iki kez, sıraları değiştirilerek göstermek, ikisini de ayırır. Beceri, sırayı değiştirdiğinizde kalır. Konum tercihi ise onunla birlikte ters döner.
İlk gösterilen thumbnail, çoğu tartışmayı kazandı
300 cevap üzerinden, AI ilk gösterilen thumbnail’ı %64,7 oranında seçti. Bu tercih, tek bir cevabın değerini değiştirir:
| Çift nasıl gösterildi | AI gerçek kazananı ne sıklıkla seçti |
|---|---|
| Kazanan ilk gösterildi | %77,3 |
| Kazanan ikinci gösterildi | %48,0 |
| Her iki sırayı da ortalama | %62,7 |
| Her thumbnail’ı ayrı ayrı puanlayan skorumuz | %62,7 |
| Her iki sırayla da aynı doğru cevap | %47,3 (rastgele tahmin: yaklaşık %25) |
Ortalama satırı, her thumbnail’ı kendi başına puanlayan bir skorla adil bir karşılaştırma yapar, çünkü ikisi de çift başına bir cevap verir. Bu temelde iki yöntem %62,7 ile berabere kaldı. Yan yana karşılaştırma doğruluk eklemedi; sıraya bağımlılık ekledi.
Son satır daha katı bir testtir: cevap, AI’nın her iki seferde de aynı, doğru thumbnail’ı seçmesi durumunda geçerli sayılır. Rastgele tahmin yapan bir jüri bunu yaklaşık dörtte birinde geçer, her zaman ilk resmi seçen biri ise hiç geçemez. AI, çiftlerin %47,3’ünde bu testi geçti, yani sinyal gerçek — sadece konumla karışık.
Neredeyse üçte birinde fikrini değiştirdi
150 çiftin 46’sında, yani %30,7’sinde, AI sadece sıraya bağlı olarak tam tersi cevaplar verdi. Her iki thumbnail veya başlıkta iki soru arasında hiçbir şey değişmedi.
Diğer 104 çiftte tutarlıydı ve bu çiftlerde %68,3 oranında doğruydu. Aynı 104 çiftte skorumuz %63,5 oranında doğruydu. Bu fark, bu kadar çok çiftle kesin olarak söylemek için çok küçük, ancak faydalı bir yere işaret ediyor: sırayı değiştirdiğinizde aynı cevabı veren bir cevap, hiç test edilmemiş bir cevaptan daha değerlidir.
Güven rakamı bir olasılık değil
Her cevapla birlikte bir güven rakamı istedik ve AI’ya 50’nin bir madeni para atışı olduğunu söyledik. Ölçeğin alt yarısını neredeyse hiç kullanmadı. Tüm 300 cevap arasında en düşük belirtilen güven 65’ti, tipik bir cevap %85 iddia ediyordu ve sadece 4 cevap 70’in altında kaldı.
Bu arada, yaklaşık %63 oranında doğruydu. 80 ile 89 arasında puanladığı cevaplar %61,6 oranında doğruydu; 70 ile 79 arasında puanladığı cevaplar %63,5 oranında doğruydu. Neredeyse tüm cevaplarının düştüğü bu aralıkta, rakam hangi cevaplara inanacağınızı size hiçbir şey söylemiyordu.
90 veya üzeri puanladığı 17 cevap, %82,4 oranında doğruydu — bu ilham verici, ancak 17 çok azdır, güvenilir olmak için yeterli değil. Pratik okuma basittir: AI karşılaştırmasından gelen güvenli bir ton, varsayılan üslubudur, kanıt değil.
Herhangi bir AI thumbnail jürisini beş dakikada nasıl kontrol edersiniz
Bir modeli test ettik ve diğer araçlar farklı davranabilir. Bizim söylediğimizi kabul etmenize gerek yok, çünkü kontrolü kendiniz hızlıca yapabilirsiniz:
- Zaten cevabını bildiğiniz iki thumbnail seçin: kendi kanalınızdan, yakın tarihlerde yayınlanan iki geçmiş video — biri normal izlenme sayınızın açıkça üzerinde, diğeri açıkça altında.
- AI’ya hangisinin daha iyi performans gösterdiğini sorun, daha güçlü olanı ilk göstererek. Cevabını ve verdiği güveni not edin.
- İlk cevabını hatırlamaması için yeni bir konuşma başlatın ve sırayı ters çevirerek tekrar sorun.
- En az on çiftle tekrarlayın. Ne sıklıkla ilk geleni seçtiğini ve cevabının sırayı değiştirdiğinde ne sıklıkla aynı kaldığını sayın.
- Sadece sırayı değiştirdiğinde aynı kalan cevaplara güvenin ve güven rakamını tamamen yok sayın.
Eğer sunum sırasına hiç bağlı olmayan bir sayı istiyorsanız, her thumbnail ve başlığı ayrı ayrı puanlayabilirsiniz. Her seçeneğe ayrı bir skor vermek ve sonra karşılaştırmak, tercih edilecek ilk bir pozisyon bırakmaz.
Bu deneyin göstermediği şeyler
Bir modeli ve bir talimat setini test etti. Farklı bir model veya aynı modelin farklı sorulması, ilk pozisyonu daha fazla veya daha az tercih edebilir. Nokta, her AI’nın böyle davrandığı değil, kullandığınızın bunu yapmadığını tek bir karşılaştırma ile bile bilemeyeceğinizdir.
Çiftler, performanslarında keskin farklar olduğu için seçildi, bu yüzden bu doğruluk rakamları net kazançlarla net kayıpları karşılaştırır, neredeyse aynı performans gösteren iki thumbnail’ı değil. Her kanal kurulmuş ve İngilizceydi.
Bu hiçbiri gerçek A/B testiyle ilgili değil. Gerçek izleyiciler üzerinde yapılan bir test, o izleyicilerin gerçekten ne yaptığını ölçer. Bu deney, sadece bir AI’nın o sonucu önceden tahmin etmeye çalışmasıyla ilgilidir.
Sıkça sorulan sorular
AI bir sohbet botu, en iyi YouTube thumbnail’ı seçebilir mi?
Kısmen. Test ettiğimiz model, ortalama olarak %63 oranında daha iyi performans gösteren thumbnail’ı seçti — bu şansı yener ama her thumbnail’ı ayrı ayrı puanlamayı yenmez, onunla eşitlenir. Cevabı, ilk gördüğü resme çok bağlıydı, bu yüzden tek bir yanıt güvenilir değildir. Sırayı ters çevirerek iki kez sorun ve sadece sırayı değiştirdiğinde aynı kalan cevaplara güvenin.
AI karşılaştırmalarındaki konum yanlılığı nedir?
Konum yanlılığı, bir seçeneği içeriğinden ziyade nerede göründüğü nedeniyle tercih etme eğilimidir. Testimizde, AI ilk gösterilen thumbnail’ı %64,7 oranında seçti. Çözüm, her karşılaştırmayı iki yönde de sunmak ve sırayı değiştirdiğinde cevabı değişenleri hiç cevap olarak kabul etmemektir.
Thumbnail’ları ayrı ayrı puanlamak mı yoksa yan yana karşılaştırmak mı daha iyidir?
Testimizde, ortalama olarak iki yöntem de %62,7 doğrulukla eşitti. Fark, kararlılıkta kaldı. Her thumbnail’ı kendi başına puanlamak, hangi sırayla kontrol ederseniz edin aynı sonucu verirken, yan yana karşılaştırma, çiftlerin neredeyse üçte birinde sıraya göre değişen cevaplar üretti.
AI neden cevabına bu kadar emin görünüyor?
Çünkü güvenli ifade, onun varsayılan üslubudur, bir ölçüm değil. Kendi kesinliğini puanlamasını istediğimizde, test ettiğimiz model neredeyse hiç 100 üzerinden 70’in altına inmedi ve tipik olarak %85 iddia etti, oysa yaklaşık %63 oranında doğruydu. Bu aralıkta, daha yüksek belirtilen güven, daha güvenilir bir cevap anlamına gelmedi.
Bu, thumbnail A/B testlerinin gereksiz olduğu anlamına mı geliyor?
Hayır. Gerçek bir test, thumbnail’larınızı gerçek izleyicilere gösterir ve ne yaptıklarını ölçer — bu, hiçbir tahmin yerine geçemez. Bu deney, sadece bir AI’ya önceden kazananı tahmin etmesini sormakla ilgilidir. Gerçek bir test için daha zor soru, gördüğünüz farkın kanalınızın bir yüklemeden diğerine normal değişkenliğinden daha büyük olup olmadığıdır.