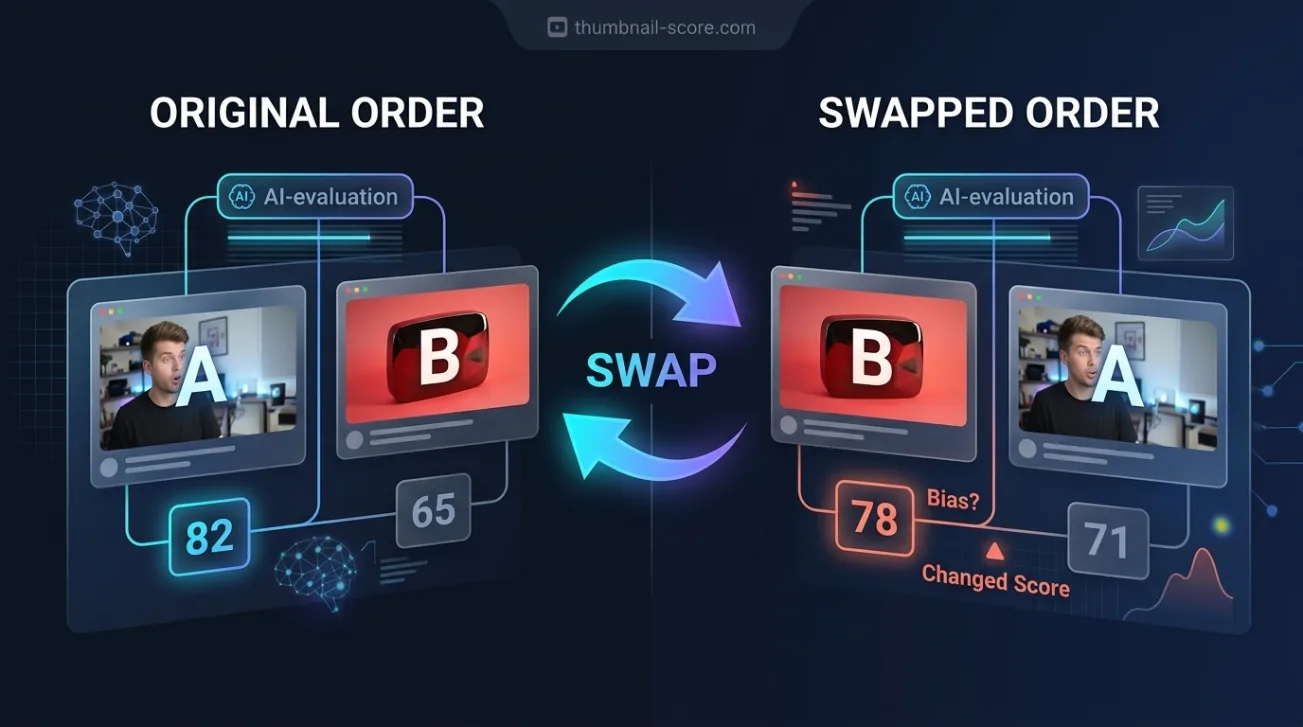
Wenn Sie jemals zwei Thumbnails in einen KI-Chat eingefügt und gefragt haben, welches mehr Klicks erzielen wird, haben Sie ein Experiment ohne Kontrolle durchgeführt. Wir haben es mit einer Kontrolle durchgeführt: 161 Paare realer Videos, bei denen wir bereits wussten, welches besser performte – jedes Paar wurde der KI zweimal gezeigt, einmal in jeder Reihenfolge. Welches Thumbnail sie zuerst sah, entschied einen großen Teil ihrer Antworten.
Wichtigste Erkenntnisse
- Bei zwei Thumbnails aus demselben Kanal wählte die KI dasjenige, das zuerst gezeigt wurde, in 64,7 % der Fälle. Ein Richter ohne Positionspräferenz würde bei etwa 50 % liegen.
- Wenn der echte Gewinner zufällig zuerst gezeigt wurde, lag die KI in 77,3 % der Fälle richtig. Wenn derselbe Gewinner zweitens gezeigt wurde, in 48,0 %.
- Im Durchschnitt beider Reihenfolgen lag sie in 62,7 % der Fälle richtig – genau wie ein Score, der jedes Thumbnail separat bewertet. Ein Seit-an-Seit-Vergleich brachte keine zusätzliche Genauigkeit.
- Sie gab bei 30,7 % der Paare entgegengesetzte Antworten, obwohl sich nichts außer der Reihenfolge änderte.
- Sie gab fast nie Zweifel zu: Eine typische Antwort behauptete 85 % Sicherheit, während das Modell tatsächlich nur etwa 63 % der Zeit richtig lag.
Kann eine KI Ihnen sagen, welches der beiden Thumbnails besser performen wird?
Manchmal – aber nicht auf eine Weise, der Sie auf Basis einer einzigen Antwort vertrauen können. Im Durchschnitt beider Reihenfolgen wählte das getestete Modell das besser performende Thumbnail in 62,7 % der Fälle – genau so oft wie unser Score, der jedes Thumbnail separat bewertete. Doch ihre Wahl hing davon ab, welches Bild sie zuerst sah: 77,3 % richtig, wenn der Gewinner zuerst kam, 48,0 %, wenn er zweitens kam.
Einfach ausgedrückt: Eine einzelne Antwort verhält sich wie eine Münze, die häufiger auf die erste Option fällt. Die Information ist vorhanden – wenn das Modell beide Male dieselbe Antwort gibt, liegt es öfter richtig als zufällig – aber Sie finden sie nur, wenn Sie zweimal fragen.
Wie wir es testeten: Reale Paare mit bekannter Antwort, in beiden Reihenfolgen gezeigt
Die Paare stammten aus unserem veröffentlichten Test des Scores: zwei Videos desselben Kanals, in kurzer Folge veröffentlicht, eines, das deutlich über dem aktuellen Kanaldurchschnitt lag, und eines, das deutlich darunter lag. Die Verwendung desselben Kanals gleicht Abonnentenzahl, Zielgruppe und Produktionsbudget aus, sodass sich die beiden hauptsächlich im Packaging unterscheiden.
Wir verwendeten die 161 Paare von der Hälfte der Studienkanäle und ließen die andere Hälfte unberührt. Die KI – dasselbe Vision-Modell, das unseren Score antreibt – erhielt beide Thumbnails mit ihren echten Titeln, wurde darüber informiert, dass eines die üblichen Aufrufe des Kanals übertroffen hatte und eines darunter lag, und gefragt, welches welches war. Elf der 322 Antworten waren unbrauchbar, sodass 150 Paare in beiden Reihenfolgen beantwortet wurden.
Warum jedes Paar zweimal gezeigt werden musste
Eine KI, die zwei Optionen vergleicht, kann eine Position unabhängig vom Inhalt bevorzugen – ähnlich wie manche Menschen den ersten Eintrag auf einer Liste bevorzugen. Wenn diese Präferenz existiert und Sie jedes Paar nur einmal in einer Reihenfolge zeigen, können Sie sie nicht von Fähigkeit unterscheiden: Ein Richter, der immer das erste Bild wählt, wirkt brillant, wenn zufällig das bessere Thumbnail zuerst aufgelistet ist.
Das zweimalige Zeigen jedes Paares mit vertauschter Reihenfolge trennt beides. Fähigkeit sollte den Tausch überstehen. Eine Positionspräferenz sollte sich mit ihr umkehren.
Das zuerst gezeigte Thumbnail gewann die meisten „Diskussionen“
Bei 300 Antworten wählte die KI dasjenige Thumbnail, das sie zuerst sah, in 64,7 % der Fälle. Diese Präferenz verändert den Wert jeder einzelnen Antwort:
| Wie das Paar gezeigt wurde | Wie oft die KI den echten Gewinner wählte |
|---|---|
| Gewinner zuerst gezeigt | 77,3 % |
| Gewinner zweitens gezeigt | 48,0 % |
| Durchschnitt beider Reihenfolgen | 62,7 % |
| Unser Score, Bewertung jedes Thumbnails separat | 62,7 % |
| Gleiche richtige Antwort in beiden Reihenfolgen | 47,3 % (zufällige Vermutung: etwa 25 %) |
Die Zeile „Durchschnitt“ ist der faire Vergleich mit einem Score, der jedes Thumbnail einzeln bewertet, da beide pro Paar eine Antwort geben. Auf dieser Grundlage waren beide Methoden mit 62,7 % gleichauf. Ein Seit-an-Seit-Vergleich brachte keine zusätzliche Genauigkeit – er fügte eine Abhängigkeit von der Reihenfolge hinzu.
Die letzte Zeile ist der strengere Test: Eine Antwort zählt nur, wenn die KI beide Male dasselbe, richtige Thumbnail wählte. Ein zufällig ratender Richter würde diesen Test etwa ein Viertel der Zeit bestehen, einer, der immer das erste Bild wählt, niemals. Die KI bestand ihn bei 47,3 % der Paare – das Signal ist also real, aber mit der Position verknüpft.
Sie änderte ihre Meinung bei fast einem Drittel der Paare
Bei 46 der 150 Paare, also 30,7 %, gab die KI abhängig von der Reihenfolge entgegengesetzte Antworten. An keinem der Thumbnails oder Titel hatte sich zwischen den beiden Fragen etwas geändert.
Bei den anderen 104 Paaren war sie konsistent und lag dabei in 68,3 % der Fälle richtig. Unser Score lag bei denselben 104 Paaren in 63,5 % der Fälle richtig. Diese Differenz ist bei dieser Anzahl von Paaren zu klein, um sicher zu sein, deutet aber auf etwas Nützliches hin: Eine Antwort, die den Tausch übersteht, ist wertvoller als eine, die nie getestet wurde.
Ihre Konfidenzangabe ist keine Wahrscheinlichkeit
Wir baten um eine Konfidenzangabe zu jeder Antwort und erklärten der KI, dass 50 einem Münzwurf entspricht. Sie nutzte kaum die untere Hälfte der Skala. Ihre niedrigste angegebene Konfidenz über alle 300 Antworten war 65, eine typische Antwort behauptete 85, und nur 4 Antworten lagen unter 70.
Gleichzeitig lag sie etwa 63 % der Zeit richtig. Antworten, die sie zwischen 80 und 89 bewertete, waren 61,6 % der Zeit richtig; Antworten zwischen 70 und 79 waren 63,5 % der Zeit richtig. Im gesamten Bereich, in dem fast alle ihre Antworten lagen, sagte die Zahl nichts darüber aus, welchen Antworten man vertrauen kann.
Die 17 Antworten, die sie mit 90 oder höher bewertete, waren 82,4 % der Zeit richtig – was vielversprechend ist, aber 17 sind zu wenig, um darauf zu vertrauen. Die praktische Lektüre ist einfach: Ein selbstbewusster Ton einer KI-Vergleichsantwort ist ihr Standardmodus, kein Beweis.
So überprüfen Sie jede KI-Thumbnail-Bewertung in fünf Minuten
Wir testeten ein Modell, und andere Tools können sich anders verhalten. Sie müssen uns kein Wort glauben, denn der Test lässt sich schnell selbst durchführen:
- Wählen Sie zwei Thumbnails, bei denen Sie bereits die Antwort kennen: zwei vergangene Videos Ihres eigenen Kanals, in kurzer Folge veröffentlicht, eines deutlich über Ihren üblichen Aufrufen und eines deutlich darunter.
- Fragen Sie die KI, welches besser performte, wobei das stärkere zuerst gezeigt wird. Notieren Sie ihre Antwort und jede Konfidenzangabe.
- Starten Sie ein neues Gespräch, damit sie sich an ihre erste Antwort nicht erinnern kann, und fragen Sie erneut mit umgekehrter Reihenfolge.
- Wiederholen Sie dies mit mindestens zehn Paaren. Zählen Sie, wie oft sie das Bild wählt, das zuerst kommt, und wie oft ihre Antwort den Tausch übersteht.
- Vertrauen Sie nur den Antworten, die den Tausch überstehen, und ignorieren Sie die Konfidenzangabe vollständig.
Wenn Sie lieber eine Zahl möchten, die überhaupt nicht von der Darstellungsreihenfolge abhängt, können Sie jedes Thumbnail und jeden Titel einzeln bewerten. Ein separater Score für jede Option, verglichen danach, hat keine erste Position, die bevorzugt werden könnte.
Was dieses Experiment nicht zeigt
Es testete ein Modell mit einem bestimmten Satz von Anweisungen. Ein anderes Modell oder dasselbe Modell mit anderen Fragen könnte die erste Position stärker oder schwächer bevorzugen. Der Punkt ist nicht, dass jede KI so wie diese hier funktioniert, sondern dass ein einzelner Vergleich nicht zeigen kann, ob die von Ihnen verwendete KI dies tut.
Die Paare wurden gewählt, weil sie sich deutlich in der Performance unterschieden – diese Genauigkeitszahlen beschreiben also klare Treffer gegen klare Fehlschläge, nicht zwei Thumbnails, die fast identisch performten. Jeder Kanal war etabliert und englischsprachig.
Und nichts davon betrifft echte Split-Tests. Ein Test mit echten Zuschauern misst, was diese Zuschauer tatsächlich taten. Dieses Experiment betrifft nur eine KI, die versucht, dieses Ergebnis im Voraus vorherzusagen.
Häufig gestellte Fragen
Kann ein KI-Chatbot das beste YouTube-Thumbnail auswählen?
Teilweise. Das von uns getestete Modell wählte das besser performende Thumbnail durchschnittlich etwa 63 % der Zeit – besser als Zufall, aber nicht besser als die Bewertung jedes Thumbnails separat. Ihre Antwort hing stark davon ab, welches Bild sie zuerst sah, daher ist eine einzelne Antwort unzuverlässig. Fragen Sie zweimal mit umgekehrter Reihenfolge und vertrauen Sie nur Antworten, die den Tausch überstehen.
Was ist Positionsverzerrung bei KI-Vergleichen?
Positionsverzerrung ist die Tendenz, eine Option aufgrund ihrer Position statt ihres Inhalts zu bevorzugen. In unserem Test wählte die KI dasjenige Thumbnail, das sie zuerst sah, in 64,7 % der Fälle. Die Abhilfe besteht darin, jeden Vergleich in beiden Reihenfolgen darzustellen und eine Antwort, die sich umdreht, als keine Antwort zu behandeln.
Ist es besser, Thumbnails einzeln zu bewerten oder sie nebeneinander zu vergleichen?
In unserem Test waren beide Methoden im Durchschnitt gleich genau, bei 62,7 %. Der Unterschied lag in der Stabilität. Die Bewertung jedes Thumbnails einzeln liefert dasselbe Ergebnis, unabhängig von der Reihenfolge, während der Seit-an-Seit-Vergleich bei fast einem Drittel der Paare Antworten erzeugte, die sich mit der Reihenfolge änderten.
Warum klingt die KI so sicher in ihrer Antwort?
Weil selbstbewusste Formulierungen ihr Standardmodus sind, keine Messung. Als wir sie aufforderten, ihre eigene Sicherheit einzuschätzen, ging das von uns getestete Modell fast nie unter 70 von 100 und behauptete typischerweise 85, während es etwa 63 % der Zeit richtig lag. Innerhalb dieses Bereichs bedeutete eine höhere angegebene Sicherheit nicht, dass die Antwort zuverlässiger war.
Bedeutet dies, dass Thumbnail-A/B-Tests sinnlos sind?
Nein. Ein echter Test zeigt Ihre Thumbnails echten Zuschauern und misst, was sie tun – etwas, das keine Vorhersage ersetzen kann. Dieses Experiment betrifft nur das Befragen einer KI, um den Gewinner im Voraus zu erraten. Für einen echten Test ist die schwierigere Frage, ob der beobachtete Unterschied größer ist als die normale Schwankung Ihres Kanals von einem Upload zum nächsten.