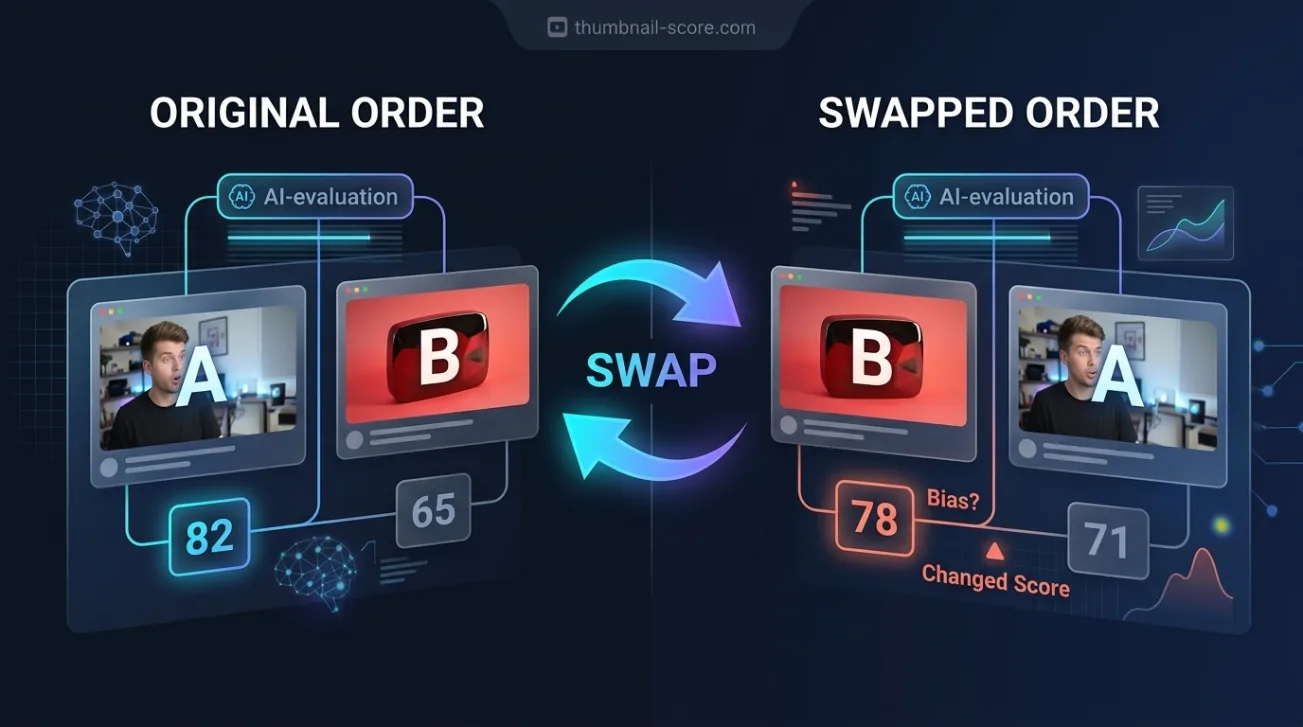
Jika Anda pernah menempelkan dua thumbnail ke dalam obrolan AI dan bertanya mana yang akan mendapat lebih banyak klik, Anda telah menjalankan eksperimen tanpa kontrol. Kami menjalankannya dengan kontrol: 161 pasang video nyata di mana kami sudah tahu mana yang performanya lebih baik, masing-masing pasang ditunjukkan ke AI dua kali, sekali dalam setiap urutan. Thumbnail yang pertama kali dilihat AI ternyata menentukan sebagian besar jawabannya.
Ringkasan utama
- Ketika diberi dua thumbnail dari saluran yang sama, AI memilih thumbnail yang muncul pertama sebanyak 64,7% dari waktu. Seorang penilai tanpa preferensi posisi akan berada di sekitar 50%.
- Ketika pemenang nyata kebetulan ditampilkan pertama, AI benar 77,3% dari waktu. Ketika pemenang yang sama ditampilkan kedua, 48,0%.
- Rata-rata dari kedua urutan, AI benar 62,7% dari waktu, tepat sama dengan skor yang menilai setiap thumbnail secara terpisah. Perbandingan samping-samping tidak menambah akurasi.
- IA memberikan jawaban berlawanan ketika hanya urutannya yang berubah pada 30,7% pasangan.
- IA hampir tidak pernah mengakui keraguan: jawaban khas mengklaim kepercayaan 85% sementara model benar sekitar 63% dari waktu.
Bisakah AI memberi tahu Anda mana dari dua thumbnail yang akan performa lebih baik?
Terkadang, tetapi tidak dengan cara yang bisa Anda percayai dari satu jawaban saja. Rata-rata dari kedua urutan, model yang kami uji memilih thumbnail dengan performa lebih baik 62,7% dari waktu — persis sebanyak skor kami yang menilai setiap thumbnail secara terpisah. Namun pilihannya bergantung pada gambar mana yang pertama kali dilihatnya: 77,3% benar ketika pemenang muncul pertama, 48,0% ketika muncul kedua.
Secara sederhana, satu jawaban berperilaku seperti koin yang jatuh pada opsi pertama lebih sering daripada tidak. Informasinya ada di sana — ketika model memberikan jawaban yang sama dari kedua arah, ia benar lebih sering daripada kebetulan — tetapi Anda hanya menemukannya dengan bertanya dua kali.
Cara kami mengujinya: pasangan nyata dengan jawaban yang diketahui, ditampilkan dari kedua arah
Pasangan-pasangan ini berasal dari uji coba kami yang telah diterbitkan terhadap skor: dua video dari saluran yang sama, dipublikasikan berdekatan, satu yang jelas mengungguli rata-rata terbaru saluran dan satu yang jelas jatuh di bawahnya. Menggunakan saluran yang sama membatalkan jumlah pelanggan, audiens, dan anggaran produksi, sehingga yang berbeda antara keduanya sebagian besar adalah kemasannya.
Kami menggunakan 161 pasangan dari setengah saluran dalam studi dan membiarkan setengah lainnya tidak tersentuh. AI — model visi yang sama yang menggerakkan skor kami — ditunjukkan kedua thumbnail beserta judul aslinya, diberi tahu bahwa satu telah melampaui tampilan biasa saluran dan satu lagi kurang, lalu ditanya mana yang mana. Sebelas dari 322 jawaban kembali tidak dapat digunakan, sehingga tersisa 150 pasangan yang dijawab dalam kedua urutan.
Mengapa setiap pasangan harus ditampilkan dua kali
AI yang membandingkan dua opsi dapat lebih menyukai satu posisi terlepas dari kontennya, sama seperti beberapa orang lebih menyukai item pertama dalam daftar. Jika preferensi itu ada dan Anda hanya menampilkan setiap pasangan satu kali, Anda tidak dapat membedakannya dari keterampilan: seorang penilai yang selalu memilih gambar pertama akan terlihat brilian setiap kali thumbnail yang lebih baik kebetulan terdaftar pertama.
Menampilkan setiap pasangan dua kali, dengan urutan ditukar, memisahkan keduanya. Keterampilan seharusnya bertahan setelah pertukaran. Preferensi posisi seharusnya berbalik bersamanya.
Thumbnail yang ditampilkan pertama memenangkan sebagian besar argumen
Dari 300 jawaban, AI memilih thumbnail mana pun yang ditunjukkan pertama sebanyak 64,7% dari waktu. Preferensi ini mengubah nilai setiap jawaban tunggal:
| Cara pasangan ditampilkan | Seberapa sering AI memilih pemenang nyata |
|---|---|
| Pemenang ditampilkan pertama | 77,3% |
| Pemenang ditampilkan kedua | 48,0% |
| Rata-rata dari kedua urutan | 62,7% |
| Skor kami, menilai setiap thumbnail secara terpisah | 62,7% |
| Jawaban benar yang sama dari kedua urutan | 47,3% (tebakan acak: sekitar 25%) |
Baris rata-rata adalah perbandingan adil dengan skor yang menilai setiap thumbnail secara mandiri, karena keduanya memberikan satu jawaban per pasangan. Dalam dasar itu, kedua metode seri di 62,7%. Perbandingan samping-samping tidak menambah akurasi; ia menambah ketergantungan pada urutan.
Baris terakhir adalah uji yang lebih ketat: jawaban dihitung hanya jika AI memilih thumbnail yang sama dan benar kedua kalinya. Seorang penilai yang menebak secara acak akan lulus sekitar seperempat waktu, dan yang selalu memilih gambar pertama tidak akan pernah lulus. AI lulus pada 47,3% pasangan, jadi sinyalnya nyata — hanya saja tercampur dengan posisi.
Ia mengubah pendiriannya pada hampir sepertiga pasangan
Pada 46 dari 150 pasangan, 30,7%, AI memberikan jawaban berlawanan hanya karena urutannya berubah. Tidak ada yang berubah tentang thumbnail atau judul antara dua pertanyaan tersebut.
Pada 104 pasangan lainnya, ia konsisten, dan pada pasangan itu ia benar 68,3% dari waktu. Skor kami, pada 104 pasangan yang sama, benar 63,5% dari waktu. Selisih itu terlalu kecil untuk dipastikan dengan jumlah pasangan ini, tetapi menunjukkan sesuatu yang berguna: jawaban yang bertahan setelah pertukaran bernilai lebih dari yang belum pernah diuji.
Angka kepercayaannya bukan probabilitas
Kami meminta angka kepercayaan untuk setiap jawaban dan memberi tahu AI bahwa 50 berarti lemparan koin. Ia hampir tidak menggunakan setengah bawah skala. Kepercayaan terendah yang dinyatakannya di seluruh 300 jawaban adalah 65, jawaban khas mengklaim 85, dan hanya 4 jawaban yang di bawah 70.
Sementara itu, ia benar sekitar 63% dari waktu. Jawaban yang dinilai antara 80 dan 89 benar 61,6% dari waktu; jawaban yang dinilai antara 70 dan 79 benar 63,5% dari waktu. Di seluruh rentang tempat hampir semua jawabannya jatuh, angka itu tidak memberi tahu Anda jawaban mana yang harus dipercaya.
17 jawaban yang dinilai 90 atau lebih tinggi benar 82,4% dari waktu, yang menunjukkan sesuatu, tetapi 17 terlalu sedikit untuk diandalkan. Bacaan praktisnya sederhana: nada percaya diri dari perbandingan AI adalah register defaultnya, bukan bukti.
Cara memeriksa setiap penilai thumbnail AI dalam lima menit
Kami menguji satu model, dan alat lain mungkin berperilaku berbeda. Anda tidak perlu mempercayai kata kami, karena pemeriksaannya cepat untuk dijalankan sendiri:
- Pilih dua thumbnail di mana Anda sudah tahu jawabannya: dua video lama dari saluran Anda sendiri, dipublikasikan berdekatan, satu jelas di atas tampilan biasa Anda dan satu jelas di bawahnya.
- Tanyakan ke AI mana yang performanya lebih baik, dengan yang lebih kuat ditampilkan pertama. Catat jawabannya dan kepercayaan apa pun yang diberikannya.
- Mulai percakapan baru, agar ia tidak bisa mengingat jawaban pertamanya, dan tanyakan lagi dengan urutan dibalik.
- Ulangi dengan setidaknya sepuluh pasangan. Hitung seberapa sering ia memilih gambar mana pun yang muncul pertama, dan seberapa sering jawabannya bertahan setelah pertukaran.
- Percayai hanya jawaban yang bertahan setelah pertukaran, dan abaikan angka kepercayaan sepenuhnya.
Jika Anda lebih suka angka yang sama sekali tidak bergantung pada urutan penyajian, Anda dapat menilai setiap thumbnail dan judul secara terpisah. Skor terpisah untuk setiap opsi, dibandingkan setelahnya, tidak memiliki posisi pertama untuk dipilih.
Apa yang tidak ditunjukkan eksperimen ini
Eksperimen ini menguji satu model dengan satu set instruksi. Model berbeda, atau model yang sama yang ditanyai secara berbeda, mungkin lebih atau kurang kuat memilih posisi pertama. Poinnya bukan bahwa setiap AI berperilaku seperti ini; melainkan bahwa satu perbandingan tidak dapat memberi tahu Anda apakah yang Anda gunakan memang seperti ini.
Pasangan-pasangan dipilih karena mereka berbeda tajam dalam performa, jadi angka akurasi ini menggambarkan pukulan jelas terhadap kegagalan jelas, bukan dua thumbnail yang performanya hampir identik. Setiap saluran sudah mapan dan berbahasa Inggris.
Dan tidak ada yang berkaitan dengan pengujian split nyata. Uji yang dijalankan pada penonton nyata mengukur apa yang benar-benar dilakukan penonton tersebut. Eksperimen ini hanya menyangkut AI yang mencoba memprediksi hasil itu sebelumnya.
Pertanyaan yang Sering Diajukan
Bisakah chatbot AI memilih thumbnail YouTube terbaik?
Sebagian. Model yang kami uji memilih thumbnail dengan performa lebih baik sekitar 63% dari waktu rata-rata, yang mengalahkan kebetulan tetapi cocok, bukan mengalahkan, penilaian setiap thumbnail secara terpisah. Jawabannya sangat bergantung pada gambar mana yang pertama kali dilihatnya, sehingga satu balasan tidak dapat diandalkan. Tanyakan dua kali dengan urutan dibalik, dan percayai hanya jawaban yang bertahan setelah pertukaran.
Apa itu bias posisi dalam perbandingan AI?
Bias posisi adalah kecenderungan untuk lebih menyukai opsi karena tempatnya muncul, bukan karena isinya. Dalam uji kami, AI memilih thumbnail mana pun yang ditunjukkan pertama sebanyak 64,7% dari waktu. Solusinya adalah menyajikan setiap perbandingan dalam kedua urutan dan menganggap jawaban yang berubah sebagai tidak ada jawaban sama sekali.
Lebih baik menilai thumbnail secara terpisah atau membandingkannya samping-samping?
Dalam uji kami, keduanya sama akurat rata-ratanya, di 62,7%. Perbedaannya adalah stabilitas. Menilai setiap thumbnail secara mandiri memberikan hasil yang sama terlepas dari urutan pemeriksaannya, sementara membandingkan samping-samping menghasilkan jawaban yang berubah dengan urutan pada hampir sepertiga pasangan.
Mengapa AI terdengar begitu yakin dengan jawabannya?
Karena frasa percaya diri adalah defaultnya, bukan pengukuran. Ketika diminta menilai kepastiannya sendiri, model yang kami uji hampir tidak pernah turun di bawah 70 dari 100 dan biasanya mengklaim 85, sementara benar sekitar 63% dari waktu. Dalam rentang itu, kepercayaan yang lebih tinggi tidak berarti jawaban yang lebih andal.
Apakah ini berarti pengujian A/B thumbnail tidak berguna?
Tidak. Uji nyata menunjukkan thumbnail Anda ke penonton nyata dan mengukur apa yang mereka lakukan, yang tidak bisa digantikan oleh prediksi apa pun. Eksperimen ini hanya menyangkut meminta AI menebak pemenang sebelumnya. Untuk uji nyata, pertanyaan yang lebih sulit adalah apakah perbedaan yang Anda lihat lebih besar daripada variasi normal saluran Anda dari satu unggahan ke unggahan berikutnya.