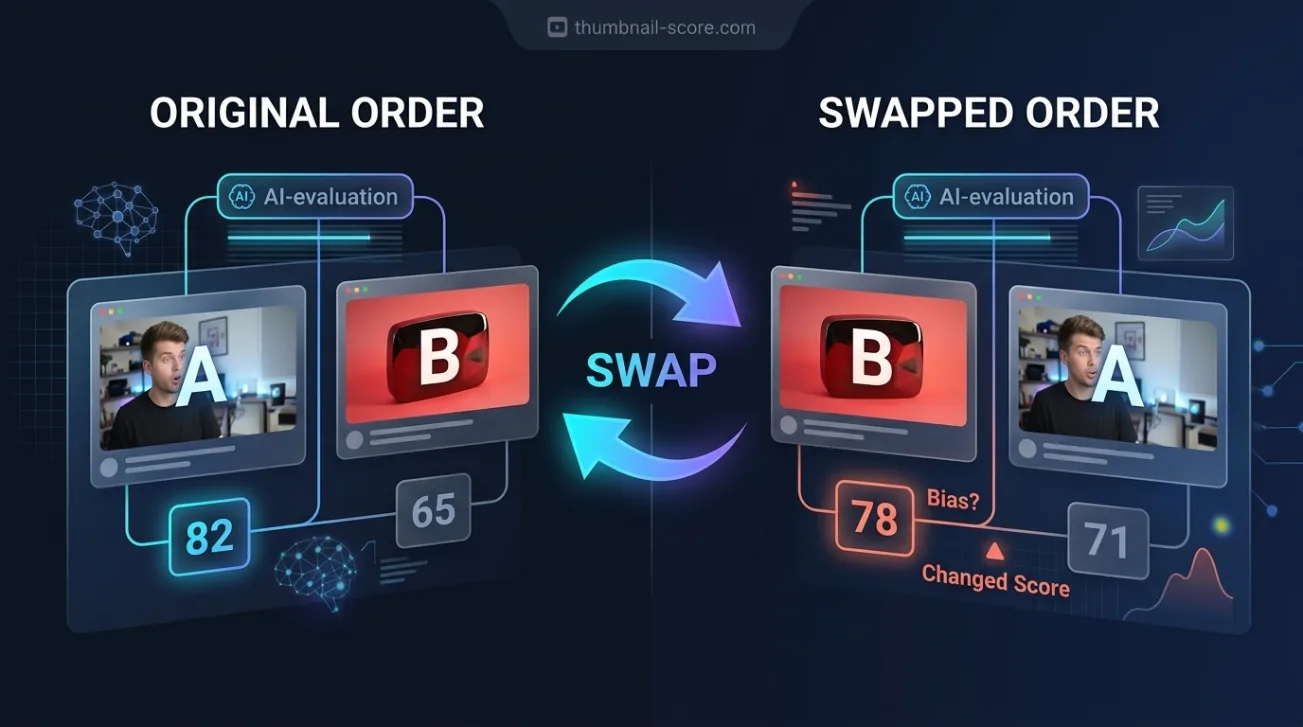
Si alguna vez has pegado dos miniaturas en un chat de IA y le has preguntado cuál obtendrá más clics, realizaste un experimento sin control. Nosotros lo hicimos con uno: 161 pares de videos reales donde ya sabíamos cuál tuvo mejor rendimiento, cada par mostrado a la IA dos veces, una en cada orden. Resultó que la miniatura que vio primero decidió una gran parte de sus respuestas.
Conclusiones clave
- Al mostrarle dos miniaturas del mismo canal, la IA eligió la que apareció primero el 64,7% de las veces. Un juez sin preferencia por la posición estaría cerca del 50%.
- Cuando el ganador real apareció primero, la IA acertó el 77,3% de las veces. Cuando el mismo ganador apareció segundo, el 48,0%.
- En promedio, en ambos órdenes, acertó el 62,7% de las veces, exactamente igual que una puntuación que califica cada miniatura por separado. Compararlas lado a lado no añadió precisión.
- Dio respuestas opuestas cuando solo cambió el orden en el 30,7% de los pares.
- Casi nunca admitió duda: una respuesta típica afirmaba un 85% de confianza, mientras que el modelo acertaba aproximadamente el 63% de las veces.
¿Puede una IA decirte cuál de dos miniaturas tendrá mejor rendimiento?
A veces, pero no de una manera en la que puedas confiar en una sola respuesta. En promedio, en ambos órdenes, el modelo que probamos eligió la miniatura con mejor rendimiento el 62,7% de las veces —exactamente igual que nuestra puntuación, que califica cada miniatura por separado. Pero su elección dependía de qué imagen vio primero: el 77,3% de aciertos cuando el ganador apareció primero, el 48,0% cuando apareció segundo.
Dicho simplemente, una sola respuesta se comporta como una moneda que cae más a menudo en la primera opción. La información está ahí —cuando el modelo da la misma respuesta en ambos sentidos, acierta más a menudo que al azar—, pero solo la descubres al preguntar dos veces.
Cómo lo probamos: pares reales con respuesta conocida, mostrados en ambos órdenes
Los pares provinieron de nuestra prueba publicada de la puntuación: dos videos del mismo canal, publicados cerca uno del otro, uno que claramente superó el promedio reciente del canal y otro que claramente quedó por debajo. Usar el mismo canal elimina el número de suscriptores, la audiencia y el presupuesto de producción, por lo que lo que difiere entre ambos es principalmente el empaque.
Usamos los 161 pares de la mitad de los canales del estudio y dejamos la otra mitad intacta. La IA —el mismo modelo de visión que impulsa nuestra puntuación— vio ambas miniaturas con sus títulos reales, se le dijo que una había superado las vistas habituales del canal y la otra había quedado por debajo, y se le preguntó cuál era cuál. Once de las 322 respuestas resultaron inutilizables, lo que dejó 150 pares respondidos en ambos órdenes.
Por qué cada par tuvo que mostrarse dos veces
Una IA que compara dos opciones puede preferir una posición independientemente del contenido, al igual que algunas personas prefieren el primer elemento de una lista. Si esa preferencia existe y solo muestras cada par de una manera, no puedes distinguirla de la habilidad: un juez que siempre elige la primera imagen parece brillante siempre que la miniatura mejor se liste primero.
Mostrar cada par dos veces, con el orden intercambiado, separa los dos factores. La habilidad debería sobrevivir al intercambio. Una preferencia por una posición debería invertirse con él.
La miniatura mostrada primero ganó la mayoría de los argumentos
En 300 respuestas, la IA eligió la miniatura que le mostraron primero el 64,7% de las veces. Esa preferencia cambia el valor de cualquier respuesta individual:
| Cómo se mostró el par | Con qué frecuencia la IA eligió al ganador real |
|---|---|
| Ganador mostrado primero | 77,3% |
| Ganador mostrado segundo | 48,0% |
| Promedio en ambos órdenes | 62,7% |
| Nuestra puntuación, calificando cada miniatura por separado | 62,7% |
| Misma respuesta correcta en ambos órdenes | 47,3% (adivinanza aleatoria: aproximadamente 25%) |
La fila del promedio es la comparación justa con una puntuación que califica cada miniatura por separado, porque ambas dan una respuesta por par. En ese terreno, ambos métodos empataron en el 62,7%. Compararlas lado a lado no añadió precisión; añadió una dependencia del orden.
La última fila es la prueba más estricta: una respuesta cuenta solo si la IA eligió la misma miniatura correcta ambas veces. Un juez que adivina al azar la pasaría aproximadamente una cuarta parte de las veces, y uno que siempre elige la primera imagen nunca la pasaría. La IA la pasó en el 47,3% de los pares, por lo que la señal es real —solo está enredada con la posición.
Cambió de opinión en casi un tercio de los pares
En 46 de los 150 pares, el 30,7%, la IA dio respuestas opuestas dependiendo solo del orden. Nada sobre ninguna de las miniaturas ni ninguno de los títulos cambió entre las dos preguntas.
En los otros 104 pares fue consistente, y en esos acertó el 68,3% de las veces. Nuestra puntuación, en esos mismos 104 pares, acertó el 63,5% de las veces. Esa diferencia es demasiado pequeña para estar seguros con esta cantidad de pares, pero apunta a algo útil: una respuesta que sobrevive al intercambio vale más que una que nunca ha sido probada.
Su número de confianza no es una probabilidad
Pedimos un número de confianza con cada respuesta y le dijimos a la IA que 50 significaba un lanzamiento de moneda. Apenas usó la mitad inferior de la escala. Su confianza más baja en las 300 respuestas fue 65, una respuesta típica afirmaba 85, y solo 4 respuestas estuvieron por debajo de 70.
Mientras tanto, acertó aproximadamente el 63% de las veces. Las respuestas que calificó entre 80 y 89 acertaron el 61,6% de las veces; las que calificó entre 70 y 79 acertaron el 63,5% de las veces. En el rango donde casi todas sus respuestas cayeron, el número no te decía nada sobre en qué respuestas confiar.
Las 17 respuestas que calificó 90 o más acertaron el 82,4% de las veces, lo cual es sugerente, pero 17 son demasiado pocas para confiar en ellas. La lectura práctica es simple: un tono confiado de una comparación de IA es su registro predeterminado, no evidencia.
Cómo verificar cualquier juez de miniaturas de IA en cinco minutos
Probamos un modelo, y otras herramientas pueden comportarse de manera diferente. No necesitas tomar nuestra palabra al respecto, porque la verificación es rápida de ejecutar tú mismo:
- Elige dos miniaturas donde ya sepas la respuesta: dos videos pasados de tu propio canal, publicados cerca uno del otro, uno claramente por encima de tus vistas habituales y otro claramente por debajo.
- Pregunta a la IA cuál tuvo mejor rendimiento, mostrando primero el más fuerte. Anota su respuesta y cualquier confianza que dé.
- Inicia una conversación nueva, para que no recuerde su primera respuesta, y pregunta de nuevo con el orden invertido.
- Repite con al menos diez pares. Cuenta cuántas veces elige la imagen que aparece primero y cuántas veces su respuesta sobrevive al intercambio.
- Confía solo en las respuestas que sobreviven al intercambio, e ignora completamente el número de confianza.
Si prefieres un número que no dependa en absoluto del orden de presentación, puedes calificar cada miniatura y título por separado. Una puntuación separada para cada opción, comparada después, no tiene una primera posición que preferir.
Lo que este experimento no muestra
Probó un modelo con un conjunto de instrucciones. Un modelo diferente, o el mismo modelo preguntado de manera distinta, podría preferir la primera posición con más o menos intensidad. El punto no es que toda IA se comporte así, sino que una sola comparación no puede decirte si la que estás usando lo hace.
Los pares se eligieron porque diferían notablemente en rendimiento, por lo que estas cifras de precisión describen aciertos claros contra fallos claros, no dos miniaturas que tuvieron rendimientos casi idénticos. Todos los canales eran establecidos y en inglés.
Y nada de esto trata sobre pruebas A/B reales. Una prueba realizada con espectadores reales mide lo que esos espectadores realmente hicieron. Este experimento solo concierne a una IA que intenta predecir ese resultado de antemano.
Preguntas frecuentes
¿Puede un chatbot de IA elegir la mejor miniatura de YouTube?
Parcialmente. El modelo que probamos eligió la miniatura con mejor rendimiento aproximadamente el 63% de las veces en promedio, lo cual supera el azar pero coincide en lugar de superar la calificación de cada miniatura por separado. Su respuesta dependía fuertemente de qué imagen vio primero, por lo que una sola respuesta es poco confiable. Pregunta dos veces con el orden invertido y confía solo en respuestas que sobrevivan al intercambio.
¿Qué es el sesgo de posición en comparaciones de IA?
El sesgo de posición es la tendencia a preferir una opción por su ubicación en lugar de su contenido. En nuestra prueba, la IA eligió la miniatura que le mostraron primero el 64,7% de las veces. La solución es presentar cada comparación en ambos órdenes y tratar una respuesta que cambia como si no hubiera respuesta.
¿Es mejor calificar las miniaturas por separado o compararlas lado a lado?
En nuestra prueba, ambos métodos fueron igual de precisos en promedio, con un 62,7%. La diferencia fue la estabilidad. Calificar cada miniatura por separado da el mismo resultado independientemente del orden en que las revises, mientras que compararlas lado a lado produjo respuestas que cambiaron con el orden en casi un tercio de los pares.
¿Por qué la IA suena tan segura de su respuesta?
Porque el lenguaje confiado es su predeterminado, no una medición. Al pedirle que calificara su propia certeza, el modelo que probamos casi nunca bajó de 70 de 100 y típicamente afirmó 85, mientras acertaba aproximadamente el 63% de las veces. Dentro de ese rango, una confianza declarada más alta no significaba una respuesta más confiable.
¿Significa esto que las pruebas A/B de miniaturas son inútiles?
No. Una prueba real muestra tus miniaturas a espectadores reales y mide lo que hacen, algo que ninguna predicción puede reemplazar. Este experimento solo concierne a pedirle a una IA que adivine el ganador de antemano. Para una prueba real, la pregunta más difícil es si la diferencia que ves es mayor que la variación normal de tu canal de una publicación a la siguiente.