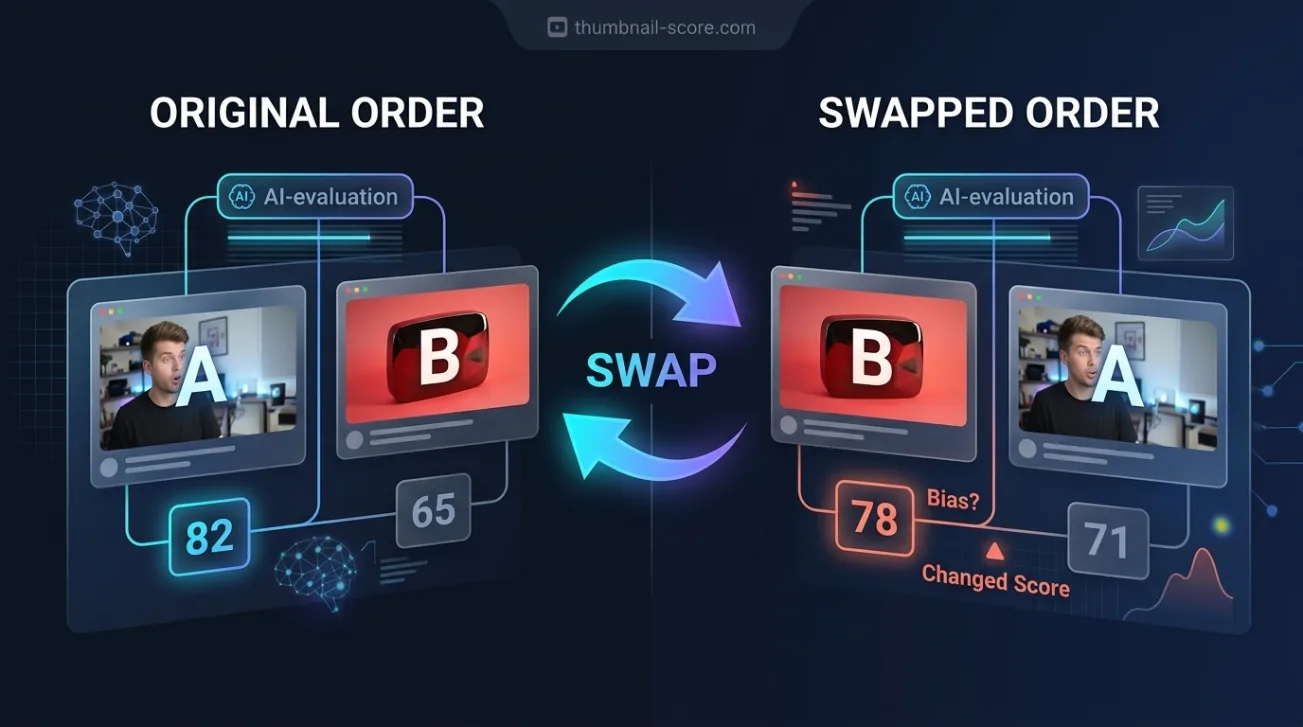
Si vous avez déjà collé deux miniatures dans un chat IA et demandé laquelle obtiendra le plus de clics, vous avez mené une expérience sans contrôle. Nous l’avons menée avec un contrôle : 161 paires de vidéos réelles dont nous connaissions déjà la meilleure performance, chaque paire présentée à l’IA deux fois, une fois dans chaque ordre. La miniature qu’elle voyait en premier déterminait une grande part de ses réponses.
Points clés
- Face à deux miniatures de la même chaîne, l’IA choisissait celle qui apparaissait en premier 64,7 % du temps. Un juge sans préférence de position se situerait près de 50 %.
- Lorsque le vrai gagnant était montré en premier, l’IA avait raison 77,3 % du temps. Lorsque le même gagnant était montré en second, 48,0 %.
- En moyenne sur les deux ordres, elle avait raison 62,7 % du temps, exactement comme un score qui évalue chaque miniature séparément. La comparaison côte à côte n’ajoutait aucune précision.
- Elle donnait des réponses opposées lorsque seul l’ordre changeait, sur 30,7 % des paires.
- Elle admettait presque jamais le doute : une réponse typique affirmait 85 % de confiance, alors que le modèle avait raison environ 63 % du temps.
Une IA peut-elle vous dire laquelle des deux miniatures obtiendra de meilleurs résultats ?
Parfois, mais pas d’une manière sur laquelle vous pouvez vous fier à partir d’une seule réponse. En moyenne sur les deux ordres, le modèle que nous avons testé a choisi la miniature la plus performante 62,7 % du temps — exactement aussi souvent que notre score, qui évalue chaque miniature séparément. Mais son choix dépendait de l’image qu’il voyait en premier : 77,3 % de bonnes réponses quand le gagnant était en premier, 48,0 % quand il était en second.
En termes simples, une seule réponse se comporte comme une pièce qui tombe plus souvent sur la première option. L’information est là — quand le modèle donne la même réponse dans les deux sens, il a plus souvent raison que par hasard — mais vous ne la trouvez qu’en posant la question deux fois.
Comment nous l’avons testé : paires réelles avec réponse connue, présentées dans les deux ordres
Les paires provenaient de notre test publié du score : deux vidéos de la même chaîne, publiées proches l’une de l’autre, l’une ayant clairement dépassé la moyenne récente du canal et l’autre ayant clairement échoué. Utiliser le même canal annule le nombre d’abonnés, l’audience et le budget de production, donc ce qui diffère entre les deux est principalement l’emballage.
Nous avons utilisé les 161 paires provenant de la moitié des chaînes de l’étude, en laissant l’autre moitié intacte. L’IA — le même modèle visuel qui alimente notre score — a vu les deux miniatures avec leurs titres réels, on lui a dit que l’une avait surpassé les vues habituelles du canal et l’autre avait sous-performé, et on lui a demandé lequel était lequel. Onze des 322 réponses étaient inutilisables, ce qui laissait 150 paires répondues dans les deux ordres.
Pourquoi chaque paire devait être montrée deux fois
Une IA comparant deux options peut préférer une position indépendamment du contenu, tout comme certaines personnes favorisent le premier élément d’une liste. Si cette préférence existe et que vous montrez chaque paire qu’une seule fois, vous ne pouvez pas la distinguer de la compétence : un juge qui choisit toujours la première image semble brillant chaque fois que la meilleure miniature se trouve en premier.
Montrer chaque paire deux fois, en inversant l’ordre, sépare les deux. La compétence devrait survivre à l’inversion. Une préférence pour une position devrait s’inverser avec elle.
La miniature montrée en premier a gagné la plupart des débats
Sur 300 réponses, l’IA a choisi la miniature qu’elle voyait en premier 64,7 % du temps. Cette préférence change la valeur de toute réponse unique :
| Comment la paire était présentée | Fréquence à laquelle l’IA a choisi le vrai gagnant |
|---|---|
| Gagnant montré en premier | 77,3 % |
| Gagnant montré en second | 48,0 % |
| Moyenne sur les deux ordres | 62,7 % |
| Notre score, évaluant chaque miniature séparément | 62,7 % |
| Même réponse correcte dans les deux ordres | 47,3 % (devinettes aléatoires : environ 25 %) |
La ligne moyenne est la comparaison équitable avec un score qui évalue chaque miniature individuellement, car les deux donnent une réponse par paire. Sur ce terrain, les deux méthodes sont à égalité à 62,7 %. La comparaison côte à côte n’a pas ajouté de précision ; elle a ajouté une dépendance à l’ordre.
La dernière ligne est le test plus strict : une réponse compte uniquement si l’IA choisit la même miniature correcte les deux fois. Un juge devinant au hasard réussirait environ un quart du temps, et un juge qui choisit toujours la première image n’y parviendrait jamais. L’IA a réussi sur 47,3 % des paires, donc le signal est réel — il est simplement mêlé à la position.
Elle a changé d’avis sur près d’un tiers des paires
Sur 46 des 150 paires, soit 30,7 %, l’IA a donné des réponses opposées uniquement en fonction de l’ordre. Rien concernant les miniatures ou les titres n’avait changé entre les deux questions.
Sur les 104 autres paires, elle était cohérente, et dans ces cas-là, elle avait raison 68,3 % du temps. Notre score, sur ces mêmes 104 paires, avait raison 63,5 % du temps. Cet écart est trop faible pour être significatif avec ce nombre de paires, mais il pointe vers quelque chose d’utile : une réponse qui survit à l’inversion vaut plus qu’une réponse jamais testée.
Son chiffre de confiance n’est pas une probabilité
Nous avons demandé un chiffre de confiance avec chaque réponse et dit à l’IA que 50 signifiait un pile ou face. Elle a à peine utilisé la moitié inférieure de l’échelle. Sa confiance la plus basse sur les 300 réponses était de 65, une réponse typique affirmait 85, et seulement 4 réponses étaient inférieures à 70.
Entre-temps, elle avait raison environ 63 % du temps. Les réponses qu’elle notait entre 80 et 89 étaient justes 61,6 % du temps ; celles notées entre 70 et 79 étaient justes 63,5 % du temps. Sur la plage où presque toutes ses réponses tombaient, le chiffre ne vous disait rien sur lesquelles croire.
Les 17 réponses qu’elle notait 90 ou plus étaient justes 82,4 % du temps, ce qui est suggestif, mais 17 est trop peu pour s’y fier. La lecture pratique est simple : un ton confiant d’une comparaison IA est son registre par défaut, pas une preuve.
Comment vérifier n’importe quel juge IA de miniatures en cinq minutes
Nous avons testé un modèle, et d’autres outils peuvent se comporter différemment. Vous n’avez pas besoin de nous croire sur parole, car le test est rapide à exécuter vous-même :
- Choisissez deux miniatures dont vous connaissez déjà la réponse : deux vidéos passées de votre propre chaîne, publiées proches l’une de l’autre, l’une clairement au-dessus de vos vues habituelles et l’autre clairement en dessous.
- Demander à l’IA laquelle a mieux performé, en montrant la plus forte en premier. Notez sa réponse et toute confiance qu’elle donne.
- Démarrez une nouvelle conversation, afin qu’elle ne se souvienne pas de sa première réponse, et demandez à nouveau en inversant l’ordre.
- Répétez avec au moins dix paires. Comptez combien de fois elle choisit l’image qui vient en premier, et combien de fois sa réponse survit à l’inversion.
- Ne faites confiance qu’aux réponses qui survivent à l’inversion, et ignorez complètement le chiffre de confiance.
Si vous préférez un chiffre qui ne dépend pas de l’ordre de présentation, vous pouvez noter chaque miniature et titre séparément. Un score distinct pour chaque option, comparé ensuite, n’a aucune première position à favoriser.
Ce que cette expérience ne montre pas
Elle a testé un modèle avec un jeu d’instructions. Un modèle différent, ou le même modèle interrogé différemment, pourrait préférer la première position plus ou moins fortement. Le point n’est pas que chaque IA se comporte comme celle-ci ; c’est qu’une seule comparaison ne peut pas vous dire si celle que vous utilisez le fait.
Les paires ont été choisies parce qu’elles différaient fortement en performance, donc ces chiffres de précision décrivent des coups clairs contre des ratés clairs, pas deux miniatures ayant presque la même performance. Chaque chaîne était établie et en anglais.
Et rien de tout cela ne concerne les tests A/B réels. Un test mené sur de vrais spectateurs mesure ce que ces spectateurs ont réellement fait. Cette expérience concerne uniquement une IA essayant de prédire ce résultat à l’avance.
Questions fréquentes
Une IA peut-elle choisir la meilleure miniature YouTube ?
Partiellement. Le modèle que nous avons testé a choisi la miniature la plus performante environ 63 % du temps en moyenne, ce qui bat le hasard mais correspond plutôt qu’il ne bat l’évaluation de chaque miniature séparément. Sa réponse dépendait fortement de l’image qu’elle voyait en premier, donc une seule réponse est peu fiable. Posez la question deux fois en inversant l’ordre, et ne faites confiance qu’aux réponses qui survivent à l’inversion.
Qu’est-ce que le biais de position dans les comparaisons IA ?
Le biais de position est une tendance à préférer une option en raison de sa position plutôt que de son contenu. Dans notre test, l’IA choisissait la miniature qu’elle voyait en premier 64,7 % du temps. Le remède est de présenter chaque comparaison dans les deux ordres et de considérer qu’une réponse qui change n’est pas une réponse du tout.
Est-il préférable d’évaluer les miniatures séparément ou de les comparer côte à côte ?
Dans notre test, les deux méthodes étaient également précises en moyenne, à 62,7 %. La différence était la stabilité. Évaluer chaque miniature séparément donne le même résultat quel que soit l’ordre dans lequel vous les vérifiez, tandis que la comparaison côte à côte produisait des réponses qui changeaient avec l’ordre sur près d’un tiers des paires.
Pourquoi l’IA semble-t-elle si sûre de sa réponse ?
Parce que le langage confiant est son registre par défaut, pas une mesure. Lorsqu’on lui a demandé d’évaluer sa propre certitude, le modèle que nous avons testé est presque jamais descendu en dessous de 70 sur 100 et affirmait typiquement 85, alors qu’il avait raison environ 63 % du temps. Dans cette plage, une confiance déclarée plus élevée ne signifiait pas une réponse plus fiable.
Cela signifie-t-il que les tests A/B de miniatures sont inutiles ?
Non. Un test réel montre vos miniatures à de vrais spectateurs et mesure ce qu’ils font, ce que aucune prédiction ne remplace. Cette expérience concerne uniquement le fait de demander à une IA de deviner le gagnant à l’avance. Pour un test réel, la question plus difficile est de savoir si la différence que vous voyez est plus grande que la variation normale de votre chaîne d’un upload à l’autre.