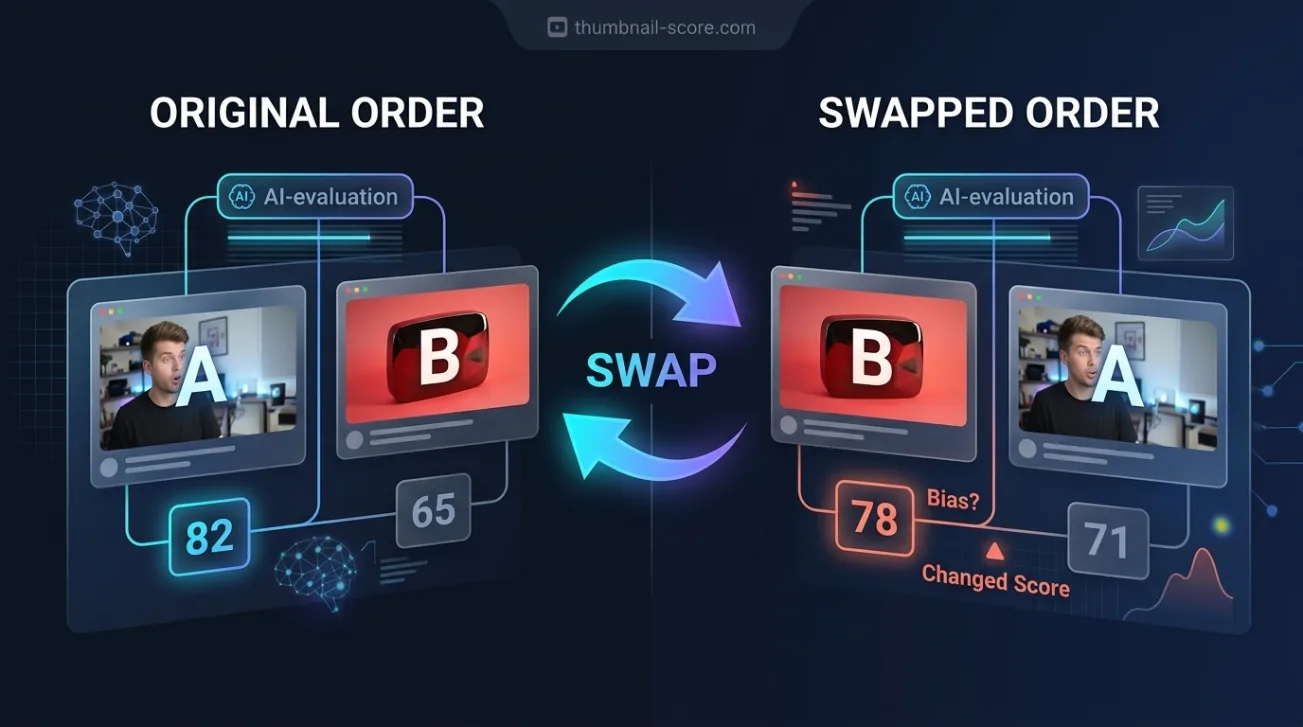
Jeśli kiedykolwiek wkleiłeś dwie miniaturki do czatu z AI i zapytałeś, która uzyska więcej kliknięć, przeprowadziłeś eksperyment bez kontroli. My przeprowadziliśmy go z kontrolą: 161 par rzeczywistych filmów, gdzie już wiedzieliśmy, który miał lepszy wynik, każda para pokazana AI dwa razy — raz w każdej kolejności. Okazało się, że to, która miniaturka pojawiła się pierwsza, decydowało o dużej części jej odpowiedzi.
Kluczowe wnioski
- Pokazując dwie miniaturki z tego samego kanału, AI wybierała tę, która pojawiła się pierwsza, w 64,7% przypadków. Sędzia bez preferencji pozycyjnych osiągnąłby wynik bliski 50%.
- Gdy rzeczywisty zwycięzca był pokazywany jako pierwszy, AI miała rację w 77,3% przypadków. Gdy ten sam zwycięzca był pokazywany jako drugi — w 48,0%.
- Średnio, po obu kolejnościach, miała rację w 62,7% przypadków — dokładnie tyle samo, co nasz wynik oceniający każdą miniaturkę osobno. Porównanie obok siebie nie dodało dokładności.
- Na 30,7% par dawała przeciwne odpowiedzi, gdy jedyną zmianą była kolejność.
- Niezwykle rzadko przyznawała się do wątpliwości: typowa odpowiedź deklarowała 85% pewności, podczas gdy model miał rację około 63% czasu.
Czy AI może powiedzieć, która z dwóch miniatur będzie lepiej działać?
Czasem, ale nie w sposób, na który można polegać po jednej odpowiedzi. Średnio po obu kolejnościach, model, który testowaliśmy, wybierał lepiej działającą miniaturkę w 62,7% przypadków — dokładnie tak często, jak nasz wynik, który ocenia każdą miniaturkę osobno. Ale jego wybór zależał od tego, którą miniaturkę zobaczył najpierw: 77,3% poprawnych odpowiedzi, gdy zwycięzca był pierwszy, i 48,0%, gdy był drugi.
Prościej mówiąc, jedna odpowiedź zachowuje się jak moneta, która częściej wypada na pierwszą opcję. Informacja tam jest — gdy model daje tę samą odpowiedź obiema kolejnościami, ma rację częściej niż przypadkiem — ale odkrywasz ją tylko, pytając dwa razy.
Jak to przetestowaliśmy: rzeczywiste pary z znaną odpowiedzią, pokazane obiema kolejnościami
Pary pochodziły z naszego opublikowanego testu wyniku: dwa filmy z tego samego kanału, opublikowane blisko siebie, jeden wyraźnie przewyższający średnią kanału, a drugi wyraźnie ją nie osiągający. Użycie tego samego kanału eliminuje liczbę subskrybentów, publiczność i budżet produkcji, więc to, co się różni, to głównie pakowanie.
Użyliśmy 161 par z połowy kanałów z badania, pozostawiając drugą połowę nietkniętą. AI — ten sam model wizyjny, który napędza nasz wynik — zobaczyła obie miniaturki z ich rzeczywistymi tytułami, z informacją, że jedna przewyższyła średnią wyświetleń kanału, a druga ją nie osiągnęła, i została poproszona o wskazanie, która jest która. 11 z 322 odpowiedzi okazało się nieprzydatnych, co pozostawiło 150 par odpowiedzianych w obu kolejnościach.
Dlaczego każda para musiała być pokazana dwa razy
AI porównująca dwie opcje może preferować jedną pozycję niezależnie od treści, podobnie jak niektórzy ludzie preferują pierwszy element na liście. Jeśli taka preferencja istnieje, a pokazujesz każdą parę tylko w jednej kolejności, nie możesz jej odróżnić od umiejętności: sędzia, który zawsze wybiera pierwsze zdjęcie, wygląda świetnie, gdy lepsza miniaturka przypadkowo jest na pierwszym miejscu.
Pokazanie każdej pary dwa razy, z zamienioną kolejnością, oddziela te dwa czynniki. Umiejętność powinna przetrwać zamianę. Preferencja pozycyjna powinna się odwrócić.
Miniaturka pokazana jako pierwsza wygrała większość sporów
W 300 odpowiedziach AI wybierała tę miniaturkę, którą zobaczyła najpierw, w 64,7% przypadków. Ta preferencja zmienia wartość każdej pojedynczej odpowiedzi:
| Jak para była pokazywana | Jak często AI wybrała rzeczywistego zwycięzcę |
|---|---|
| Zwycięzca pokazany jako pierwszy | 77,3% |
| Zwycięzca pokazany jako drugi | 48,0% |
| Średnio po obu kolejnościach | 62,7% |
| Nasz wynik, oceniający każdą miniaturkę osobno | 62,7% |
| Ta sama poprawna odpowiedź w obu kolejnościach | 47,3% (losowe zgadywanie: około 25%) |
Wiersz „średnio” to sprawiedliwe porównanie z wynikiem oceniającym każdą miniaturkę osobno, ponieważ oba dają jedną odpowiedź na parę. W tym ujęciu obie metody zremisowały na 62,7%. Porównanie obok siebie nie dodało dokładności — dodało zależność od kolejności.
Ostatni wiersz to surowszy test: odpowiedź liczy się tylko wtedy, gdy AI wybrała tę samą, poprawną miniaturkę obiema kolejnościami. Sędzia losowo zgadujący przejdzie ten test około ćwierci razy, a ten, który zawsze wybiera pierwsze zdjęcie, nigdy go nie przejdzie. AI przeszła go w 47,3% par, więc sygnał jest realny — po prostu splątany z pozycją.
Zmieniała zdanie w prawie jednej trzeciej par
W 46 z 150 par, czyli w 30,7%, AI dawała przeciwne odpowiedzi wyłącznie w zależności od kolejności. Nic w żadnej miniaturce ani tytule nie zmieniło się między dwoma pytaniami.
W pozostałych 104 parach była spójna, a w tych miała rację w 68,3% przypadków. Nasz wynik, na tych samych 104 parach, miał rację w 63,5% przypadków. Ta różnica jest zbyt mała, by można było być pewnym przy tej liczbie par, ale wskazuje na coś przydatnego: odpowiedź, która przetrwa zamianę, jest wartą więcej niż ta, której nigdy nie testowano.
Jego liczba pewności nie jest prawdopodobieństwem
Poprosiliśmy o liczbę pewności przy każdej odpowiedzi i powiedzieliśmy AI, że 50 oznacza rzut monetą. Ledwo używała dolnej połowy skali. Najniższa deklarowana pewność we wszystkich 300 odpowiedziach wyniosła 65, typowa odpowiedź deklarowała 85, a tylko 4 odpowiedzi były poniżej 70.
W międzyczasie miała rację około 63% czasu. Odpowiedzi, które oceniła między 80 a 89, były poprawne w 61,6% przypadków; te ocenione między 70 a 79 — w 63,5% przypadków. W zakresie, w którym prawie wszystkie jej odpowiedzi się znajdowały, liczba nic nie mówiła o tym, którym odpowiedziom można ufać.
17 odpowiedzi, które oceniła na 90 lub więcej, były poprawne w 82,4% przypadków — co sugeruje, ale 17 to zbyt mała liczba, by na niej polegać. Praktyczna interpretacja jest prosta: pewny ton z AI to jego domyślny tryb, nie dowód.
Jak sprawdzić dowolnego sędziego miniatur AI w pięć minut
Testowaliśmy jeden model, a inne narzędzia mogą się zachowywać inaczej. Nie musisz wierzyć nam na słowo, ponieważ test można szybko przeprowadzić samemu:
- Wybierz dwie miniaturki, gdzie już znasz odpowiedź: dwa poprzednie filmy z własnego kanału, opublikowane blisko siebie, jeden wyraźnie powyżej Twojej średniej liczby wyświetleń, a drugi wyraźnie poniżej.
- Zapytaj AI, która lepiej działała, pokazując silniejszą jako pierwszą. Zanotuj jej odpowiedź i jakąkolwiek pewność, którą poda.
- Rozpocznij nową rozmowę, aby AI nie pamiętało swojej pierwszej odpowiedzi, i zapytaj ponownie z zamienioną kolejnością.
- Powtórz to z co najmniej dziesięcioma parami. Policz, jak często wybiera obrazek, który pojawia się pierwszy, i jak często jej odpowiedź przetrwa zamianę.
- Ufaj tylko odpowiedziom, które przetrwają zamianę, i całkowicie zignoruj liczbę pewności.
Jeśli wolisz liczbę, która w ogóle nie zależy od kolejności prezentacji, możesz ocenić każdą miniaturkę i tytuł osobno. Oddzielny wynik dla każdej opcji, porównany później, nie ma pierwszej pozycji do preferowania.
Co ten eksperyment nie pokazuje
Testował jeden model z jednym zestawem instrukcji. Inny model, lub ten sam model z innym pytaniem, mógłby silniej lub słabiej preferować pierwszą pozycję. Chodzi nie o to, że każde AI zachowuje się tak jak to — ale o to, że pojedyncze porównanie nie może Ci powiedzieć, czy to, którego używasz, tak właśnie działa.
Pary zostały wybrane, ponieważ różniły się wyraźnie pod względem wyników, więc te liczby dokładności opisują wyraźne trafienia przeciwko wyraźnym pudłom, a nie dwie miniaturki, które działały niemal identycznie. Każdy kanał był ugruntowany i w języku angielskim.
I żadna z tych rzeczy nie dotyczy rzeczywistego testowania A/B. Test przeprowadzony na rzeczywistych widzach mierzy, co ci widzowie faktycznie zrobili. Ten eksperyment dotyczy tylko AI próbującego przewidzieć ten wynik z wyprzedzeniem.
Często zadawane pytania
Czy chatbot AI może wybrać najlepszą miniaturkę na YouTube?
Częściowo. Model, który testowaliśmy, wybierał lepiej działającą miniaturkę około 63% czasu średnio, co pokonuje losowość, ale równa się — a nie pokonuje — ocenie każdej miniaturki osobno. Jego odpowiedź silnie zależała od tego, którą miniaturkę zobaczył najpierw, więc jedna odpowiedź jest niezawodna. Zapytaj dwa razy z zamienioną kolejnością i ufaj tylko odpowiedziom, które przetrwają zamianę.
Co to jest błąd pozycyjny w porównaniach AI?
Błąd pozycyjny to tendencja do preferowania opcji ze względu na jej położenie, a nie zawartość. W naszym teście AI wybierała tę miniaturkę, którą zobaczyła najpierw, w 64,7% przypadków. Lekarstwem jest pokazywanie każdego porównania w obu kolejnościach i traktowanie odpowiedzi, która się odwraca, jako braku odpowiedzi.
Czy lepiej oceniać miniaturki osobno, czy porównywać je obok siebie?
W naszym teście obie metody były równie dokładne średnio — 62,7%. Różnica polegała na stabilności. Ocena każdej miniaturki osobno daje ten sam wynik niezależnie od kolejności, podczas gdy porównanie obok siebie dawało odpowiedzi zmieniające się wraz z kolejnością w prawie jednej trzeciej par.
Dlaczego AI brzmi tak pewnie w swojej odpowiedzi?
Ponieważ pewne sformułowanie to jego domyślny tryb, a nie pomiar. Poproszeni o ocenę własnej pewności, model, który testowaliśmy, niemal nigdy nie opuszczał 70 na 100 i zwykle deklarował 85, podczas gdy miał rację około 63% czasu. W tym zakresie wyższa deklarowana pewność nie oznaczała bardziej niezawodnej odpowiedzi.
Czy to oznacza, że testowanie A/B miniatur jest bezużyteczne?
Nie. Rzeczywisty test pokazuje Twoje miniaturki rzeczywistym widzom i mierzy, co oni zrobili — czego żadne przewidywanie nie zastąpi. Ten eksperyment dotyczy tylko pytania AI o zgadnięcie zwycięzcy z wyprzedzeniem. Dla rzeczywistego testu trudniejsze pytanie brzmi, czy różnica, którą widzisz, jest większa niż normalna zmienność Twojego kanału z jednego uploadu na drugi.