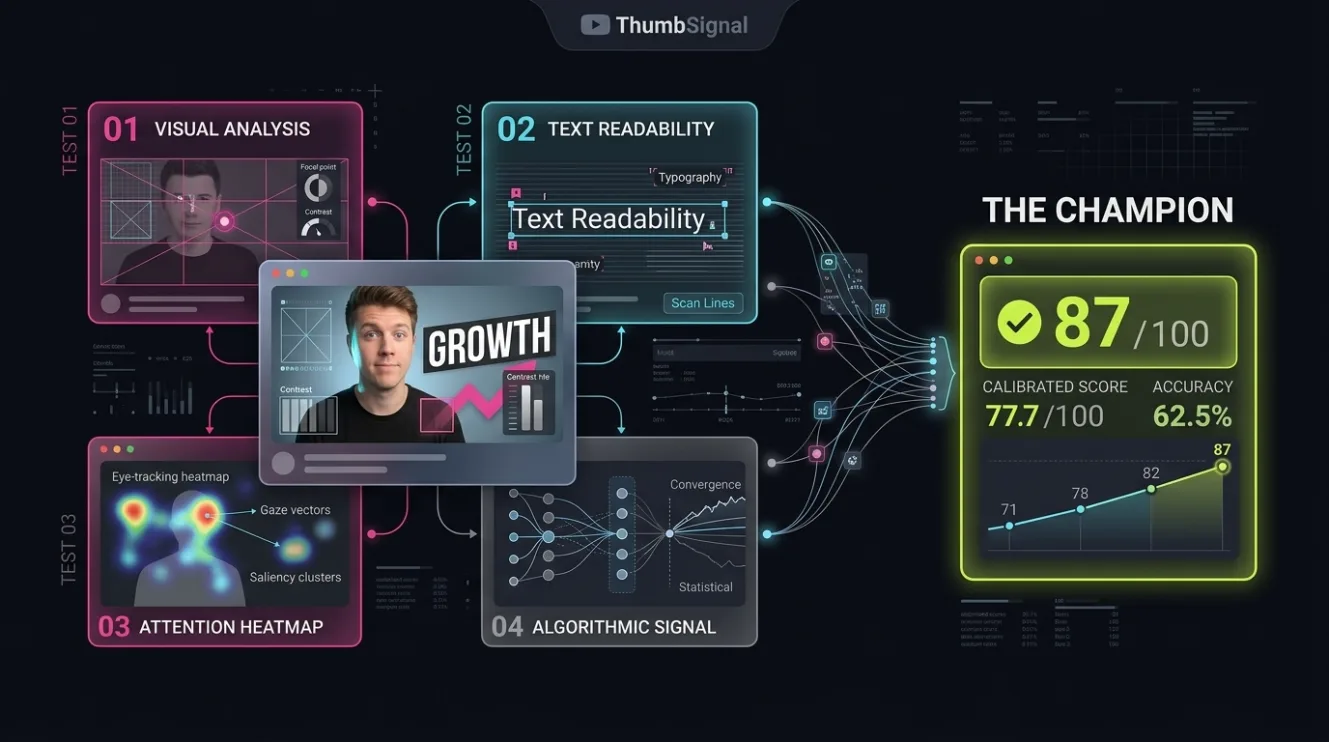
หลังจากทดสอบคะแนนภาพปกของเราเทียบกับวิดีโอจริง 321 คู่ เราพยายามทำให้มันแม่นยำยิ่งขึ้น เราลองสี่สิ่ง หนึ่งในนั้นทำให้ตัวเลขเปลี่ยนไป และเมื่อตรวจสอบแล้ว พบว่าเป็นการวัดที่ยุติธรรมกว่า ไม่ใช่โมเดลที่ดีขึ้น อีกสามอย่างไม่ได้เปลี่ยนอะไร หรือทำให้คะแนนน่าเชื่อถือน้อยลง นี่คือแต่ละอย่าง พร้อมตัวเลข
ข้อสรุปสำคัญ
- การเปรียบเทียบคะแนนด้วยความแม่นยำเต็มรูปแบบ แทนที่จะปัดเป็นจำนวนเต็ม ทำให้ความแม่นยำที่วัดได้เพิ่มจาก 59.5% เป็น 62.0% และทั้งหมดนี้มาจาก 17 กรณีที่เคยเสมอกัน ซึ่งแตกออกอย่างสมดุล
- คำแนะนำการให้คะแนนที่เขียนใหม่ ดูเหมือนจะเป็นก้าวสำคัญเมื่อทดสอบกับภาพปก 30 ภาพ แต่ไม่ได้ผลเมื่อทดสอบกับ 322 ภาพ: 64.6% ก่อน และ 63.4% หลัง บน 161 คู่
- การให้ AI เปรียบเทียบภาพปกสองภาพแบบตัวต่อตัว ให้ผลลัพธ์เฉลี่ยเท่ากับคะแนนปกติ คือ 62.7% ทั้งสองฝ่าย แต่คำตอบขึ้นอยู่กับภาพที่ปรากฏก่อน
- การตั้งค่า "เหตุผล" ของโมเดลไม่ได้เปลี่ยนอะไร เว้นแต่ในระดับสูงสุด ซึ่งไม่เคยให้คำตอบในภูมิภาคยุโรปที่เราใช้เพื่อให้แน่ใจว่าอัปโหลดอยู่ใน EU
- ผลลัพธ์ที่เผยแพร่และลงทะเบียนล่วงหน้า ยังคงอยู่ที่ 59.5% ทุกอย่างที่นี่เป็นงานติดตามผลและระบุไว้ชัดเจน
สามารถทำให้คะแนนภาพปกแม่นยำขึ้นหลังจากทดสอบแล้วได้หรือไม่?
ไม่ง่ายนัก ในกรณีของเรา จากสี่การเปลี่ยนแปลงที่เราทดสอบกับวิดีโอจริง หนึ่งอย่างทำให้ความแม่นยำที่วัดได้เพิ่มขึ้น จาก 59.5% เป็น 62.0% โดยการแก้ไขวิธีเปรียบเทียบคะแนน ไม่ใช่การให้โมเดลเห็นสิ่งใหม่ อีกสามอย่างไม่เปลี่ยนความแม่นยำ คะแนนดูเหมือนจะใกล้เคียงสิ่งที่โมเดลนี้สามารถทำได้
นี่เป็นคำตอบที่น่าตื่นเต้นน้อยกว่าการสร้างสถิติใหม่ แต่มีประโยชน์มากกว่า มันบอกว่าควรใช้ความพยายามที่ไหน และอธิบายว่าทำไมไอเดียที่น่าดึงดูดแต่ละอย่างจึงล้มเหลว สิ่งนี้มีความสำคัญเกินกว่าคะแนนนี้เพียงอย่างเดียว เพราะกับดักเดียวกันนี้จะจับครีเอเตอร์ที่ทดสอบภาพปกของตัวเอง
การแก้ไขที่ได้ผล: หยุดปัดเลขก่อนเปรียบเทียบ
คะแนนที่คุณเห็นคือจำนวนเต็มตั้งแต่ 0 ถึง 100 ในทดสอบเดิม วิดีโอสองอันในคู่หนึ่งมักจะได้คะแนนเต็มเท่ากัน และเกิดขึ้น 17 ครั้งจาก 321 คู่ กฎที่เราลงทะเบียนล่วงหน้า นับทุกกรณีที่เสมอกันว่าเป็นความล้มเหลว โดยอ้างว่าคะแนนที่ไม่สามารถแยกแยะวิดีโอสองอันได้ ย่อมไม่ได้แยกแยะระหว่างพวกมัน
เบื้องหลังจำนวนเต็มคือค่าที่แม่นยำ และการปัดเลขจะทิ้งความแตกต่างนั้นทิ้งไป การเปรียบเทียบค่าที่แม่นยำไม่เหลือกรณีเสมอกันเลย และความแม่นยำที่วัดได้เพิ่มจาก 59.5% เป็น 62.0%: 199 จาก 321 คู่ แทนที่จะเป็น 191 ไม่มีวิดีโอใดถูกให้คะแนนใหม่ และไม่มีน้ำหนักใดเปลี่ยนแปลง ค่าที่แม่นยำนั้นมีอยู่แล้ว
ทำไมนี่จึงเป็นตัวเลขที่ยุติธรรมกว่า ไม่ใช่โมเดลที่ดีกว่า
คำถามที่ชัดเจนคือ 17 กรณีที่เสมอกันนั้น ตัดสินอย่างไร หากโมเดลได้คำตอบถูกต้องอยู่แล้ว แต่การปัดเลขซ่อนทักษะที่แท้จริง แต่ไม่ใช่ 8 จาก 17 ไปยังวิดีโอที่ทำผลงานดีกว่า และอีก 9 ไม่ได้ ซึ่งใกล้เคียงกับผลจากการโยนเหรียญ
ดังนั้น ผลลัพธ์ที่ได้มาจากการไม่ถือว่าการโยนเหรียญเป็นความล้มเหลวโดยอัตโนมัติ ไม่ใช่เพราะโมเดลรู้มากขึ้น นี่คือเหตุผลที่ผลลัพธ์ที่เผยแพร่ยังคงอยู่ที่ 59.5%: มันคือตัวเลขที่เราตกลงไว้ล่วงหน้า ภายใต้กฎที่เขียนก่อนที่เราจะเห็นข้อมูลใดๆ 62.0% ถูกรายงานเป็นการวัดติดตามผล ระบุชัดเจน และอธิบายโมเดลเดียวกัน
การปรับคำแนะนำ: ต้นแบบเล็กๆ ที่ดูเหมือนก้าวสำคัญ
คะแนนของโมเดลรวมกันเป็นกลุ่ม หลายปัจจัยจาก สิบสองปัจจัยที่คะแนนสร้างขึ้นจาก อยู่ในช่วงแคบๆ บนภาพปกจริงหลายร้อยภาพ และการทดสอบเดิมของเราแสดงว่า คะแนนเชื่อถือได้ที่สุดเมื่อมันวางวิดีโอสองอันให้อยู่ห่างกันมาก ดังนั้นเราจึงเขียนคำแนะนำใหม่เพื่อให้สเกลมีจุดอ้างอิง: 50 หมายถึงวิดีโอทั่วไปในฟีดเดียวกัน 90 ขึ้นไปสงวนไว้สำหรับ 10% บนสุด
ในการทดสอบต้นแบบกับภาพปก 30 ภาพ ที่ให้คะแนนภายใต้เวอร์ชันทั้งสอง ดูเหมือนจะได้ผล แปดจากสิบสองปัจจัยกระจายออก และสองปัจจัยมีการกระจายเพิ่มขึ้นเกือบสองเท่า จากนั้นเราจึงรันคำแนะนำใหม่กับภาพปก 322 ภาพ ปัจจัยสองอย่างที่เคยเพิ่มขึ้นเกือบสองเท่า ขยายเพียง 1.1 และ 0.1 คะแนนเท่านั้น บน 161 คู่ คำแนะนำเดิมเลือกวิดีโอที่ดีกว่าได้ 64.6% ของเวลา และคำแนะนำใหม่ได้ 63.4% ซึ่งต่างกันอยู่ในขอบเขตของความบังเอิญ รุ่นใหม่ยังลดคะแนนเกือบทุกอันลง 5-7 คะแนน ดังนั้นจะทำให้ครีเอเตอร์ทุกคนเสียคะแนนไปโดยไม่ได้อะไร
ทำไมการกระจายมากขึ้นจึงไม่ได้หมายถึงความแม่นยำมากขึ้น
ต้นแบบนั้นเล็กเกินไป ด้วยภาพปก 30 ภาพ การวัดว่าคะแนนกระจายแค่ไหนจะแกว่งไปมากด้วยความบังเอิญ และการที่ปัจจัยสองอย่างเพิ่มขึ้นเป็นสองเท่าอยู่ในช่วงนั้น ต้นแบบควรอ่านว่าเป็นเหตุผลที่จะรันการทดสอบขนาดใหญ่ขึ้น ไม่ใช่ผลลัพธ์
การรันขนาดใหญ่ยังมีบทเรียนที่สอง ปัจจัยสองอย่าง คือ ความอยากรู้อยากเห็น และความเสี่ยงของคลิกเบต กระจายออกจริงๆ บนภาพปก 322 ภาพ แต่อันดับยังไม่ดีขึ้น การให้คะแนนที่กว้างขึ้นจะช่วยได้ก็ต่อเมื่อความกว้างเพิ่มเติมตามความแตกต่างจริงระหว่างวิดีโอ ที่นี่มันตามเสียงรบกวน และเสียงรบกวนที่ดูเหมือนความมั่นใจ แย่กว่าไม่มีเลย
การเปรียบเทียบภาพปกแบบตัวต่อตัว แทนที่จะให้คะแนนแยกกัน
การให้คะแนนภาพปกแต่ละอันแล้วเปรียบเทียบตัวเลข ไม่ใช่วิธีที่คนเลือกภาพปก; พวกเขาดูสองภาพเคียงข้างกัน ดังนั้นเราจึงขอให้โมเดลทำเช่นนั้น: เมื่อแสดงวิดีโอทั้งสองจากคู่หนึ่ง วิดีโอไหนทำผลงานดีกว่า? แต่ละคู่จาก 161 คู่ ถูกแสดงสองครั้ง ครั้งละลำดับหนึ่ง
เฉลี่ยจากทั้งสองลำดับ ผู้ตัดสินแบบตัวต่อตัวถูกต้อง 62.7% ของเวลา เท่ากับคะแนนปกติบนคู่ที่ตอบครบ 150 คู่ แต่มันเลือกภาพที่เห็นก่อน 64.7% ของเวลา และสำหรับเกือบหนึ่งในสามของคู่ มันให้คำตอบตรงข้ามกันเพียงเพราะลำดับ ความแม่นยำเท่ากันแต่เสถียรภาพน้อยกว่า หมายความว่าไม่ได้รับการยอมรับ ผลลัพธ์เต็มอยู่ในบทความแยกของเราเกี่ยวกับการขอให้ AI เปรียบเทียบภาพปก
เปิดโหมดเหตุผลของโมเดล
โมเดลเสนอการตั้งค่าที่ทำให้มันคิดผ่านปัญหาทีละขั้นตอนก่อนตอบ ที่หลายระดับของความพยายาม ที่สามระดับล่างสุด การวิเคราะห์เต็มรูปแบบของภาพปกทดสอบกลับมาพร้อมกับคะแนนสิบสองอันเหมือนเดิมเมื่อปิดการตั้งค่านี้ ระดับสูงสุดเท่านั้นที่เปลี่ยนพฤติกรรมของโมเดล
ในศูนย์ข้อมูลยุโรปที่เราใช้ เพื่อให้แน่ใจว่าภาพปกที่อัปโหลดไม่เคยถูกประมวลผลนอก EU ระดับสูงสุดนี้ไม่เคยให้คำตอบ แม้หลังจากพยายามซ้ำๆ นานถึงสามนาที เราตรวจสอบแล้วว่ามันทำงานได้ในภูมิภาคสหรัฐฯ โดยใช้คำถามคณิตศาสตร์สมมุติที่ไม่เกี่ยวข้องกับภาพปก และพบว่ามันเขียนเหตุผลเป็นข้อความธรรมดาหน้าคำตอบ แทนที่จะเก็บแยกต่างหาก การย้ายอัปโหลดไปยังสหรัฐฯ เพื่อหาว่ามันช่วยหรือไม่ ไม่ใช่การแลกเปลี่ยนที่เราเต็มใจจะทำ
ผลลัพธ์ทั้งสี่ข้างเคียงกัน
แต่ละการเปลี่ยนแปลงถูกเปรียบเทียบกับต้นฉบับบนคู่เดียวกัน ดังนั้นความแตกต่างทั้งหมดด้านล่างนี้จึงเปรียบเทียบกันได้
| การเปลี่ยนแปลง | สิ่งที่มันทำกับความแม่นยำในการจัดอันดับ | ยังใช้หรือไม่ |
|---|---|---|
| เปรียบเทียบคะแนนที่ไม่ปัด | 59.5% เป็น 62.0% บน 321 คู่ ทั้งหมดมาจากกรณีที่เคยเสมอกัน ซึ่งแตกออกอย่างสมดุล | ใช่ เป็นการวัดที่ยุติธรรมกว่า |
| คำแนะนำการให้คะแนนที่ปรับเทียบแล้ว | 64.6% เป็น 63.4% บน 161 คู่ ไม่มีความแตกต่างที่ตรวจจับได้ | ไม่ใช่ |
| เปรียบเทียบภาพปกแบบตัวต่อตัว | 62.7% เทียบกับ 62.7% บน 150 คู่ พร้อมคำตอบที่ขึ้นอยู่กับลำดับ | ไม่ใช่ |
| โหมดเหตุผลของโมเดล | ไม่มีการเปลี่ยนแปลงที่ระดับที่ทำงาน; ระดับสูงสุดไม่เคยตอบในภูมิภาคของเรา | ไม่ใช่ |
ตัวเลขทั้งหมดที่นี่มาจากช่องทางการให้คะแนนเดียวกันที่ทำงานเมื่อคุณ วิเคราะห์ภาพปกและชื่อ การทดสอบให้คะแนนวิดีโอจริงผ่านผลิตภัณฑ์เอง ไม่ใช่ผ่านสำเนาการวิจัยแยกต่างหาก
เราทำให้การทดสอบติดตามผลเหล่านี้ซื่อสัตย์อย่างไร
การทดลองติดตามผลคือจุดที่การศึกษาส่วนใหญ่มักผิดพลาด เพราะนักวิจัยรู้อยู่แล้วว่าพวกเขาอยากได้คำตอบแบบไหน กฎห้าข้อช่วยควบคุมสิ่งนี้:
- ผลลัพธ์ที่เผยแพร่ไม่เคยถูกแตะต้อง 59.5% ที่ลงทะเบียนล่วงหน้ายังคงเป็นหัวข้อข่าว และการวิเคราะห์ทุกอย่างต่อมาถูกระบุว่าเป็นงานติดตามผล
- ช่องทางถูกแบ่งครึ่งก่อนทดสอบการเปลี่ยนแปลงใดๆ การทดลองใช้ครึ่งหนึ่ง และอีกครึ่งถูกเก็บไว้สำหรับการตรวจสอบสุดท้าย
- แต่ละการเปลี่ยนแปลงถูกเปรียบเทียบกับต้นฉบับบนคู่เดียวกัน โดยนับเฉพาะคู่ที่ทั้งสองไม่เห็นด้วยกัน ซึ่งไวต่อการเปลี่ยนแปลงมากกว่าการเปรียบเทียบเปอร์เซ็นต์โดยรวมสองค่า
- ต้นแบบเล็กๆ ถือว่าเป็นเหตุผลที่จะรันการทดสอบขนาดใหญ่ ไม่ใช่ผลลัพธ์ในตัวเอง
- การเปรียบเทียบแบบตัวต่อตัวทุกครั้งถูกแสดงในทั้งสองลำดับ เพื่อไม่ให้ความชอบตำแหน่งผ่านเป็นทักษะ
ไม่มีข้อใดต้องใช้ปริญญาด้านสถิติ และส่วนใหญ่สามารถนำไปใช้กับครีเอเตอร์ที่ทดสอบภาพปกของตัวเองได้: ตัดสินใจก่อนว่าอะไรถือว่าเป็นชัยชนะ เปรียบเทียบสิ่งที่เหมือนกัน และถือว่าผลลัพธ์ต้นแบบเล็กๆ เป็นเหตุผลที่จะทดสอบต่อไป
ข้อจำกัดของผลลัพธ์ติดตามผลเหล่านี้
การทดลองทั้งสี่ใช้ช่องทางภาษาอังกฤษที่มีอยู่แล้วเหมือนการทดสอบเดิม และโมเดลเดียวกัน ไอเดียเหล่านี้ถูกเลือกหลังจากทราบผลลัพธ์เดิม ซึ่งเป็นสถานการณ์ที่มักทำให้ผลลัพธ์ดูดีขึ้น และเป็นอีกเหตุผลหนึ่งที่หัวข้อข่าวยังคงอยู่ที่ตัวเลขที่ลงทะเบียนล่วงหน้า
แต่ละการเปลี่ยนแปลงถูกลองเพียงครั้งเดียว ในรูปแบบเดียว คำแนะนำที่ใช้คำต่างกันอาจได้ผลดีกว่า และผลลัพธ์ของโหมดเหตุผลอธิบายสิ่งที่มีอยู่ในภูมิภาคหนึ่งในเดือนกันยายน 2026 ไม่มีผลลัพธ์ใดบอกว่าคะแนนไม่สามารถปรับปรุงได้; มันบอกว่าสี่เส้นทางนี้ไม่ได้ปรับปรุงมัน
คำถามที่พบบ่อย
ทำไมไม่รายงาน 62.0% เป็นความแม่นยำ?
เพราะกฎของการทดสอบถูกกำหนดไว้ก่อนที่จะมีข้อมูลใดๆ และนับกรณีเสมอกันว่าเป็นความล้มเหลว การเปลี่ยนกฎหลังจากเห็นผลลัพธ์ คือสิ่งที่การลงทะเบียนล่วงหน้ามีไว้เพื่อป้องกัน แม้การเปลี่ยนแปลงนั้นจะสมเหตุสมผล 62.0% ถูกเผยแพร่เป็นการวัดติดตามผลที่ระบุชัดเจน อยู่ข้าง 59.5% ที่มันไม่ได้แทนที่
AI โมเดลที่ฉลาดกว่าจะทำให้คะแนนแม่นยำขึ้นไหม?
อาจเป็นไปได้ แต่นั่นจะเป็นการทดลองใหม่ การตั้งค่าเหตุผลของโมเดลปัจจุบันของเราไม่ได้ช่วยในภูมิภาคที่เราใช้ และโมเดลต่างๆ จะต้องถูกทดสอบกับคู่เดียวกัน ด้วยวิธีเดียวกัน ก่อนที่จะสามารถอ้างสิ่งใดได้ ใหม่กว่าไม่ได้หมายความว่าดีกว่าโดยอัตโนมัติในงานเฉพาะนี้
ทำไมการทดสอบบนภาพปก 30 ภาพถึงดูน่าเชื่อถือมาก?
ตัวอย่างเล็กๆ ผลิตการแกว่งตัวขนาดใหญ่ด้วยความบังเอิญ และการแกว่งตัวขนาดใหญ่ดูเหมือนการค้นพบ ด้วยภาพปก 30 ภาพ การที่ปัจจัยสองอย่างดูเหมือนจะเพิ่มการกระจายเป็นสองเท่า อยู่ในความแปรปรวนปกติ; ที่ภาพปก 322 ภาพ ผลนั้นแทบจะหายไป มันเป็นกับดักเดียวกันกับการตัดสินรูปแบบภาพปกใหม่จากอัปโหลดสองครั้ง
สิ่งนี้หมายความว่าอย่างไรกับการทดสอบภาพปกของฉันเอง?
กฎเดียวกันใช้ได้ ตัดสินใจก่อนว่าอะไรถือว่าเป็นความสำเร็จ เปรียบเทียบกับช่วงปกติของช่องทางคุณ แทนที่จะเป็นวิดีโอเดิมเพียงอันเดียว รันตัวอย่างให้เพียงพอที่ความบังเอิญไม่สามารถอธิบายผลลัพธ์ได้ และถ้าคุณขอเครื่องมือใดๆ เปรียบเทียบตัวเลือกสองอย่าง ตรวจสอบว่าคำตอบยังคงอยู่เมื่อสลับตำแหน่ง
คะแนนยังคุ้มค่าที่จะใช้หรือไม่ หากการปรับปรุงเหล่านี้ล้มเหลว?
คะแนนถูกทดสอบกับผลลัพธ์จริงและเอาชนะความบังเอิญด้วยระยะห่างที่ชัดเจน การติดตามผลเหล่านี้แสดงว่าสี่การเปลี่ยนแปลงที่น่าดึงดูดไม่ได้ผลักดันมันไปไกลกว่านี้ ซึ่งมีประโยชน์ในการรู้ ไม่ใช่เหตุผลที่จะทิ้งมัน ถือว่ามันเป็นข้อมูลเชิงลึกหนึ่งในหลายอย่าง ไม่ใช่การคาดการณ์จำนวนวิว