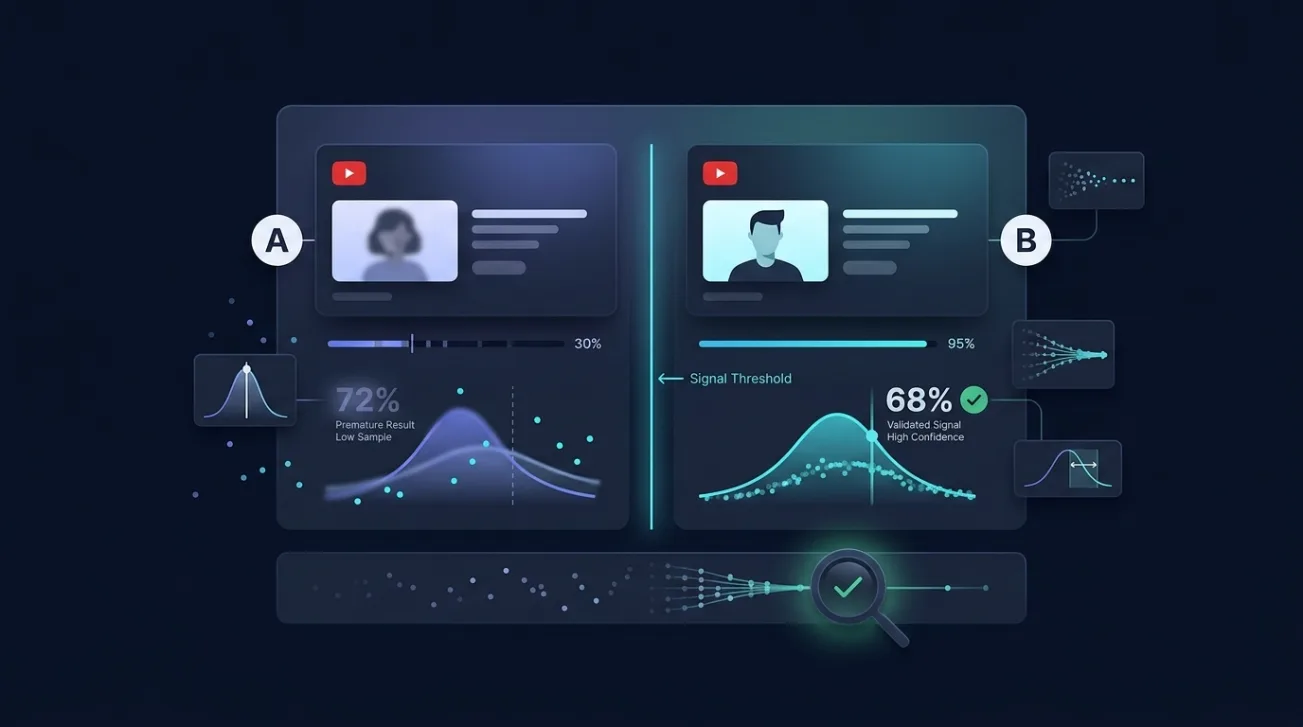
تُغيّر المُصغّر، ويُحقق الفيديو التالي أداءً أفضل، وتستنتج أن الأسلوب الجديد ناجح. هذا الاستنتاج غالبًا خاطئ — ليس لأن المُصغّر لم يفعل شيئًا، بل لأن المقارنة لم تكن قادرة على اكتشاف ما إذا كان له تأثير. إليك كيف تُميّز نتيجة تغليف حقيقية عن صدفة، باستخدام نفس القواعد التي طبقناها عند اختبار نموذج التقييم الخاص بنا مقابل 321 زوجًا من الفيديوهات.
النقاط الرئيسية
- مقارنة فيديو بمتوسط القناة على مدار الزمن تقيس مدى نمو قناتك، وليس جودة التغليف.
- قارن بدلاً من ذلك بمتوسط الوسيط لعشرة فيديوهات قبله وبعده، باستثناء الفيديو نفسه.
- فيديوين لا يكفيان أبدًا. الاختلافات الصغيرة بين فيديوهات فردية لا يمكن التمييز بينها وبين التغيرات الأسبوعية العادية.
- حدد ما يُعد فوزًا قبل أن تنظر، وإلا ستجد فوزًا في مكان ما من البيانات في كل مرة.
- اختبار لا يمكن أن يُعطي نتيجة سلبية ليس اختبارًا. اكتب ما الذي سيجعلك تتخلى عن الفكرة.
لماذا لا تكون معظم نتائج اختبارات المُصغّرات حقيقية
اختبار المُبدع النموذجي يقارن فيديوًا واحدًا بالفيديو السابق له. تحتوي هذه المقارنة على كل ما تغيّر بين التحميلين: الموضوع، يوم الأسبوع، الطول، ما إذا كان الخوارزمية دفعته، والتغليف. نسب كل الفرق للمُصغّر يفترض أن المتغيرات الأخرى ظلت ثابتة، وهذا لا يحدث أبدًا.
النتيجة هي أن أي تغيير تقريبًا يبدو أنه نجح، لأن أعداد المشاهدات تتغير كثيرًا من تلقاء نفسها. التباين بين التحميلات المتتالية على قناة صحية يطغى عادةً على تأثير قرار التصميم.
هذا ليس سببًا للتوقف عن الاختبار. إنه سبب لبناء المقارنة بحيث يُحسب الضوضاء بدلاً من اعتبارها إشارة.
ما الذي يجب أن تقارن به فيديوًا
قارن كل فيديو بجيرانه المباشرين، وليس بتاريخ قناتك. خذ عشرة تحميلات قبله وعشرة بعده، وجد متوسط الوسيط لعدد المشاهدات لهؤلاء العشرين، وعبّر عن مشاهدات الفيديو نفسه كمضاعف لهذا المتوسط. فيديو عند 1.0 أدى تمامًا مثل جيرانه. عند 2.5 أدى بضعف ونصف أداءهم.
تُهمّ تفاصيل اثنان وكلاهما سهل الخطأ. استخدم الوسيط بدلاً من المتوسط، لأن تحميلًا واحدًا فيروسيًا في النافذة سيُعيد تعريف الأساس لجيرانه العشرين. واستبعد الفيديو نفسه من أساسه الخاص، وإلا سُحب كل فيديو نحو 1.0 وتم تسطيح القيم المتطرفة التي تهتم بها.
| طريقة المقارنة | ما الذي تتحكم فيه | حيث تفشل |
|---|---|---|
| مقابل الفيديو السابق | تقريبًا لا شيء | نقطة بيانات ضوضائية مقابل أخرى |
| مقابل متوسطك على مدار الزمن | لا شيء عن التوقيت | قناة نامية تجعل كل فيديو حديث يبدو كنجاح |
| مقابل آخر 30 يومًا | حجم القناة، تقريبًا | الموسمية، وفيديو فيروسي واحد يُحيد المتوسط |
| مقابل المتوسط المتحرك للجيران | حجم القناة، النمو، العصر | لا يزال لا يمكن فصل الموضوع عن التغليف |
لماذا تعمل نافذة الجوار
قناة تضاعفت ثلاث مرات في الحجم خلال ثمانية عشر شهرًا ستُظهر كل تحميل حديث يتفوق على متوسطها مدى الحياة وكل قديم يفشل. عند تصنيفها بهذه الطريقة، فإن استنتاج التغليف الذي تصل إليه هو في الواقع بيان عن وقت نشر كل فيديو.
النافذة المتحركة تزيل ذلك، لأن جيران الفيديو نُشرت في قناة مماثلة، وحجم جمهور مماثل، وظروف خوارزمية مماثلة. ما تبقى هو أكثر احتمالًا أن يكون عن الفيديو نفسه.
ما حجم الفرق الذي يُعد فرقًا حقيقيًا
أرضية مفيدة هي عامل اثنين. عندما اخترنا الأزواج لدراستنا، اشترطنا أن يكون الفيديو الأفضل أداءً لديه على الأقل ضعف مضاعف المشاهدات للفيديو الأسوأ. أي شيء أضيق يطلب من الاختبار التمييز بين فيديوهين يمكن لضوضاء قناتك نفسها أن تفصل بينهما بسهولة.
يجب اعتبار النسب أقل من حوالي 1.3 كلا نتيجة على الإطلاق. هذا ليس عتبة صارمة عالمية — يعتمد على مدى تقلب قناتك — لكنه أقرب بكثير للصواب من اعتبار فرق 10% دليلًا.
النصف الآخر من السؤال هو كم عدد المقارنات التي تحتاجها. زوج واحد يخبرك بالأساس لا شيء. الحساب المزعج هو أن اكتشاف تأثير تغليف متواضع بشكل موثوق يتطلب مئات المقارنات، وهذا هو السبب في أن المبدعين الأفراد يكافحون لإثبات أي شيء عن قناتهم، والخطوة الصادقة هي اعتبار النتائج الفردية كدليل ضعيف وليس كإثبات.
قائمة مراجعة لاختبار التغليف على قناتك الخاصة
هذه الخطوات الخمس تحول الانطباع إلى شيء أقرب للقياس. لا تتطلب أيًا منها أدوات تتجاوز جدول بيانات.
- اكتب، قبل أن تبدأ، ما الذي سيقنعك بأن التغيير لم ينجح. اختبار لا يحتوي على نتيجة فاشلة ليس اختبارًا.
- احسب مضاعف مشاهدات كل فيديو مقابل متوسط الوسيط لتحميلاته الجيران بدلاً من أي رقم مدى الحياة.
- اجمع على الأقل عشرة فيديوهات في كل حالة قبل استخلاص أي استنتاج، وامتنع عن النظر في المجموع الجارٍ في الأثناء.
- استبعد الفيديوهات القصيرة، البث المباشر، التعاونات، وأي شيء أقل من ستة أسابيع، لأن كل الأربعة لديهم عوامل أداء غير مرتبطة بالتغليف.
- تحقق مما إذا كان هناك تفسير أبسط ينطبق — موضوع لم تغطيه أبدًا، تحميل تم مشاركته في مكان ما، ارتفاع موسمي.
الخطوة الثالثة هي التي يتجاهلها الناس، والوقف الفوري للاختبار عندما يبدو مواتيًا هو أكثر طريقة فعالة لإقناع نفسك بشيء غير صحيح.
إذا كنت ترغب في تقييم للتغليف قبل نشر الفيديو بدلاً من أسابيع لاحقة، يمكنك تقييم مُصغّر وعنوان مقابل اثني عشر عامل تغليف ومقارنة خيارين جنبًا إلى جنب — تنبؤ يمكنك بعد ذلك التحقق منه مقابل النتيجة بمجرد نضج الفيديو.
الأخطاء التي تجعل الاختبار يبدو حاسمًا عندما لا يكون كذلك
أربعة أنماط فشل تُفسر معظم الاستنتاجات الخاطئة، ولكل منها إصلاح مباشر.
التوقف عندما يبدو الجواب جيدًا
التحقق من النتائج أثناء تراكمها والتوقف عند أول لحظة مواتية سيُنتج نتيجة إيجابية من الضوضاء البحتة إذا كان لديك صبر كافٍ. ثبّت حجم العينة مسبقًا وحلل مرة واحدة. في دراستنا الخاصة، أزلنا قرار التوقف تمامًا: العينة كانت ما أنتجته القواعد المحددة مسبقًا، وهو 321 زوجًا مقابل هدف 400.
أبلغنا عن هذا النقص كضعف في القوة بدلاً من تمديد الجمع سراً، لأن قاعدة التوقف التي يمكن لأي شخص تطبيقها أثناء مراقبة النتيجة هي الطريقة التي تتحول بها نتيجة سالبة إلى اكتشاف.
إعادة التقطيع حتى ينجح شيء ما
إذا كانت النتيجة الكلية مسطحة، فمن المغري التحقق مما إذا كان ناجحًا للشكل الطويل، أو لفئة واحدة، أو لفيديوهات نُشرت يوم الثلاثاء. اختبر ما يكفي من المجموعات الفرعية وستبدو إحداها مهمة بالصدفة وحدها. حدد أي المقارنات مهمة قبل أن تنظر، وسمّ كل شيء آخر كاستكشافي عند الإبلاغ عنه.
كيف طبقنا هذه القواعد على 321 زوجًا من الفيديوهات
دراستنا الخاصة اتبعت بالضبط هذا الهيكل. ستون قناة عبر ست فئات، حتى 300 تحميل لكل منها، 17,250 فيديو تم النظر فيها بعد الاستبعاد. تم تقييم الفيديوهات مقابل المتوسط المتحرك لجيرانها، وتم تكوين الأزواج فقط داخل قناة واحدة، نُشرت بمتوسط ستة أيام فاصلة، مع تفوق الأداء الأفضل على الأسوأ بمتوسط عامل 4.7.
كل قاعدة — الاستبعاد، قيود التزاوج، الاختبار الأساسي، الضوابط الأربعة، والصياغة للنشر إذا عادت النتيجة سالبة — كُتبت وتم توثيقها قبل تقييم أي فيديو. اختار التقييم الفيديو الأفضل أداءً في 59.5% من الأزواج مقابل أساس 50%.
الجزء الذي يستحق النسخ ليس حجم العينة. بل هو أن التحليل لم يترك أي قرارات فيه بحلول الوقت الذي وصلت فيه البيانات.
الأسئلة الشائعة
كم عدد الفيديوهات التي أحتاجها لاختبار أسلوب مُصغّر؟
أكثر مما يمكن لمعظم القنوات إنتاجه بسرعة. اكتشاف تأثير تغليف متواضع بشكل موثوق يتطلب مئات المقارنات، وهذا هو السبب في أن نتائج الفيديو الواحد ضعيفة. مع عشرة فيديوهات لكل حالة يمكنك اكتشاف تأثير كبير؛ لا يمكنك اكتشاف تأثير دقيق، واعتبار فرق صغير كدليل عند هذا حجم العينة هو الخطأ الاختباري الأكثر شيوعًا.
ما الذي يجب أن أقارن به مشاهدات فيديو؟
متوسط الوسيط لعدد المشاهدات لعشرة تحميلات قبله وعشرة بعده، باستثناء الفيديو نفسه. هذا يُبقي حجم قناتك، نموها، وعصرها ثابتًا تقريبًا، لذا ما تبقى من المرجح أن يكون عن الفيديو. المقارنة مقابل متوسط مدى الحياة تقيس مدى نمو قناتك بدلاً من ذلك.
لماذا نستخدم الوسيط بدلاً من المتوسط؟
لأن تحميلًا واحدًا ناجحًا بشكل غير عادي داخل النافذة سيُسحب بمتوسط الأساس لأعلى ويجعل جيرانه العشرين جميعًا يبدون كأداء ضعيف. الوسيط يتأثر قليلاً من قبل أي قيمة شاذة، لذا يستمر الأساس في وصف فيديو نموذجي من تلك الفترة بدلاً من فيديو استثنائي.
كم من الوقت يجب أن أنتظر قبل تقييم أداء فيديو؟
على الأقل ستة أسابيع. تُجمع المشاهدات بشكل غير متساوٍ، ويمكن أن يتغير تصنيف الفيديو مقابل جيرانه بشكل كبير في الشهر الأول. في دراستنا استبعدنا أي شيء نُشر خلال 45 يومًا من تاريخ القياس لهذا السبب بالضبط، بالإضافة إلى أي شيء يزيد عن سنتين.
هل يمكنني الوثوق باختبار مُصغّر يقارن فقط فيديوهين؟
اعتبره إشارة وليس نتيجة. يختلف فيديوهان في الموضوع، التوقيت، الطول والعشرات من الطرق الأخرى، لذا نسب كل الفجوة للتغليف يفترض أن كل شيء آخر ظل ثابتًا. يستحق الملاحظة ويستحق التكرار، لكنه ليس الأساس لتغيير نهج على مستوى القناة.
ما هو مضاعف المشاهدات وكيف أحسبه؟
اقسم عدد مشاهدات الفيديو على متوسط مشاهدات تحميلاته الجيران، باستثناء نفسه. نتيجة 1.0 تعني أنه أدى مثل جيرانه، 2.0 تعني ضعف الأداء، 0.5 تعني نصفه. يحول أعداد المشاهدات الخام، التي تعتمد بشدة على وقت نشر الفيديو، إلى رقم يمكن مقارنته عبر تاريخ قناتك.