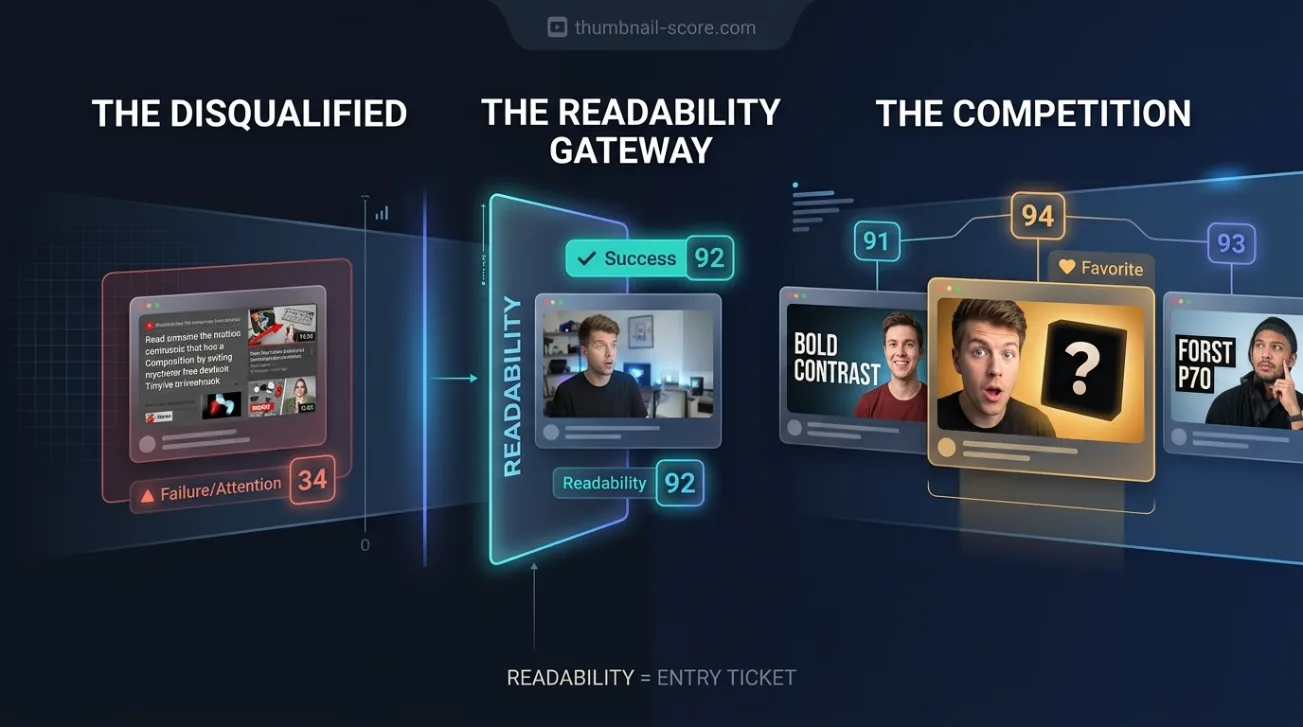
يبدأ معظم نصائح الصور المصغرة بالقراءة: نص كبير، تباين عالٍ، نقطة تركيز واحدة. هذه النصيحة صحيحة، وهي أيضًا المكان الذي وصلت إليه القنوات الراسخة بالفعل. في 642 صورة مصغرة حقيقية، لم يتغير تقييمنا للقراءة كثيرًا، وحذفها من التقييم الكلي لم يغير على الإطلاق مدى دقة التقييم في تصنيف مقاطع الفيديو الحقيقية.
النقاط الرئيسية
- في 642 صورة مصغرة من قنوات راسخة، تراوح تقييمنا الفرعي للقراءة فقط من 85 إلى 95. تباينت كل العوامل الأخرى التي نقيسها أكثر.
- حذف القراءة من التقييم تمامًا ترك دقة الترتيب كما كانت: 62.0% من 321 زوجًا من نفس القناة.
- لا تزال القراءة مهمة كحد أدنى. صورة مصغرة لا يستطيع أحد قراءتها بحجم الهاتف تفشل قبل أن يُحكم على أي شيء آخر — فقط توقفت عن التمييز بين مقاطع الفيديو الجيدة والرائعة.
- قللنا من وزنها في التقييم بشكل كبير، لكن ليس إلى الصفر، لأن العينة لم تحتوي على مبتدئين.
- بمجرد أن يصبح النص واضحًا، فإن العنوان ووضوح الوعد هما المكان الذي تكمن فيه الفروق المتبقية.
هل تؤثر قراءة الصورة المصغرة على مقاطع الفيديو الأفضل أداءً؟
تقرر القراءة ما إذا كانت الصورة المصغرة في اللعبة أم لا، وليس ما إذا كانت ستفوز. بين القنوات الراسخة، صنّف نموذجنا تقريبًا كل صورة مصغرة على أنها سهلة القراءة، لذا لم تستطع القراءة أن تميز بين نجاحات القناة وإخفاقاتها. عندما حذفناها من تقييمنا، صنّف التقييم مقاطع الفيديو الحقيقية بنفس دقة ما قبله: 62.0% من 321 زوجًا.
هذا ادعاء أضيق مما يبدو، والضيق مهم. لا يقول إن القراءة غير مهمة. بل يقول إنه بين القنوات التي كانت ترفع مقاطع كافية لتكوين قاعدة، تم حل مشكلة القراءة بالفعل، ولا يمكن لعامل يجتازه الجميع أن يصنّف أحدًا.
ما مدى تباين القراءة فعليًا بين الصور المصغرة الحقيقية
تم تقييم كل صورة مصغرة في الدراسة على اثني عشر عاملًا. إليك مدى اتساع ستة منها عبر جميع الصور المصغرة الـ 642 — نفس الأزواج الـ 321 المستخدمة في اختبارنا المنشور للتقييم. عمود "الانتشار" هو الانحراف المعياري: تقريبًا، مدى بُعد الصورة المصغرة النموذجية عن المتوسط.
| العامل | أدنى إلى أعلى تقييم | الانتشار |
|---|---|---|
| القراءة | 85 إلى 95 | 3.7 |
| خطر النقر المضلل | 3 إلى 44 | 5.4 |
| الفضول | 29 إلى 68 | 6.8 |
| قوة العنوان | 23 إلى 93 | 10.3 |
| وضوح الوعد | 8 إلى 95 | 13.9 |
| التشويق | 17 إلى 93 | 14.9 |
القراءة ليست مجرد أضيق عمود. إن نطاقها بأكمله، من الأدنى إلى الأعلى، أصغر من المسافة النموذجية من المتوسط للعوامل في أسفل الجدول. أضعف صورة مصغرة في العينة بأكملها حصلت على 85 على الأقل.
هذه تقييمات نموذجنا، وليس قياسات تم أخذها بمسطرة. لكن النموذج لم يكن متساهلاً بشكل عام: فقد امتد وضوح الوعد عبر مقياس تقريبًا كامل، من 8 إلى 95. كان لديه النطاق المتاح ولم يستخدمه للقراءة، لأن الصور المصغرة أمامه لم تختلف كثيرًا في ذلك.
ما الذي يفعله النطاق الضيق للتقييم
الوزن في التقييم لا يقيس مدى أهمية شيء ما. بل يقرر مقدار تحرك الرقم النهائي عندما يتغير ذلك العامل. إذا تغير عامل قليلاً، فإن وزنًا كبيرًا عليه يضيف في الغالب نفس المقدار لكل صورة مصغرة. يرفع درجة الجميع دون فصل أي أحد.
حملت القراءة أحد أكبر الأوزان في جانب النقر في تقييمنا بينما تباينت أقل من أي شيء آخر نقيسه. في الممارسة العملية، عملت كمكافأة ثابتة تقريبًا، والجائزة الثابتة تضغط بالضبط على الفروق بين الصور المصغرة التي يُوجد باقي التقييم لعرضها.
ما الذي حدث عندما حذفنا القراءة من التقييم
لم نكن بحاجة للتخمين. الدراسة تحتوي بالفعل على كل التقييمات الفرعية لكل صورة مصغرة، لذا يمكن إعادة حساب التقييم الكلي بأي مجموعة من الأوزان دون طلب أي شيء جديد من النموذج. صنّفنا جميع الأزواج الـ 321 مرة أخرى مع القراءة بوزنها الأصلي، وبأوزان مخفضة، وبصفر، وقارننا التقييمات بدقة كاملة بدلاً من أرقام صحيحة مُقربة — وهذا هو السبب في أن هذه الأرقام تقع قليلاً فوق 59.5% التي نشرناها في الأصل.
بوزنها الأصلي، اختار التقييم الفيديو الأفضل أداءً في 62.0% من الأزواج. بصفر، مع حذف القراءة تمامًا، اختار الأفضل في 62.0% من الأزواج. بقي كل قيمة بينهما ضمن 0.6 نقطة من ذلك. في نصف القنوات التي لم تمسها أي من تجاربنا، ظل النتيجة: 59.4% بالوزن الأصلي، و59.4% بصفر.
لماذا قللناها بدلاً من حذفها
كان من الممكن للبيانات أن تسمح بحذف القراءة تمامًا. لم نفعل ذلك، بسبب من كانوا في العينة. كل قناة في الدراسة كانت راسخة: تاريخ طويل من الرفع، جمهور مستقر، صور مصغرة صنعها أشخاص تعلموا منذ زمن طويل جعل النص واضحًا. هذا بالضبط السبب في أن القراءة بدت خاملة.
هذا ليس من يستخدم مدقق الصور المصغرة. المُنشئ الذي يرفع فيديو العاشر له بتعليق صغير عبر خلفية مزدحمة هو الشخص الذي توجد القراءة لاصطياده، ولهم تختلف كثيرًا. حذفها بناءً على عينة لا تحتوي على مثل هذه الصور المصغرة سيكون الإجابة على سؤال لم تطرحه البيانات أبدًا. لذا تم قطع وزنها بشكل كبير، وتم توزيع الفرق على العوامل الأخرى للنقر بنسبة أوزانها الحالية، مما يترك ترتيبها دون تغيير.
بالنسبة لصورة مصغرة نموذجية، ينخفض التقييم الكلي بنقطة واحدة تقريبًا. كما اختبرنا إعادة ترجيح إحصائية كاملة لجميع العوامل الاثني عشر؛ فكانت النتيجة ارتفاعًا بـ 1.9 نقطة، وهو داخل الضوضاء لعينة بهذا الحجم، لذا تُركت باقي الأوزان كما هي.
حد القراءة الذي يجب أن تجتازه كل صورة مصغرة
لا يعني أي من هذا أنه يمكن تخطي القراءة. بل يعني أنها فحص ناجح أو فاشل يجب تجاوزه بسرعة، ثم التوقف عن التلميع. نسخة قابلة للتطبيق من هذا الفحص:
- قلص الصورة المصغرة إلى الحجم الذي تظهر به في قائمة مقترحات الفيديو وانظر إليها لثانية واحدة. إذا لم تستطع قراءة كل كلمة، فهناك كلمات كثيرة جدًا أو صغيرة جدًا.
- عد الكلمات على الصورة. ثلاث أو أربع كلمات كثيرة جدًا بهذا الحجم، وعبارة قصيرة واحدة عادةً تُقرأ أفضل من جملة.
- تحقق من التباين بالأبيض والأسود. النص الذي يبرز من خلفيته فقط باللون يختفي لبعض المشاهدين وعلى بعض الشاشات.
- ابحث عن الشيء الوحيد الذي يقع عليه البصر أولًا. إذا تنافست نقطتان تركيزيتان، فإن الصورة المصغرة تطلب من المشاهد الاختيار قبل أن يقرر النقر.
- انظر إليها بجانب الصور المصغرة التي ستظهر بجانبها فعليًا. الوضوح على لوحة فارغة ليس نفسه الوضوح في تغذية مزدحمة.
إذا اجتازت الصورة المصغرة كل الخمسة، فمن غير المرجح أن يكون المزيد من العمل على القراءة هو ما يفصلها عن الفيديو المجاور لها.
أين تنفق الجهد بمجرد أن يصبح النص واضحًا
في اختبارنا الأصلي، كان العامل الذي فصل بوضوح بين مقاطع الفيديو الأفضل أداءً في القناة وأقلها هو وضوح الوعد: مدى وضوح ما تقوله التغليف عن الفيديو. جاءت إشارة الخوف من فقدان الفرصة والطوارئ بعد ذلك. كل الثلاثة تعيش في الغالب في العنوان، وفي كيفية عمل العنوان والصورة معًا، وليس في وضوح الخط.
هذا يتوافق مع التجربة الوحيدة في الدراسة التي غيرت العنوان مع بقاء الصورة. عندما أُعيد تقييم كل صورة مصغرة مقابل عنوان الفيديو الآخر، تغير تقييمها بمتوسط أكثر من أحد عشر نقطة — حوالي ثلاثة أضعاف انتشار القراءة بأكمله. من وجهة نظر نموذجنا، تحمل الكلمات جزءًا أكبر من الفرق مقارنة بالخط. إذا أردت أن ترى أين يقع تغليفك الخاص، يمكنك تقييم صورة مصغرة وعنوان ضد نفس العوامل الاثني عشر ورؤية أيها يعيقها.
حدود هذا الاستنتاج
كل شيء هنا يصف قنوات راسخة، باللغة الإنجليزية، تم تقييمها بواسطة نموذج واحد. بدت القراءة خاملة لأن تلك القنوات قد حلّت المشكلة بالفعل، ولا ينبغي تعميم هذا الاستنتاج على قناة جديدة دون هذا التحذير.
أرقام القراءة هي تقييمات النموذج وليس قياسًا مستقلًا، لذا فإن نموذجًا يُبالغ بشكل منهجي في تقييم الوضوح سيُنتج نفس النطاق الضيق. نعتقد أن هذا غير محتمل، نظرًا لأن النموذج نفسه استخدم تقريبًا المقياس بأكمله للعوامل الأخرى، لكن هذه البيانات وحدها لا يمكنها استبعاد ذلك. وكما في الدراسة الأصلية، كل هذا هو ارتباط: لم يتم تغيير أي صورة مصغرة وإعادة نشرها لمعرفة ما سيحدث بعد ذلك.
الأسئلة الشائعة
هل يهم حجم نص الصورة المصغرة على يوتيوب؟
نعم، كحد أدنى. النص الذي لا يمكن قراءته بالحجم الذي تظهر به الصورة المصغرة في التغذية يُهدر المساحة التي يشغلها. ما تشير إليه بياناتنا هو أن القنوات الراسخة قد اجتازت هذا الحد بالفعل، لذا بمجرد أن يصبح النص واضحًا، فمن غير المرجح أن يجعله أكبر أو أقوى هو ما يفصل بين فيديو وآخر.
لماذا توقفت القراءة عن الأهمية في تقييمك؟
لم تتوقف عن الأهمية؛ بل توقفت عن التمييز. عبر 642 صورة مصغرة من قنوات راسخة، تراوحت فقط من 85 إلى 95، لذا أضافت تقريبًا نفس المقدار لكل تقييم. حذفها ترك قدرة التقييم على تصنيف مقاطع الفيديو الحقيقية دون تغيير، وهذا هو السبب في تقليل وزنها.
هل يجب أن أتوقف عن العمل على قراءة الصورة المصغرة؟
فقط بمجرد أن تجتاز فحصًا سريعًا بحجم التغذية: كل كلمة قابلة للقراءة في حوالي ثانية، نقطة تركيز واضحة واحدة، وEnough تباين ليعيش بالأبيض والأسود. بعد تلك النقطة، من المرجح أن يغير الوقت المنفق على العنوان وعلى مدى وضوح التغليف لوعده كيف يقارن الفيديو مع جيرانه.
هل غير هذا تقييمات صورتي المصغرة الحالية؟
بشكل طفيف. مع تقليل وزن القراءة ورفع العوامل الأخرى للنقر للتعويض، ينخفض التقييم الكلي النموذجي بنقطة واحدة تقريبًا. عبر الصور المصغرة المرجعية التي نتحقق من كل تغيير ضدها، لم يتغير أي تقييم، وكان أكبر تحرك نقطة واحدة.
هل ينطبق هذا على القنوات الصغيرة أو الجديدة؟
ليس تلقائيًا. كل قناة في العينة كانت راسخة، وهذا بالضبط السبب في أن القراءة أظهرت تباينًا ضئيلًا جدًا. من المرجح جدًا أن القناة الأحدث سيكون لديها صور مصغرة صعبة القراءة فعليًا، ولها، يمكن أن تكون القراءة أهم شيء يجب إصلاحه أولًا.