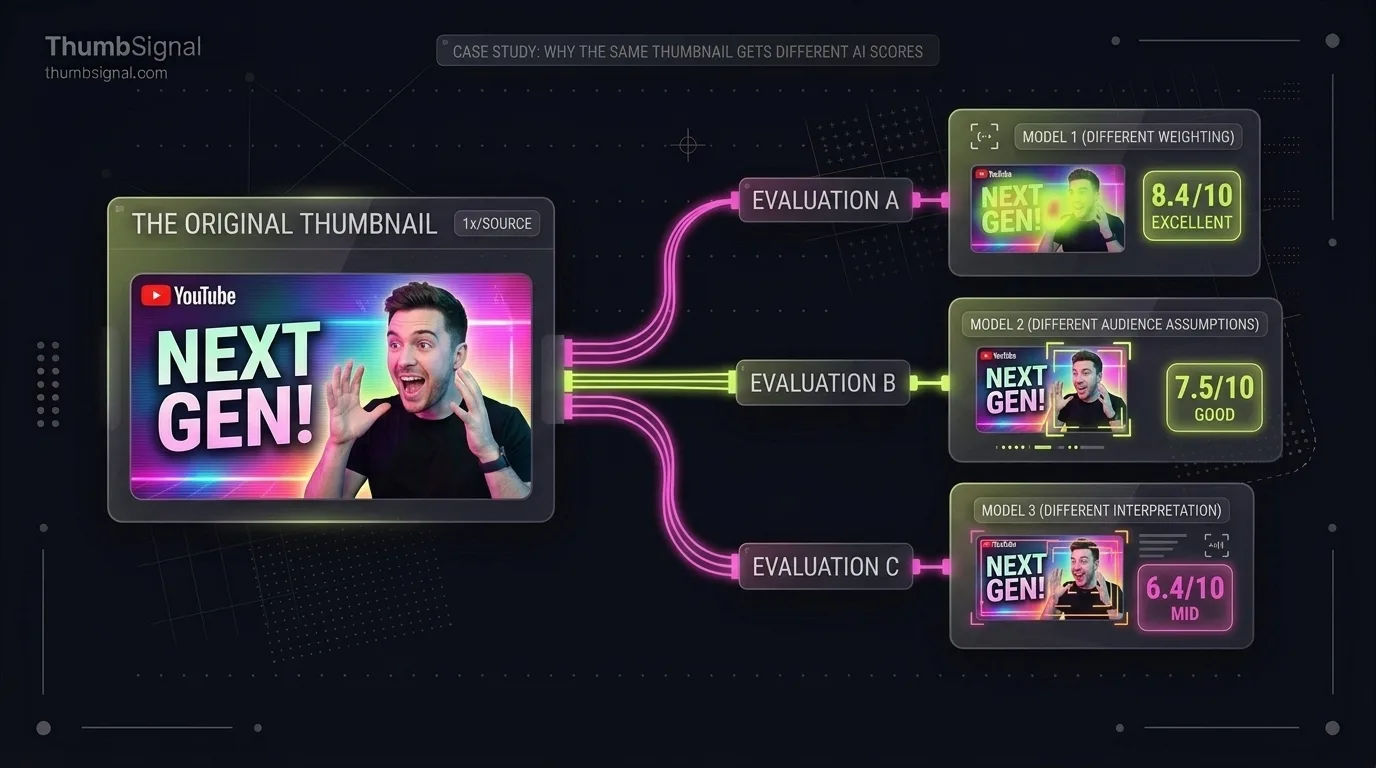
Pide a un modelo de IA que puntúe la misma miniatura y título dos veces y puedes obtener dos números distintos. El nuestro devolvió una vez 71, luego 68, para una solicitud idéntica. Esto no es un error en una herramienta. Es así como funcionan los modelos grandes en hardware compartido, y establecer la temperatura en cero no lo elimina. Lo importante es saber cuánto varía y leer cada puntuación con ese margen en mente.
Conclusiones clave
- El modelo detrás de nuestra puntuación dio respuestas diferentes a solicitudes idénticas: alrededor de 3 puntos de diferencia en promedio cuando preguntamos dos veces, y hasta 16 puntos en el peor caso que medimos.
- La temperatura 0 no hace que un modelo grande sea determinista. La variación proviene de cómo se agrupan los cálculos en los servidores, no de muestreo aleatorio.
- En nuestro estudio de videos reales del mismo canal, diferencias de puntuación de 1 a 3 puntos no se podían distinguir del azar. A partir de 4 puntos, la puntuación más alta correspondía al video con mejor rendimiento aproximadamente dos de cada tres veces.
- Nuestro analizador ahora almacena cada respuesta y la devuelve cuando envías la misma imagen y título nuevamente, por lo que una repetición muestra la misma puntuación en lugar de una nueva lectura.
- Cualquier cambio, incluso volver a guardar la imagen, es una nueva pregunta y obtiene una nueva lectura. Compara versiones por diferencias de varios puntos, nunca por uno o dos.
¿Por qué cambia la puntuación de IA de una miniatura cuando no cambió nada?
Porque la aritmética del modelo no es perfectamente repetible. Los modelos grandes se ejecutan en servidores que procesan muchas solicitudes juntas, y el orden en que se suman millones de cálculos pequeños varía de un lote a otro. Esas pequeñas diferencias de redondeo rara vez importan, pero una puntuación se construye a partir de muchas palabras que el modelo escribe una a la vez, y una palabra que se inclina hacia otro lado cerca de un umbral puede mover una subpuntuación varios puntos.
Descubrimos esto de la manera habitual: la misma miniatura y el mismo título, analizados dos veces, devolvieron 71 y luego 68. Nada en nuestro propio código era aleatorio. El prompt se construye con reglas fijas, la aritmética después del modelo es aritmética simple, y el modelo ya se había llamado con temperatura 0, la configuración normalmente descrita como "sin aleatoriedad". La diferencia provino completamente del lado del modelo en la llamada.
La temperatura 0 no es lo mismo que determinista
La temperatura controla el muestreo: con qué frecuencia un modelo elige una palabra distinta a su primera opción. En 0 siempre toma la primera opción. Pero "primera opción" se decide mediante números calculados en hardware donde el orden de las sumas cambia con la carga, por lo que dos ejecuciones pueden discrepar sobre cuál palabra está en la cima cuando dos candidatas están casi empatadas. Por eso la misma solicitud puede producir texto ligeramente diferente, y puntuaciones ligeramente diferentes, incluso con el muestreo desactivado.
Esto aplica a cualquier herramienta que le pida a un modelo grande un número, incluidos asistentes de chat generales a los que podrías pedir "calificar esta miniatura del 1 al 10". Si una herramienta nunca te muestra la misma respuesta dos veces, eso no es prueba de que sea poco confiable. Si te muestra un número preciso sin margen, ese número está afirmando más de lo que el modelo puede entregar.
Cuán grande es realmente la diferencia
Medimos esto como parte de nuestras ejecuciones de evaluación, que envían un conjunto fijo de casos de prueba al modelo real y registran lo que devuelve. Cada caso se pregunta dos veces, y comparamos las dos puntuaciones globales.
Lo que mostraron las ejecuciones repetidas
En una ejecución de 26 casos de prueba a principios de octubre de 2026, las dos respuestas a la misma solicitud diferían en unos 3 puntos en promedio, y el peor caso individual varió en 16 puntos. Una segunda ejecución en un conjunto más pequeño de casos dos días después mostró lo mismo: una diferencia promedio cercana a 3 puntos y un caso que varió en 10.
Tres puntos suena pequeño en una escala de 100 puntos. Deja de sonar pequeño cuando lo comparas con las diferencias que la gente usa para tomar decisiones con las puntuaciones. Dos borradores de miniatura que puntúan 64 y 66 son, según esta evidencia, la misma puntuación pedida dos veces.
Qué diferencias de puntuación significan algo
La repetibilidad es la mitad de la pregunta. La otra mitad es si una diferencia predice algo sobre el rendimiento real. Nuestro estudio de 321 pares de videos reales comparó dos subidas del mismo canal, publicadas cerca una de la otra, y verificó si la que obtuvo la puntuación más alta fue la que superó la línea de base del canal. Dividido por el tamaño de la diferencia entre las dos puntuaciones, los resultados son estos.
| Diferencia entre las dos puntuaciones | Pares | La puntuación más alta correspondió al mejor video | Intervalo del 95% |
|---|---|---|---|
| Empate | 17 | nunca, los empates se cuentan como errores | |
| 1 a 3 puntos | 91 | 56,0% | 45,8% a 65,8% |
| 4 a 7 puntos | 92 | 64,1% | 53,9% a 73,2% |
| 8 a 14 puntos | 87 | 63,2% | 52,7% a 72,6% |
| 15 puntos o más | 34 | 76,5% | 60,0% a 87,6% |
Una diferencia de 1 a 3 puntos fue correcta el 56% de las veces, y su intervalo incluye el 50%: no se puede distinguir de un lanzamiento de moneda. A partir de 4 puntos, la puntuación más alta correspondió al mejor video aproximadamente dos de cada tres veces, y las diferencias más grandes funcionaron aún mejor. La diferencia mediana en el estudio fue de 6 puntos. Estos son desgloses exploratorios de un estudio en canales establecidos en inglés, así que léelos como guía de escala en lugar de umbrales exactos.
Los dos números apuntan a la misma regla
Las ejecuciones repetidas dicen que una puntuación puede variar unos 3 puntos por sí sola. El estudio dice que diferencias menores a 4 puntos no predicen cuál video funciona mejor. Ambos apuntan a la misma regla práctica: trata dos puntuaciones dentro de 3 puntos entre sí como iguales, y solo actúa ante una diferencia de 4 puntos o más.
Qué hace nuestro analizador al respecto
Cada respuesta se almacena junto a una huella digital de la solicitud exacta: el archivo de imagen, el título, el modelo y las instrucciones enviadas a él. Cuando envías la misma imagen y título nuevamente, el analizador devuelve la respuesta almacenada en lugar de preguntarle al modelo una segunda vez. Ves la misma puntuación que viste antes, y una repetición así normalmente no consume uno de tus análisis.
Qué aún produce una nueva puntuación
- Un archivo de imagen diferente, incluso uno que se ve idéntico. Volver a exportar o comprimir una miniatura cambia sus bytes, y el analizador ve una imagen nueva.
- Cualquier cambio en el título, incluida la puntuación o la capitalización.
- Un cambio de nuestro lado en el modelo o en sus instrucciones. Cuando los cambiamos, las respuestas anteriores ya no coinciden, y la siguiente solicitud obtiene una lectura nueva.
El último punto significa que una puntuación de hace un mes y una de hoy pueden no ser directamente comparables si el análisis cambió entre medias. Registramos qué versión del análisis produjo cada resultado, así que podemos saberlo, pero el consejo práctico es más simple: cuando compares dos versiones de tu empaque, puntúa ambas el mismo día.
Cómo comparar puntuaciones de miniaturas sin engañarte
- Puntúa todas las versiones que quieras comparar en la misma sesión, para que sean leídas por la misma versión del análisis.
- Cambia una cosa a la vez. Si el título y la imagen cambian ambos, una diferencia no puede decirte cuál cambio la causó.
- Ignora diferencias de 1 a 3 puntos. Trata esas versiones como iguales y elige por otros criterios, como cuán claramente cada una expresa lo que ofrece el video.
- Actúa ante diferencias de 4 puntos o más, y da más peso a las grandes. Puedes puntuar dos versiones de tu miniatura lado a lado y leer la diferencia según esta regla.
- Confirma con datos reales. Una puntuación ordena opciones antes de publicar; los resultados de tu propio canal después de publicar deciden. Nuestra guía sobre cómo saber si un resultado de prueba de miniatura es real cubre cómo hacerlo.
Límites de estas cifras
Las ejecuciones repetidas usaron un conjunto pequeño y fijo de casos de prueba, cada uno preguntado dos veces, por lo que el promedio y el peor caso cambiarán a medida que se añadan más ejecuciones. La tabla de diferencias proviene de un estudio de canales establecidos en inglés, en el que ningún segmento más pequeño se validó por separado. Una puntuación ordena dos opciones; no pronostica vistas o tasa de clics, y nada aquí cambia eso.
Preguntas frecuentes
¿Por qué mi miniatura obtuvo una puntuación diferente la segunda vez?
Si algo en la solicitud cambió, como el archivo de imagen, el título o la versión de nuestro análisis, fue una nueva pregunta y el modelo la leyó nuevamente. Los modelos grandes no devuelven exactamente la misma respuesta a una solicitud repetida, incluso con temperatura 0. Una imagen y título idénticos enviados nuevamente devuelven la respuesta almacenada en su lugar.
¿Cuánto puede variar una puntuación de IA para la misma imagen?
En nuestras ejecuciones repetidas, dos respuestas a la misma solicitud diferían en unos 3 puntos en promedio, y hasta en 16 puntos en el peor caso. La diferencia media era pequeña, pero una sola comparación puede caer en una grande, por eso las diferencias pequeñas no deberían decidir nada.
¿Hace que la puntuación de IA sea consistente establecer la temperatura en 0?
No. La temperatura 0 elimina el muestreo, pero la aritmética interna del modelo aún varía según cómo los servidores agrupan las solicitudes. Cuando dos palabras posibles están casi empatadas, eso basta para cambiar cuál escribe el modelo, y con ello la puntuación.
¿Cuántos puntos de diferencia deben tener dos miniaturas antes de elegir una?
Al menos 4. En nuestro estudio de videos reales, diferencias de 1 a 3 puntos no se podían distinguir del azar, y el modelo mismo varía unos 3 puntos entre repeticiones. A partir de 4 puntos, la puntuación más alta fue correcta aproximadamente dos de cada tres veces, más para diferencias grandes.
¿Puedo comparar una puntuación del mes pasado con una de hoy?
Solo con precaución. Si cambiamos el modelo o sus instrucciones entre medias, las dos puntuaciones provienen de versiones diferentes del análisis. Vuelve a puntuar ambas versiones el mismo día cuando la comparación importe.