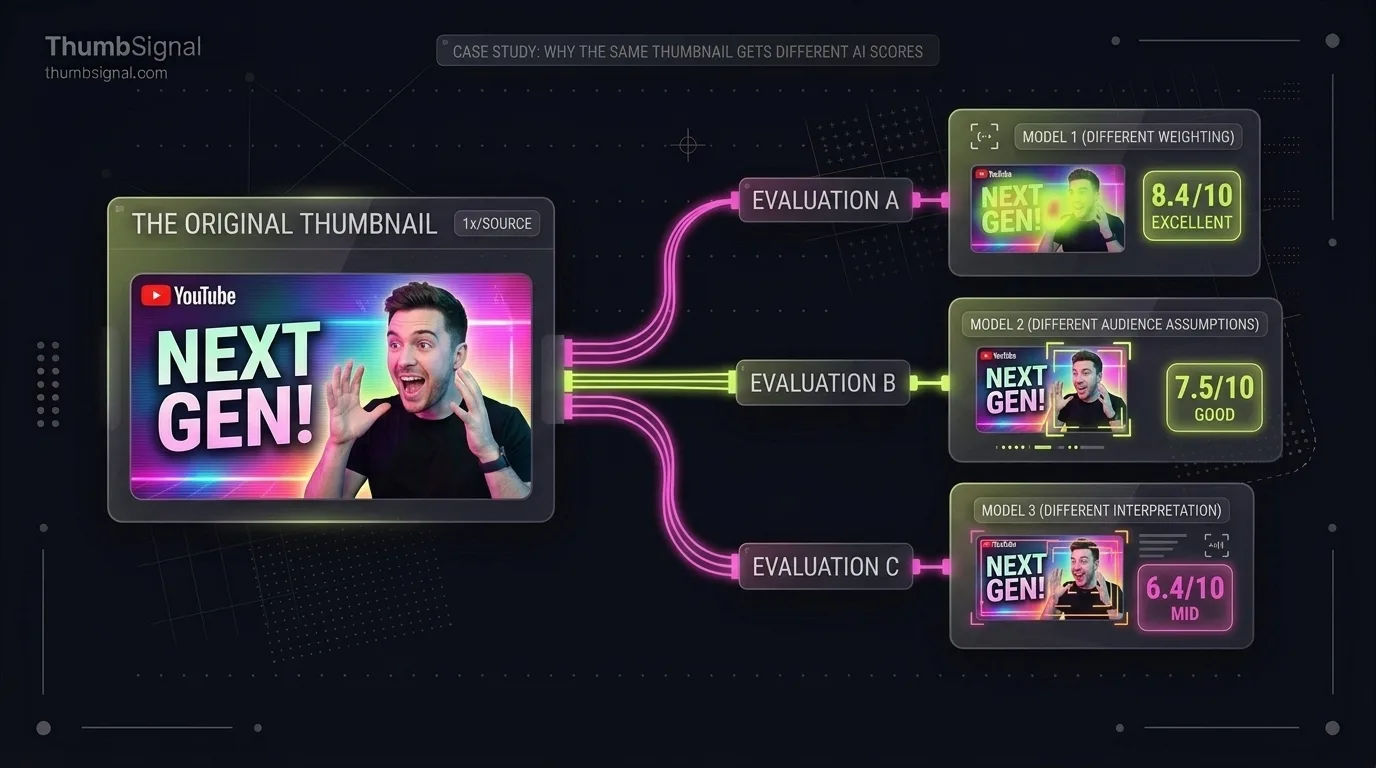
Peça a um modelo de IA para pontuar a mesma miniatura e título duas vezes e você pode obter dois números diferentes. O nosso já retornou 71, depois 68, para uma solicitação idêntica. Isso não é um bug em uma ferramenta. É como modelos grandes funcionam em hardware compartilhado, e definir a temperatura como zero não remove isso. O que importa é saber o quanto essa variação pode ser e ler cada pontuação com essa margem em mente.
Principais conclusões
- O modelo por trás da nossa pontuação deu respostas diferentes para solicitações idênticas: cerca de 3 pontos de diferença em média quando perguntamos duas vezes, e até 16 pontos no pior caso que medimos.
- Temperatura 0 não torna um modelo grande determinístico. A variação vem de como o cálculo é agrupado nos servidores, não de amostragem aleatória.
- Em nosso estudo de vídeos reais do mesmo canal, diferenças de pontuação de 1 a 3 pontos não puderam ser distinguidas do acaso. A partir de 4 pontos, a pontuação mais alta pertenceu ao vídeo com melhor desempenho cerca de duas vezes em três.
- Nosso analisador agora armazena cada resposta e a retorna quando você envia novamente a mesma imagem e título exatos, então uma repetição mostra a mesma pontuação em vez de um novo resultado.
- Qualquer alteração, mesmo re-salvar a imagem, é uma nova pergunta e recebe uma nova leitura. Compare versões por diferenças de vários pontos, nunca por um ou dois.
Por que a pontuação de uma miniatura por IA muda quando nada mudou?
Porque a aritmética do modelo não é perfeitamente repetível. Modelos grandes rodam em servidores que processam muitas solicitações juntas, e a ordem em que milhões de pequenos cálculos são somados varia de um lote para outro. Essas pequenas diferenças de arredondamento raramente importam, mas uma pontuação é construída a partir de muitas palavras que o modelo escreve uma de cada vez, e uma palavra que muda de lado perto de um limite pode mover uma subpontuação em vários pontos.
Descobrimos isso da maneira comum: a mesma miniatura e o mesmo título, analisados duas vezes, retornaram 71 e depois 68. Nada em nosso próprio código era aleatório. O prompt é construído por regras fixas, a aritmética após o modelo é aritmética simples, e o modelo já havia sido chamado com temperatura 0, a configuração geralmente descrita como “sem aleatoriedade”. A diferença veio inteiramente do lado do modelo da chamada.
Temperatura 0 não é o mesmo que determinístico
Temperatura controla a amostragem: com que frequência um modelo escolhe uma palavra diferente da sua escolha principal. Em 0, ele sempre escolhe a principal. Mas “escolha principal” é decidida por números calculados em hardware onde a ordem das adições muda com a carga, então duas execuções podem discordar sobre qual palavra está no topo quando dois candidatos estão quase empatados. É por isso que a mesma solicitação pode produzir texto ligeiramente diferente, e pontuações ligeiramente diferentes, mesmo com a amostragem desligada.
Isso se aplica a qualquer ferramenta que peça a um modelo grande um número, incluindo assistentes de chat gerais a quem você pode pedir para “avaliar esta miniatura de 0 a 10”. Se uma ferramenta nunca mostrar a mesma resposta duas vezes, isso não é prova de que ela não seja confiável. Se ela mostrar um número preciso sem margem, esse número está reivindicando mais do que o modelo pode entregar.
Quão grande é a diferença na prática
Medimos isso como parte de nossas execuções de avaliação, que enviam um conjunto fixo de casos de teste pelo modelo real e registram o que retorna. Cada caso é perguntado duas vezes, e comparamos as duas pontuações globais.
O que as execuções repetidas mostraram
Em uma execução de 26 casos de teste no início de outubro de 2026, as duas respostas para a mesma solicitação diferiram em cerca de 3 pontos em média, e o pior caso único variou em 16 pontos. Uma segunda execução em um conjunto menor de casos dois dias depois mostrou o mesmo quadro: uma diferença média próxima de 3 pontos e um caso que variou em 10.
Três pontos parecem pequenos em uma escala de 100 pontos. Deixam de parecer pequenos assim que você os compara com as diferenças que as pessoas usam para decidir com base nas pontuações. Duas versões de miniatura que pontuam 64 e 66 são, com base nessa evidência, a mesma pontuação perguntada duas vezes.
Quais diferenças de pontuação significam algo
A repetibilidade é metade da questão. A outra metade é se uma diferença prevê algo sobre o desempenho real. Nosso estudo de 321 pares de vídeos reais comparou dois uploads do mesmo canal, publicados próximos um do outro, e verificou se o que teve pontuação mais alta foi o que superou a própria linha de base do canal. Dividido pelo tamanho da diferença entre as duas pontuações, os resultados são estes.
| Diferença entre as duas pontuações | Pares | Pontuação mais alta pertenceu ao melhor vídeo | Intervalo de 95% |
|---|---|---|---|
| Empate | 17 | nunca, empates contam como erros | |
| 1 a 3 pontos | 91 | 56,0% | 45,8% a 65,8% |
| 4 a 7 pontos | 92 | 64,1% | 53,9% a 73,2% |
| 8 a 14 pontos | 87 | 63,2% | 52,7% a 72,6% |
| 15 pontos ou mais | 34 | 76,5% | 60,0% a 87,6% |
Uma diferença de 1 a 3 pontos estava certa 56% das vezes, e seu intervalo inclui 50%: não pode ser distinguida de um cara ou coroa. A partir de 4 pontos, a pontuação mais alta pertenceu ao melhor vídeo cerca de duas vezes em três, e as maiores diferenças foram ainda melhores. A diferença mediana no estudo foi de 6 pontos. Essas são divisões exploratórias de um estudo em canais estabelecidos em inglês, então leia-as como um guia de escala, não como limites exatos.
Os dois números apontam para a mesma regra
As execuções repetidas dizem que uma pontuação pode variar cerca de 3 pontos por conta própria. O estudo diz que diferenças abaixo de 4 pontos não preveem qual vídeo performa melhor. Ambos apontam para a mesma regra prática: trate duas pontuações dentro de 3 pontos uma da outra como iguais, e só aja com uma diferença de 4 pontos ou mais.
O que nosso analisador faz a respeito
Cada resposta é armazenada contra uma impressão digital da solicitação exata: o arquivo de imagem, o título, o modelo e as instruções enviadas a ele. Quando você envia novamente a mesma imagem e título, o analisador retorna a resposta armazenada em vez de perguntar ao modelo uma segunda vez. Você vê a mesma pontuação que viu antes, e uma repetição como essa normalmente não consome uma de suas análises.
O que ainda produz uma nova pontuação
- Um arquivo de imagem diferente, mesmo que pareça idêntico. Re-exportar ou re-comprimir uma miniatura muda seus bytes, e o analisador vê uma nova imagem.
- Qualquer alteração no título, incluindo pontuação ou capitalização.
- Uma alteração do nosso lado no modelo ou em suas instruções. Quando as alteramos, respostas anteriores não correspondem mais, e a próxima solicitação recebe uma nova leitura.
O último ponto significa que uma pontuação de um mês atrás e uma de hoje podem não ser diretamente comparáveis se a análise mudou entre elas. Registramos qual versão da análise produziu cada resultado, então podemos dizer, mas o conselho prático é mais simples: quando comparar duas versões da sua embalagem, pontue ambas no mesmo dia.
Como comparar pontuações de miniaturas sem se enganar
- Pontue todas as versões que deseja comparar na mesma sessão, para que sejam lidas pela mesma versão da análise.
- Altere uma coisa de cada vez. Se o título e a imagem mudarem juntos, uma diferença não pode dizer qual mudança a causou.
- Ignore diferenças de 1 a 3 pontos. Trate essas versões como iguais e escolha com base em outros critérios, como quão claramente cada uma declara o que o vídeo oferece.
- Aja com diferenças de 4 pontos ou mais, e dê mais peso às maiores. Você pode pontuar duas versões da sua miniatura lado a lado e ler a diferença segundo esta regra.
- Confirme com dados reais. Uma pontuação ordena opções antes da publicação; os resultados do seu próprio canal após a publicação decidem. Nosso guia sobre como saber se o resultado de um teste de miniatura é real aborda como fazer isso.
Limites desses números
As execuções repetidas usaram um conjunto pequeno e fixo de casos de teste, cada um perguntado duas vezes, então a média e o pior caso mudarão à medida que mais execuções forem adicionadas. A tabela de diferenças vem de um estudo de canais estabelecidos em inglês, em que nenhum segmento menor foi validado por si só. Uma pontuação ordena duas opções; ela não prevê visualizações ou taxa de cliques, e nada aqui muda isso.
Perguntas frequentes
Por que minha miniatura recebeu uma pontuação diferente da segunda vez?
Se algo na solicitação mudou, como o arquivo de imagem, o título ou a versão da nossa análise, foi uma nova pergunta e o modelo a leu novamente. Modelos grandes não retornam exatamente a mesma resposta a uma solicitação repetida, mesmo com temperatura 0. Uma imagem e título idênticos enviados novamente retornam a resposta armazenada em vez disso.
Quanto uma pontuação de IA pode variar para a mesma imagem?
Em nossas execuções repetidas, duas respostas para a mesma solicitação diferiram em cerca de 3 pontos em média, e em até 16 pontos no pior caso. A diferença média foi pequena, mas uma única comparação pode cair em uma grande, por isso pequenas diferenças não devem decidir nada.
Definir a temperatura como 0 torna a pontuação por IA consistente?
Não. Temperatura 0 remove a amostragem, mas a aritmética interna do modelo ainda varia com a forma como os servidores agrupam solicitações. Quando duas palavras possíveis estão quase empatadas, isso é suficiente para mudar qual o modelo escreve, e com isso a pontuação.
Quantos pontos de diferença devem ter duas miniaturas antes de eu escolher uma?
Pelo menos 4. Em nosso estudo de vídeos reais, diferenças de 1 a 3 pontos não puderam ser distinguidas do acaso, e o próprio modelo varia cerca de 3 pontos entre repetições. A partir de 4 pontos, a pontuação mais alta estava certa cerca de duas vezes em três, mais para diferenças maiores.
Posso comparar uma pontuação do mês passado com uma de hoje?
Somente com cautela. Se mudamos o modelo ou suas instruções entre elas, as duas pontuações vêm de versões diferentes da análise. Re-pontue ambas as versões no mesmo dia quando a comparação for importante.