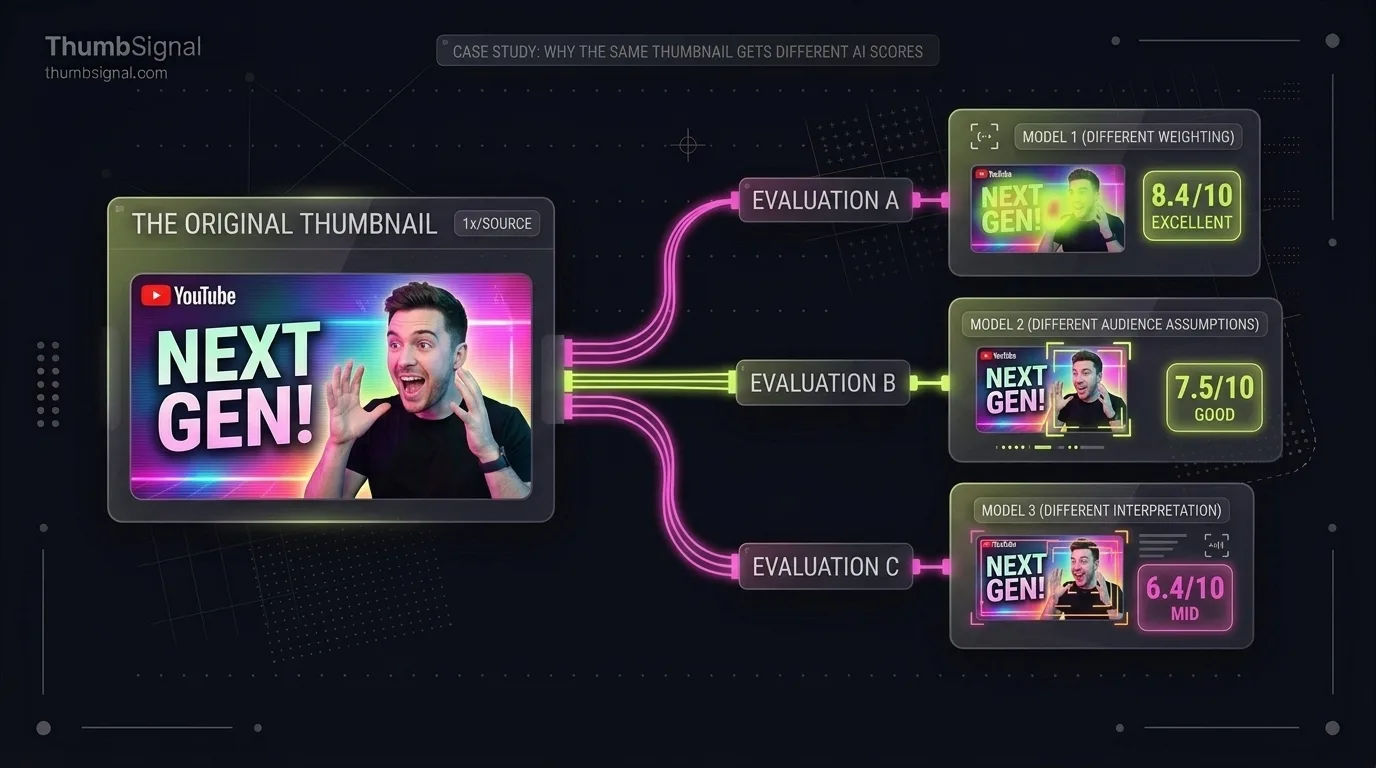
Fragen Sie ein KI-Modell, das gleiche Thumbnail und den gleichen Titel zweimal zu bewerten, und Sie erhalten möglicherweise zwei unterschiedliche Zahlen. Unseres gab einmal 71, dann 68 für dieselbe Anfrage zurück. Dies ist kein Fehler eines Tools. So funktionieren große Modelle auf geteilten Servern – und selbst bei Temperatur 0 verschwindet dieser Effekt nicht. Wichtig ist, die Größe der Schwankungen zu kennen und jeden Score mit diesem Spielraum im Hinterkopf zu lesen.
Wichtigste Erkenntnisse
- Das Modell hinter unserem Score gab bei identischen Anfragen unterschiedliche Antworten: im Durchschnitt etwa 3 Punkte auseinander, wenn wir zweimal fragten, und bis zu 16 Punkte im schlimmsten Fall, den wir gemessen haben.
- Temperatur 0 macht ein großes Modell nicht deterministisch. Die Variation kommt von der Art, wie die Berechnung auf den Servern gebündelt wird, nicht von zufälliger Stichprobenziehung.
- In unserer Studie realer Videos desselben Kanals konnten Score-Unterschiede von 1 bis 3 Punkten nicht von Zufall unterschieden werden. Ab 4 Punkten gehörte der höhere Score etwa zweimal von drei Malen zum besser performenden Video.
- Unser Analyzer speichert jetzt jede Antwort und gibt sie zurück, wenn Sie das exakt gleiche Bild und den gleichen Titel erneut einreichen – so zeigt eine Wiederholung denselben Score statt einer neuen Ziehung.
- Jede Änderung, selbst das erneute Speichern des Bildes, ist eine neue Frage und erhält eine neue Bewertung. Vergleichen Sie Versionen anhand von Unterschieden von mehreren Punkten, niemals anhand von ein oder zwei.
Warum ändert sich der KI-Thumbnail-Score, obwohl nichts geändert wurde?
Weil die Arithmetik des Modells nicht perfekt wiederholbar ist. Große Modelle laufen auf Servern, die viele Anfragen gemeinsam verarbeiten, und die Reihenfolge, in der Millionen kleiner Berechnungen aufaddiert werden, variiert von einem Batch zum nächsten. Diese winzigen Rundungsunterschiede spielen selten eine Rolle, aber ein Score wird aus vielen Wörtern aufgebaut, die das Modell nacheinander schreibt – und ein Wort, das nahe einer Schwelle in die andere Richtung kippt, kann einen Teilscore um mehrere Punkte verschieben.
Wir entdeckten dies auf übliche Weise: dasselbe Thumbnail und derselbe Titel, zweimal analysiert, ergaben 71 und dann 68. Nichts in unserem eigenen Code war zufällig. Der Prompt wird durch feste Regeln erstellt, die Arithmetik nach dem Modell ist einfache Arithmetik, und das Modell wurde bereits bei Temperatur 0 aufgerufen – der Einstellung, die normalerweise als „keine Zufälligkeit“ beschrieben wird. Der Unterschied kam vollständig von der Modellseite des Aufrufs.
Temperatur 0 ist nicht dasselbe wie deterministisch
Temperatur steuert die Stichprobenziehung: wie oft ein Modell ein Wort außer seiner Top-Wahl wählt. Bei 0 nimmt es immer die Top-Wahl. Aber „Top-Wahl“ wird durch Zahlen bestimmt, die auf Hardware berechnet werden, wo sich die Reihenfolge der Additionen mit der Auslastung verschiebt – daher können zwei Läufe bei fast gleich starken Kandidaten darüber uneinig sein, welches Wort an der Spitze steht. Deshalb kann dieselbe Anfrage selbst bei ausgeschalteter Stichprobenziehung leicht unterschiedlichen Text und leicht unterschiedliche Scores erzeugen.
Dies gilt für jedes Tool, das ein großes Modell nach einer Zahl fragt – einschließlich allgemeiner Chat-Assistenten, die Sie fragen könnten, „dieses Thumbnail von 10 zu bewerten“. Wenn ein Tool Ihnen nie zweimal dieselbe Antwort zeigt, ist das kein Beweis für Unzuverlässigkeit. Wenn es Ihnen eine präzise Zahl ohne Spielraum anzeigt, behauptet diese Zahl mehr, als das Modell liefern kann.
Wie groß ist der Unterschied tatsächlich?
Wir messen dies als Teil unserer Evaluierungsläufe, die einen festen Satz von Testfällen durch das reale Modell schicken und aufzeichnen, was zurückkommt. Jeder Fall wird zweimal abgefragt, und wir vergleichen die beiden globalen Scores.
Was die Wiederholungsläufe zeigten
Bei einem Lauf mit 26 Testfällen Anfang Oktober 2026 unterschieden sich die beiden Antworten auf dieselbe Anfrage im Durchschnitt um etwa 3 Punkte, und der schlechteste Einzelfall bewegte sich um 16 Punkte. Ein zweiter Lauf mit einer kleineren Fallmenge zwei Tage später zeigte dasselbe Bild: ein durchschnittlicher Abstand nahe 3 Punkten und ein Fall, der sich um 10 Punkte bewegte.
Drei Punkte klingen klein auf einer 100-Punkte-Skala. Sie klingen nicht mehr klein, sobald man sie mit den Unterschieden vergleicht, die Menschen nutzen, um Entscheidungen auf Basis von Scores zu treffen. Zwei Thumbnail-Entwürfe mit 64 und 66 Punkten sind anhand dieser Daten derselbe Score, zweimal abgefragt.
Welche Score-Unterschiede bedeuten etwas?
Wiederholbarkeit ist die eine Hälfte der Frage. Die andere Hälfte ist, ob ein Unterschied etwas über die reale Performance vorhersagt. Unsere Studie von 321 Paaren realer Videos verglich zwei Uploads desselben Kanals, die kurz nacheinander veröffentlicht wurden, und prüfte, ob das höher bewertete Video dasjenige war, das die eigene Baseline des Kanals übertraf. Aufgeteilt nach der Größe des Abstands zwischen den beiden Scores, sahen die Ergebnisse so aus.
| Abstand zwischen den beiden Scores | Paare | Höherer Score gehörte zum besseren Video | 95%-Intervall |
|---|---|---|---|
| Unentschieden | 17 | niemals, Unentschieden zählen als Fehlversuche | |
| 1 bis 3 Punkte | 91 | 56,0% | 45,8% bis 65,8% |
| 4 bis 7 Punkte | 92 | 64,1% | 53,9% bis 73,2% |
| 8 bis 14 Punkte | 87 | 63,2% | 52,7% bis 72,6% |
| 15 Punkte oder mehr | 34 | 76,5% | 60,0% bis 87,6% |
Ein Abstand von 1 bis 3 Punkten war 56 % der Zeit richtig, und sein Intervall enthält 50 %: Er lässt sich nicht von einem Münzwurf unterscheiden. Ab 4 Punkten gehörte der höhere Score etwa zweimal von drei Malen zum besseren Video, und die größten Abstände performten noch besser. Der Median-Abstand in der Studie betrug 6 Punkte. Dies sind explorative Aufschlüsselungen einer Studie an etablierten englischsprachigen Kanälen – lesen Sie sie als Richtlinie für die Skalierung, nicht als exakte Schwellenwerte.
Die beiden Zahlen deuten auf dieselbe Regel hin
Die Wiederholungsläufe sagen, dass ein Score um etwa 3 Punkte allein schwanken kann. Die Studie sagt, dass Abstände unter 4 Punkten nicht vorhersagen, welches Video besser performt. Beide deuten auf dieselbe Faustregel hin: Behandeln Sie zwei Scores, die innerhalb von 3 Punkten zueinander liegen, als gleich, und handeln Sie erst ab einem Unterschied von 4 Punkten oder mehr.
Was unser Analyzer dagegen tut
Jede Antwort wird gegen einen Fingerabdruck der exakten Anfrage gespeichert: die Bilddatei, der Titel, das Modell und die an es gesendeten Anweisungen. Wenn Sie dasselbe Bild und denselben Titel erneut einreichen, gibt der Analyzer die gespeicherte Antwort zurück, statt das Modell ein zweites Mal zu fragen. Sie sehen denselben Score wie zuvor, und eine solche Wiederholung verbraucht normalerweise keine Ihrer Analysen.
Was immer noch einen neuen Score erzeugt
- Eine andere Bilddatei, selbst wenn sie identisch aussieht. Neues Exportieren oder Komprimieren eines Thumbnails ändert seine Bytes, und der Analyzer sieht ein neues Bild.
- Jede Änderung am Titel, einschließlich Interpunktion oder Groß-/Kleinschreibung.
- Eine Änderung auf unserer Seite am Modell oder an seinen Anweisungen. Wenn wir sie ändern, passen frühere Antworten nicht mehr, und die nächste Anfrage erhält eine neue Bewertung.
Der letzte Punkt bedeutet, dass ein Score von vor einem Monat und ein Score von heute möglicherweise nicht direkt vergleichbar sind, wenn sich die Analyse dazwischen geändert hat. Wir protokollieren, welche Version der Analyse jedes Ergebnis erzeugt hat, damit wir es erkennen können – aber der praktische Rat ist einfacher: Wenn Sie zwei Versionen Ihres Packagings vergleichen, bewerten Sie beide am selben Tag.
Wie Sie Thumbnail-Scores vergleichen, ohne sich selbst zu täuschen
- Bewerten Sie alle Versionen, die Sie vergleichen möchten, in derselben Sitzung, damit sie von derselben Version der Analyse gelesen werden.
- Ändern Sie jeweils nur eine Sache. Wenn Titel und Bild beide geändert werden, kann ein Abstand nicht zeigen, welche Änderung ihn verursacht hat.
- Ignorieren Sie Abstände von 1 bis 3 Punkten. Behandeln Sie diese Versionen als gleich und wählen Sie nach anderen Kriterien, wie z. B. wie klar jede Version vermittelt, was das Video bietet.
- Handeln Sie bei Abständen von 4 Punkten oder mehr und geben Sie größeren Abständen mehr Gewicht. Sie können zwei Versionen Ihres Thumbnails nebeneinander bewerten und den Abstand anhand dieser Regel lesen.
- Bestätigen Sie mit echten Daten. Ein Score ordnet Optionen vor der Veröffentlichung; die Ergebnisse Ihres eigenen Kanals nach der Veröffentlichung entscheiden. Unser Leitfaden zu der Überprüfung, ob ein Thumbnail-Testergebnis echt ist, behandelt, wie.
Grenzen dieser Zahlen
Die Wiederholungsläufe verwendeten einen kleinen, festen Satz von Testfällen, die jeweils zweimal abgefragt wurden – daher werden sich Durchschnitt und schlechtester Fall mit weiteren Läufen verschieben. Die Abstandstabelle stammt aus einer Studie etablierter englischsprachiger Kanäle, bei der kein kleineres Segment einzeln validiert wurde. Ein Score ordnet zwei Optionen – er prognostiziert keine Aufrufe oder Klickrate, und nichts hier ändert das.
Häufig gestellte Fragen
Warum erhielt mein Thumbnail beim zweiten Mal einen anderen Score?
Wenn sich irgendetwas an der Anfrage geändert hat – wie die Bilddatei, der Titel oder die Version unserer Analyse –, war es eine neue Frage, und das Modell las sie erneut. Große Modelle geben selbst bei Temperatur 0 nicht exakt dieselbe Antwort auf eine wiederholte Anfrage. Ein identisches Bild und ein identischer Titel, erneut eingereicht, geben die gespeicherte Antwort zurück.
Wie stark kann ein KI-Score für dasselbe Bild variieren?
In unseren Wiederholungsläufen unterschieden sich zwei Antworten auf dieselbe Anfrage im Durchschnitt um etwa 3 Punkte und bis zu 16 Punkte im schlechtesten Fall. Der durchschnittliche Unterschied war klein, aber ein einzelner Vergleich kann auf einen großen treffen – daher sollten kleine Abstände nichts entscheiden.
Macht die Einstellung der Temperatur auf 0 die KI-Bewertung konsistent?
Nein. Temperatur 0 entfernt die Stichprobenziehung, aber die interne Arithmetik des Modells variiert weiterhin je nachdem, wie Server Anfragen bündeln. Wenn zwei mögliche Wörter fast gleich stark sind, reicht das aus, um zu ändern, welches das Modell schreibt – und damit auch den Score.
Wie viele Punkte sollten zwei Thumbnails auseinanderliegen, bevor ich eine auswähle?
Mindestens 4. In unserer Studie realer Videos konnten Abstände von 1 bis 3 Punkten nicht von Zufall unterschieden werden, und das Modell selbst variiert bei Wiederholungen um etwa 3 Punkte. Ab 4 Punkten war der höhere Score etwa zweimal von drei Malen richtig, bei größeren Abständen noch häufiger.
Kann ich einen Score von letztem Monat mit einem von heute vergleichen?
Nur mit Vorsicht. Wenn wir das Modell oder seine Anweisungen dazwischen geändert haben, stammen die beiden Scores aus unterschiedlichen Versionen der Analyse. Bewerten Sie beide Versionen am selben Tag, wenn der Vergleich wichtig ist.