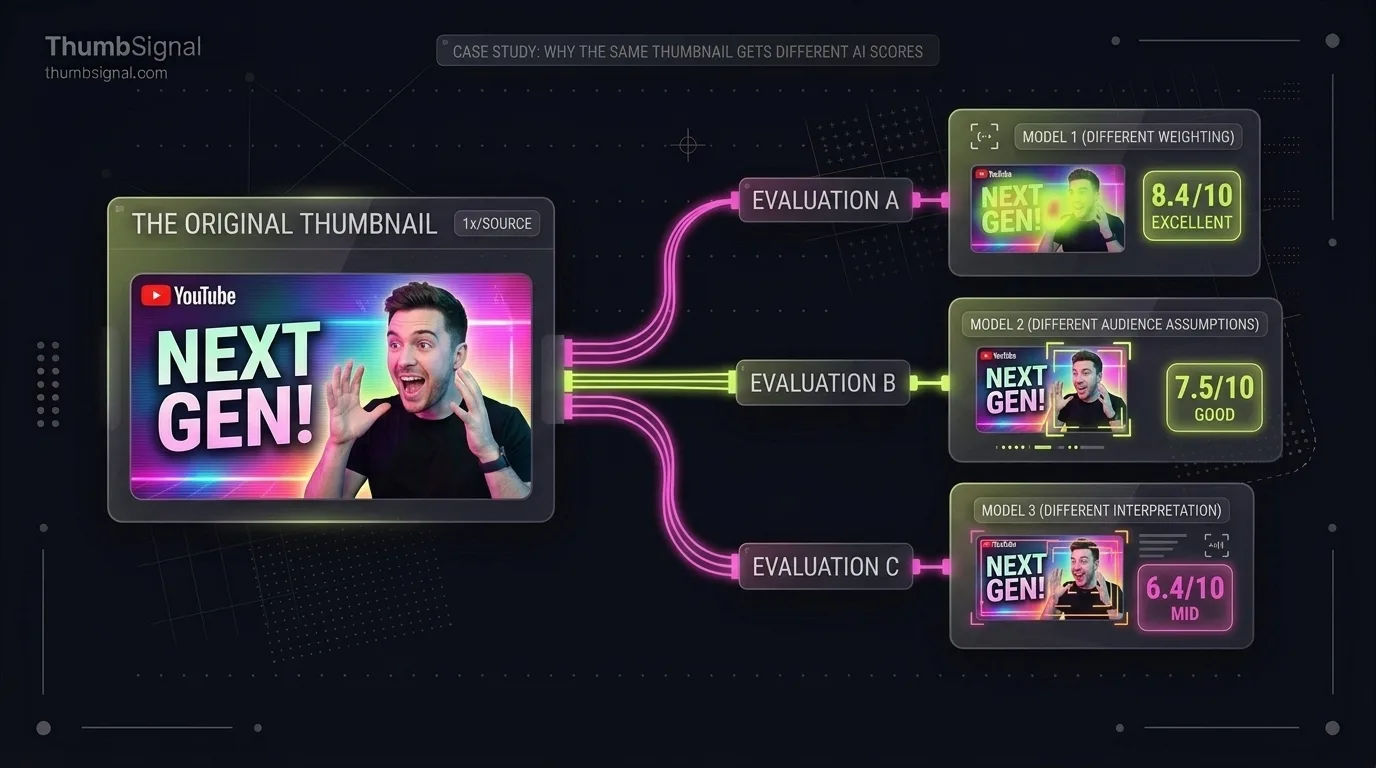
Demandez à un modèle IA d’évaluer la même miniature et le même titre deux fois, et vous pouvez obtenir deux chiffres différents. Le nôtre a déjà renvoyé 71, puis 68, pour une même requête. Ce n’est pas un bug dans un outil. C’est ainsi que fonctionnent les grands modèles sur du matériel partagé, et régler la température à zéro ne l’élimine pas. Ce qui compte, c’est de savoir à quel point la fluctuation est importante, et d’interpréter chaque score en tenant compte de cette marge.
Points clés
- Le modèle derrière notre score a donné des réponses différentes à des requêtes identiques : environ 3 points d’écart en moyenne lorsque nous avons demandé deux fois, et jusqu’à 16 points dans le pire cas que nous avons mesuré.
- Une température à 0 ne rend pas un grand modèle déterministe. La variation provient de la façon dont les calculs sont regroupés sur les serveurs, et non d’un échantillonnage aléatoire.
- Dans notre étude de vidéos réelles d’une même chaîne, des écarts de score de 1 à 3 points ne pouvaient pas être distingués du hasard. À partir de 4 points, le score le plus élevé correspondait à la vidéo la plus performante environ deux fois sur trois.
- Notre analyseur stocke désormais chaque réponse et la renvoie lorsque vous soumettez à nouveau exactement la même image et le même titre, afin qu’un test répété affiche le même score au lieu d’un nouveau tirage.
- Tout changement, même le réenregistrement de l’image, constitue une nouvelle question et génère une nouvelle lecture. Comparez les versions par écarts de plusieurs points, jamais par un ou deux points.
Pourquoi le score IA d’une miniature change-t-il alors que rien n’a changé ?
Parce que les calculs du modèle ne sont pas parfaitement reproductibles. Les grands modèles s’exécutent sur des serveurs qui traitent de nombreuses requêtes simultanément, et l’ordre dans lequel des millions de petits calculs sont additionnés varie d’un lot à l’autre. Ces minuscules différences d’arrondi importent rarement, mais un score est construit à partir de nombreux mots que le modèle génère un par un, et un mot qui bascule d’un côté ou de l’autre près d’un seuil peut déplacer un sous-score de plusieurs points.
Nous avons découvert cela de manière ordinaire : la même miniature et le même titre, analysés deux fois, ont renvoyé 71 puis 68. Rien dans notre propre code n’était aléatoire. Le prompt est construit selon des règles fixes, les calculs après le modèle sont des opérations arithmétiques simples, et le modèle était déjà appelé à température 0, le paramètre généralement décrit comme « sans aléatoire ». La différence provenait entièrement du côté du modèle.
Température 0 ne signifie pas déterministe
La température contrôle l’échantillonnage : la fréquence à laquelle le modèle choisit un mot autre que son choix principal. À 0, il prend toujours le choix principal. Mais « choix principal » est déterminé par des nombres calculés sur du matériel où l’ordre des additions varie selon la charge, donc deux exécutions peuvent ne pas s’accorder sur quel mot est en tête lorsque deux candidats sont presque à égalité. C’est pourquoi la même requête peut produire un texte légèrement différent, et des scores légèrement différents, même avec l’échantillonnage désactivé.
Cela s’applique à tout outil qui demande à un grand modèle un nombre, y compris les assistants conversationnels généraux auxquels vous pourriez demander de « noter cette miniature sur 10 ». Si un outil ne vous montre jamais la même réponse deux fois, ce n’est pas une preuve qu’il est peu fiable. S’il vous montre un nombre précis sans marge, ce nombre prétend plus que ce que le modèle peut fournir.
À quel point la différence est-elle réellement importante ?
Nous mesurons cela dans le cadre de nos exécutions d’évaluation, qui envoient un ensemble fixe de cas de test au modèle réel et enregistrent les réponses. Chaque cas est demandé deux fois, et nous comparons les deux scores globaux.
Ce que les exécutions répétées ont montré
Lors d’une série de 26 cas de test début octobre 2026, les deux réponses à la même requête différaient en moyenne d’environ 3 points, et le pire cas unique a varié de 16 points. Une seconde série sur un ensemble plus restreint de cas deux jours plus tard a donné le même résultat : un écart moyen proche de 3 points et un cas qui a varié de 10 points.
Trois points semblent petits sur une échelle de 100 points. Cela cesse de paraître petit une fois comparé aux différences que les gens utilisent pour décider. Deux brouillons de miniature notés 64 et 66 sont, selon ces données, le même score demandé deux fois.
Quels écarts de score ont une signification
La reproductibilité est une moitié de la question. L’autre moitié est de savoir si un écart prédit quelque chose sur la performance réelle. Notre étude de 321 paires de vidéos réelles comparait deux vidéos d’une même chaîne, publiées à peu près en même temps, et vérifiait si celle qui avait le score le plus élevé était celle qui avait dépassé la référence propre à la chaîne. Répartis selon la taille de l’écart entre les deux scores, les résultats sont les suivants.
| Écart entre les deux scores | Paires | Le score le plus élevé correspondait à la meilleure vidéo | Intervalle à 95 % |
|---|---|---|---|
| Égalité | 17 | jamais, les égalités sont comptées comme des échecs | |
| 1 à 3 points | 91 | 56,0 % | 45,8 % à 65,8 % |
| 4 à 7 points | 92 | 64,1 % | 53,9 % à 73,2 % |
| 8 à 14 points | 87 | 63,2 % | 52,7 % à 72,6 % |
| 15 points ou plus | 34 | 76,5 % | 60,0 % à 87,6 % |
Un écart de 1 à 3 points était correct 56 % du temps, et son intervalle inclut 50 % : il ne peut pas être distingué d’un tirage au sort. À partir de 4 points, le score le plus élevé correspondait à la meilleure vidéo environ deux fois sur trois, et les plus grands écarts faisaient encore mieux. L’écart médian dans l’étude était de 6 points. Il s’agit de décompositions exploratoires d’une seule étude sur des chaînes anglophones établies, donc considérez-les comme un guide d’échelle plutôt que comme des seuils exacts.
Les deux chiffres pointent vers la même règle
Les exécutions répétées indiquent qu’un score peut varier d’environ 3 points de lui-même. L’étude indique que les écarts inférieurs à 4 points ne prédisent pas quelle vidéo performe mieux. Les deux pointent vers la même règle empirique : considérez deux scores à moins de 3 points l’un de l’autre comme égaux, et n’agissez que sur une différence de 4 points ou plus.
Ce que fait notre analyseur à ce sujet
Chaque réponse est stockée en fonction d’une empreinte de la requête exacte : le fichier image, le titre, le modèle et les instructions qui lui sont envoyées. Lorsque vous soumettez à nouveau la même image et le même titre, l’analyseur renvoie la réponse stockée au lieu de demander au modèle une seconde fois. Vous voyez le même score que précédemment, et une répétition de ce type ne consomme généralement pas une de vos analyses.
Ce qui produit encore un nouveau score
- Un fichier image différent, même s’il semble identique. Réexporter ou recompresser une miniature modifie ses octets, et l’analyseur voit une nouvelle image.
- Tout changement au titre, y compris la ponctuation ou la casse.
- Un changement de notre côté du modèle ou de ses instructions. Lorsque nous les modifions, les réponses antérieures ne correspondent plus, et la prochaine requête obtient une nouvelle lecture.
Ce dernier point signifie qu’un score d’il y a un mois et un score d’aujourd’hui peuvent ne pas être directement comparables si l’analyse a changé entre-temps. Nous enregistrons quelle version de l’analyse a produit chaque résultat, donc nous pouvons le dire, mais le conseil pratique est plus simple : lorsque vous comparez deux versions de votre packaging, évaluez-les toutes les deux le même jour.
Comment comparer les scores de miniatures sans vous tromper
- Évaluez toutes les versions que vous souhaitez comparer lors de la même session, afin qu’elles soient lues par la même version de l’analyse.
- Modifiez une chose à la fois. Si le titre et l’image changent tous les deux, un écart ne peut pas vous dire quelle modification en est la cause.
- Ignorez les écarts de 1 à 3 points. Traitez ces versions comme égales et choisissez selon d’autres critères, comme la clarté avec laquelle chacune indique ce que la vidéo propose.
- Agissez sur les écarts de 4 points ou plus, et accordez plus de poids aux grands écarts. Vous pouvez évaluer deux versions de votre miniature côte à côte et interpréter l’écart selon cette règle.
- Confirmez avec des données réelles. Un score classe les options avant publication ; les résultats de votre propre chaîne après publication décident. Notre guide sur comment savoir si un résultat de test miniature est réel explique comment faire.
Limites de ces chiffres
Les exécutions répétées ont utilisé un petit ensemble fixe de cas de test, chacun demandé deux fois, donc la moyenne et le pire cas évolueront à mesure que d’autres exécutions seront ajoutées. Le tableau des écarts provient d’une seule étude sur des chaînes anglophones établies, dans laquelle aucun segment plus petit n’est validé individuellement. Un score classe deux options ; il ne prévoit pas les vues ou le taux de clic, et rien ici ne change cela.
Questions fréquentes
Pourquoi ma miniature a-t-elle obtenu un score différent la deuxième fois ?
Si quelque chose dans la requête a changé, comme le fichier image, le titre ou la version de notre analyse, il s’agissait d’une nouvelle question et le modèle l’a relue. Les grands modèles ne renvoient pas exactement la même réponse à une requête répétée, même à température 0. Une image et un titre identiques soumis à nouveau renvoient la réponse stockée.
De combien un score IA peut-il varier pour la même image ?
Dans nos exécutions répétées, deux réponses à la même requête différaient en moyenne d’environ 3 points, et jusqu’à 16 points dans le pire cas. L’écart moyen était faible, mais une seule comparaison peut tomber sur une grande, c’est pourquoi les petits écarts ne devraient pas décider quoi que ce soit.
La température à 0 rend-elle le scoring IA cohérent ?
Non. La température 0 supprime l’échantillonnage, mais les calculs internes du modèle varient encore selon la façon dont les serveurs regroupent les requêtes. Lorsque deux mots possibles sont presque à égalité, cela suffit à changer celui que le modèle écrit, et donc le score.
À combien de points d’écart dois-je attendre avant de choisir une miniature ?
Au moins 4. Dans notre étude de vidéos réelles, les écarts de 1 à 3 points ne pouvaient pas être distingués du hasard, et le modèle lui-même varie d’environ 3 points entre les répétitions. À partir de 4 points, le score le plus élevé était correct environ deux fois sur trois, davantage pour les grands écarts.
Puis-je comparer un score d’il y a un mois avec un score d’aujourd’hui ?
Seulement avec prudence. Si nous avons modifié le modèle ou ses instructions entre-temps, les deux scores proviennent de versions différentes de l’analyse. Réévaluez les deux versions le même jour lorsque la comparaison est importante.