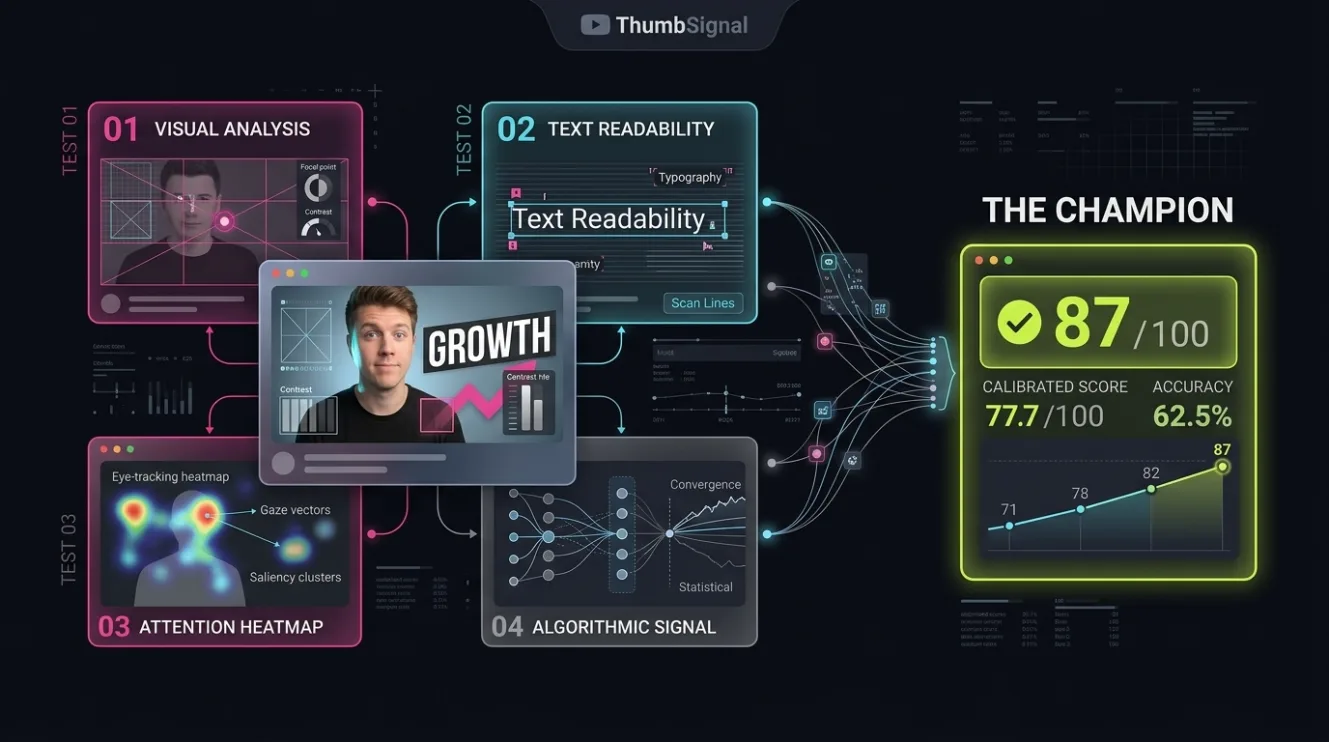
321組の実際の動画対を用いてサムネイルスコアをテストした後、より正確にする方法を4つ試みました。そのうち1つは数値を動かし、検証の結果、より公正な測定方法であり、モデルの改善ではなかったことがわかりました。残りの3つは効果がなく、あるいはスコアの信頼性を低下させました。それぞれの結果と数値を以下に示します。
主要なポイント
- 四捨五入せず、小数点まで含めてスコアを比較することで、測定精度が59.5%から62.0%に向上しました。これは17件の同点がほぼ均等に割れた結果です。
- スコアリング指示を書き直したものは、30件のサムネイルでは画期的に見えましたが、322件では効果がなく、161組で64.6%から63.4%にわずかに低下しました。
- AIに2つのサムネイルを直接比較させた結果、平均的な正解率は62.7%で通常のスコアと同等でしたが、回答は画像の表示順に依存しました。
- モデルの「推論モード」設定は、最も高いレベルを除いて何の変化ももたらしませんでした。そして、その最高レベルは、EU内にアップロードを留めるために使用している地域では回答を返しませんでした。
- 公開済みの事前登録結果は59.5%のままです。ここに記載されているすべての内容はフォローアップ作業であり、そのように明記されています。
テスト済みのサムネイルスコアはさらに正確にできるのか?
私たちのケースでは、簡単ではありませんでした。実際の動画に対して試した4つの変更のうち、1つだけが測定精度を59.5%から62.0%に引き上げました。しかし、それはモデルが新しいことを「見る」ようになったのではなく、スコアの比較方法を修正した結果でした。残りの3つは精度に変化をもたらしませんでした。このモデルが達成できる限界に近いようです。
これは新しい記録を打ち立てるほど華やかな答えではありませんが、より実用的です。どこに努力を向けるべきでないかを示し、なぜ各魅力的なアイデアが失敗したかを説明します。これはこの1つのスコアに限らず、自身のサムネイルをテストするクリエイターにも共通する落とし穴です。
効果があった修正:比較前に四捨五入しない
表示されるスコアは0~100の整数です。元のテストでは、対になった2つの動画が同じ整数値になることがあり、321組中17回発生しました。事前登録されたルールでは、同点はすべて失敗とカウントされました。なぜなら、2つの動画を区別できないスコアは、差別化に成功していないと考えたからです。
整数値の裏には正確な数値があり、四捨五入するとその差が失われます。正確な値を比較すると同点は一切なくなり、測定精度は59.5%から62.0%に上昇します(321組中199組、従来の191組から)。動画の再スコアリングや重み付けの変更は一切行っていません。正確な値はすでに存在していたのです。
なぜこれはより公正な数値であり、より優れたモデルではないのか
当然の疑問は、この17件の同点がどのように割れたかです。もしモデルが静かに正解していたなら、四捨五入は実際の能力を隠していたことになります。しかし、実際にはそうではありませんでした。17件中8件はパフォーマンスの高い動画に、9件はそうではない動画に割れ、これはコイン投げの結果とほぼ同じです。
したがって、向上は「コイン投げ」を自動的に失敗と見なさなくなったことによるものであり、モデルがより多くを知るようになったからではありません。そのため、公開結果は59.5%のままです。これはデータを見る前に事前に定めたルールに基づいてコミットした数値です。62.0%は明確にラベル付けされたフォローアップ測定値として報告され、同じモデルを記述しています。
指示の調整:小さなパイロットが画期的に見えた
モデルの評価値は密集しています。スコアの基となる12の要因のいくつかは、何百もの実際のサムネイルにわたって狭い範囲に集中しており、元のテストでは、2つの動画を大きく離して評価する場合にスコアが最も信頼できることが示されました。そこで、スケールに基準点を設けました:50は同じフィード内の典型的な動画、90以上は上位10%に限定するというものです。
30件のサムネイルを両方のバージョンで評価したパイロットテストでは、効果があるように見えました。12の要因のうち8つが広がり、2つはほぼ倍に広がりました。その後、322件のサムネイルに新しい指示を適用しました。倍に広がったと見えた2つの要因は、広がりがそれぞれ1.1ポイントと0.1ポイントしか増えませんでした。161組では、元の指示が64.6%の正解率、新しい指示が63.4%で、差は偶然の範囲内でした。新しいバージョンはほぼすべての評価を5~7ポイント下げたため、クリエイターにとって何の利益もなく、スコアが下がるだけでした。
なぜ広がりが精度の向上につながらなかったのか
パイロットが小さすぎたのです。30件のサムネイルでは、評価値の広がりを測る指標は偶然で大きく変動し、2つの要因が倍になったのはその変動範囲内でした。パイロットはより大きなテストを行う理由として読むべきであり、結果として読むべきではありませんでした。
より大きなテストには2番目の教訓もありました。2つの要因、つまり「興味喚起」と「クリックベイトリスク」は、322件のサムネイルで実際に広がりましたが、ランキングは改善しませんでした。広がりが実際の動画の違いに沿っていなければ、広がりは意味がありません。ここではノイズに沿って広がっており、自信があるように見えるノイズは、何もないより悪いものです。
サムネイルを個別に評価するのではなく、直接比較する
各サムネイルを個別に評価してから数値を比較する方法は、人々がサムネイルを選ぶ方法ではありません。人々は2つを横並びで見ます。そこで、モデルにもそうしてもらいました:対になった2つの動画を提示し、どちらが優れていたかを判断させました。161組のそれぞれを、順番を変えて2回提示しました。
両方の順番の平均では、直接比較の判断者は62.7%の正解率で、同じ150組の完全回答ペアにおける通常のスコアと完全に一致しました。しかし、最初に見たサムネイルを選ぶ確率は64.7%で、約3分の1の対で順番によって逆の回答を出しました。同等の精度ながらはるかに不安定なため、採用されませんでした。詳細な結果は、AIにサムネイルを比較させるという別記事に記載されています。
モデルの推論モードをオンにする
モデルには、回答前に段階的に問題を解く設定があり、複数の努力レベルが用意されています。3つの低いレベルでは、テストサムネイルの完全な分析は、設定をオフにした場合と同じ12の評価値を返しました。最も高いレベルのみがモデルの挙動を変化させました。
EU内にアップロードを留めるために使用しているヨーロッパのデータセンターでは、最も高いレベルは3分間の繰り返し試行を経ても回答を返しませんでした。米国の地域で、サムネイルを含まない架空の算数問題で確認したところ、推論を回答の前にプレーンテキストで記述し、別々に保持しませんでした。米国にアップロードを移して効果を確認するのは、私たちが受け入れられないトレードオフでした。
4つの結果を並べて比較
各変更は、同じ対で元の結果と比較されたため、以下のすべての差異は同条件での比較です。
| 変更 | ランキング精度への影響 | 採用? |
|---|---|---|
| 四捨五入しないスコアを比較 | 321組で59.5%から62.0%に、すべて元の同点がほぼ均等に割れた結果 | はい、より公正な測定として |
| 調整済みスコアリング指示 | 161組で64.6%から63.4%、検出可能な差異なし | いいえ |
| サムネイルを直接比較 | 150組で62.7%対62.7%、回答は順番に依存 | いいえ |
| モデル推論モード | 動作するレベルでは変化なし、最高レベルは当該地域で回答を返さず | いいえ |
ここに記載されているすべての数値は、サムネイルとタイトルを分析する際に実行される同じスコアリングパイプラインから得られています。テストは製品自体を通じて実際の動画を評価したものであり、別途の研究用コピーではありません。
これらのフォローアップテストを正直に保つ方法
フォローアップ実験は、研究者が望む答えをすでに知っているため、通常は誤りを生みやすい分野です。5つのルールでそれを防ぎました:
- 公開済みの結果は一切変更しませんでした。事前登録された59.5%が見出しであり、その後の分析はすべてフォローアップ作業として明記されています。
- 変更をテストする前に、チャンネルを半分に分割しました。実験には片方を使用し、もう片方は最終チェック用に残しておきました。
- 各変更は、同じ対で元の結果と比較し、両者が異なる対のみをカウントしました。これは全体のパーセンテージを比較するよりもはるかに感度が高い方法です。
- 小さなパイロットは、より大きなテストを行う理由として扱い、結果として扱いませんでした。
- すべての直接比較は、両方の順番で提示され、位置の好みが能力と誤解されるのを防ぎました。
これらはいずれも統計学の学位を必要とせず、自身のサムネイルをテストするクリエイターにも直接適用できます:結果を見る前に何を「成功」とするかを決め、同条件で比較し、小さな初期結果はさらにテストを続ける理由とみなしてください。
これらのフォローアップ結果の限界
4つの実験すべては、元のテストと同じ確立された英語チャンネルと1つのモデルを使用しました。アイデアは元の結果が判明した後に選ばれたため、これは結果を過大評価しやすい状況であり、見出しが事前登録値のままであるもう1つの理由です。
各変更は1回、1つの形で試されました。指示の言い回しが異なれば結果が良かった可能性があり、推論モードの結果は2026年9月の1つの地域で利用可能な状態を記述しています。これらの結果はスコアが改善できないと主張するものではなく、これら4つの方法では改善されなかったことを示しています。
よくある質問
なぜ62.0%を精度として報告しないのか?
テストのルールはデータが存在する前に固定されており、同点は失敗としてカウントされました。結果を見てからルールを変更することは、事前登録が防ぐべき行為です。たとえ変更が理にかなっていてもです。62.0%は明確にラベル付けされたフォローアップ測定値として公開され、59.5%を置き換えるものではありません。
より賢いAIモデルならスコアの精度は上がるのか?
可能性はありますが、それは新しい実験です。私たちの現在のモデルの推論設定は、使用している地域では役に立ちませんでした。異なるモデルを使用する場合は、同じ対で同じ方法でテストしなければ、主張はできません。新しいからといって、この特定のタスクで自動的に優れているわけではありません。
なぜ30件のサムネイルのテストがそれほど説得力があったのか?
小さなサンプルでは偶然により大きな変動が生じ、大きな変動は発見のように見えます。30件のサムネイルでは、2つの要因が広がりを倍にしたように見えるのは、通常の変動範囲内でした。322件のサムネイルではその効果はほとんど消えました。これは、2つのアップロードで新しいサムネイルスタイルを判断するのと同じ落とし穴です。
これは自分のサムネイルをテストする上で何を意味するのか?
同じルールが適用されます。結果を見る前に成功の定義を決め、チャンネルの通常の範囲と比較し、偶然では説明できないほど十分な例を実行し、ツールに2つのオプションを比較させる場合は、順番を入れ替えても答えが変わらないか確認してください。
これらの改善が失敗した場合、スコアはまだ使う価値があるのか?
スコアは実際の結果に対してテストされ、偶然を明らかに上回りました。これらのフォローアップは、4つの魅力的な変更がさらに押し進めなかったことを示しており、それは捨てる理由ではなく、知る価値のあることです。視聴数の予測ではなく、複数の情報源の1つとして扱ってください。