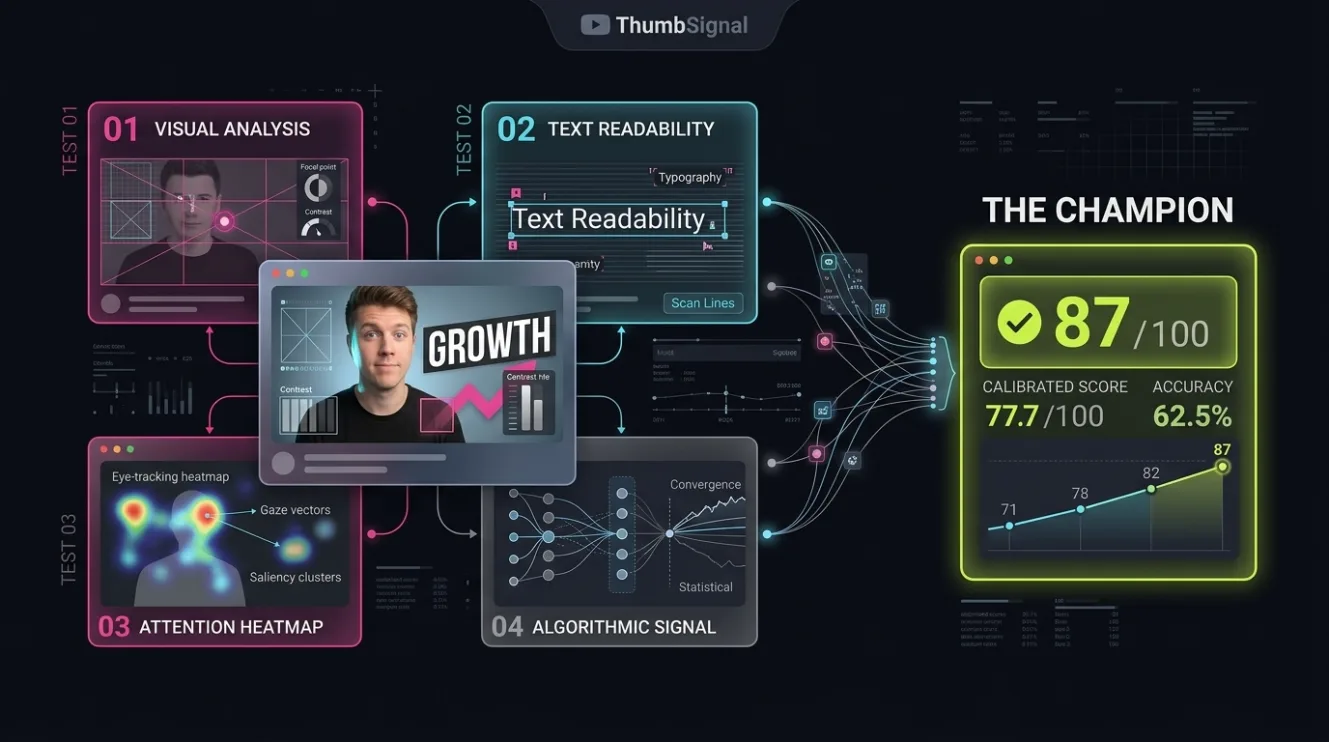
Sau khi kiểm tra điểm thumbnail của chúng tôi trên 321 cặp video thực tế, chúng tôi đã cố gắng làm cho nó chính xác hơn. Chúng tôi đã thử bốn cách. Một cách làm thay đổi con số, và khi kiểm tra kỹ, đó là phép đo công bằng hơn chứ không phải mô hình tốt hơn. Ba cách còn lại không thay đổi gì, hoặc khiến điểm số khó tin cậy hơn. Dưới đây là từng cách, kèm theo các con số.
Điểm chính
- So sánh điểm số ở độ chính xác đầy đủ thay vì làm tròn thành số nguyên đã nâng độ chính xác đo được từ 59,5% lên 62,0%, và toàn bộ sự gia tăng này đến từ 17 trường hợp hòa trước đó, được phân chia gần như đều đặn.
- Hướng dẫn chấm điểm được viết lại trông như bước đột phá trên 30 thumbnail, nhưng không có tác dụng gì trên 322: 64,6% trước và 63,4% sau, trên 161 cặp.
- Yêu cầu AI so sánh trực tiếp hai thumbnail cho kết quả trung bình khớp với điểm số thông thường, mỗi bên 62,7%, nhưng câu trả lời của nó phụ thuộc vào hình ảnh nào xuất hiện trước.
- Cài đặt lập luận của mô hình không thay đổi gì, ngoại trừ ở mức cao nhất — và mức này chưa bao giờ trả về câu trả lời trong khu vực châu Âu mà chúng tôi sử dụng để giữ tải lên trong EU.
- Kết quả đã công bố, được đăng ký trước, vẫn giữ ở mức 59,5%. Mọi thứ ở đây đều là công việc theo dõi và được ghi nhãn rõ ràng.
Liệu có thể làm cho điểm thumbnail chính xác hơn sau khi đã kiểm tra?
Không dễ dàng, trong trường hợp của chúng tôi. Trong bốn thay đổi chúng tôi kiểm tra trên video thực tế, một thay đổi nâng độ chính xác đo được, từ 59,5% lên 62,0%, và nó thực hiện điều đó bằng cách sửa cách so sánh điểm số thay vì khiến mô hình nhìn thấy điều gì mới. Ba thay đổi còn lại để nguyên độ chính xác. Điểm số dường như đã gần với giới hạn mà mô hình này có thể đạt được.
Đây là câu trả lời ít thú vị hơn một kỷ lục mới, nhưng hữu ích hơn. Nó cho biết nơi nào không nên bỏ công sức, và giải thích tại sao từng ý tưởng hấp dẫn lại thất bại. Điều này quan trọng không chỉ với điểm số này, mà còn vì những cái bẫy tương tự cũng bắt các nhà sáng tạo khi họ tự kiểm tra thumbnail của mình.
Thay đổi hiệu quả: ngừng làm tròn trước khi so sánh
Điểm số bạn thấy là một số nguyên từ 0 đến 100. Trong bài kiểm tra ban đầu của chúng tôi, hai video trong một cặp đôi khi rơi vào cùng một số nguyên, và điều này xảy ra 17 lần trong 321 cặp. Quy tắc đã đăng ký trước của chúng tôi coi mọi trường hợp hòa là thất bại, với lập luận rằng một điểm số không thể phân biệt hai video là chưa phân biệt được chúng.
Phía sau số nguyên là một giá trị chính xác, và việc làm tròn đã loại bỏ sự khác biệt đó. So sánh các giá trị chính xác sẽ không còn bất kỳ trường hợp hòa nào, và độ chính xác đo được tăng từ 59,5% lên 62,0%: 199 trong 321 cặp thay vì 191. Không có video nào được chấm lại và không có trọng số nào thay đổi; giá trị chính xác đã có sẵn.
Tại sao đây là con số công bằng hơn, không phải mô hình tốt hơn
Câu hỏi rõ ràng là 17 trường hợp hòa đó đã phân chia như thế nào. Nếu mô hình đã âm thầm chấm đúng chúng, thì việc làm tròn đã che giấu kỹ năng thực sự. Nhưng nó không như vậy. Tám trong số 17 trường hợp thuộc về video có hiệu suất tốt hơn và chín trường hợp không, gần như kết quả của một lần tung đồng xu.
Vì vậy, sự cải thiện đến từ việc không còn đánh dấu các lần tung đồng xu là thất bại tự động, chứ không phải vì mô hình biết thêm điều gì. Đó là lý do tại sao kết quả công bố vẫn giữ ở mức 59,5%: đó là con số chúng tôi cam kết trước, theo các quy tắc được viết ra trước khi chúng tôi nhìn thấy bất kỳ dữ liệu nào. Con số 62,0% được báo cáo như một phép đo theo dõi, được ghi nhãn rõ ràng, và mô tả cùng một mô hình.
Hiệu chỉnh hướng dẫn: một thử nghiệm nhỏ trông như bước đột phá
Đánh giá của mô hình có xu hướng dồn lại. Một số trong mười hai yếu tố mà điểm số được xây dựng từ đó nằm trong các dải hẹp trên hàng trăm thumbnail thực tế, và bài kiểm tra ban đầu của chúng tôi cho thấy điểm số đáng tin cậy nhất khi nó đặt hai video xa nhau. Vì vậy, chúng tôi đã viết lại hướng dẫn để cung cấp một điểm tham chiếu cho thang điểm: 50 nghĩa là video điển hình trong cùng luồng, 90 trở lên dành riêng cho top 10%.
Trong một thử nghiệm nhỏ gồm 30 thumbnail, được chấm theo cả hai phiên bản, trông như nó đã hoạt động. Tám trong mười hai yếu tố đã lan rộng ra, và hai trong số đó gần như nhân đôi phạm vi lan rộng. Sau đó, chúng tôi chạy hướng dẫn mới trên 322 thumbnail. Hai yếu tố đã gần như nhân đôi chỉ tăng thêm 1,1 và 0,1 điểm phạm vi lan rộng. Trên 161 cặp, hướng dẫn ban đầu chọn đúng video tốt hơn 64,6% thời gian và hướng dẫn mới là 63,4%, một sự khác biệt nằm trong phạm vi ngẫu nhiên. Phiên bản mới cũng làm giảm gần như mọi đánh giá từ năm đến bảy điểm, nên nó sẽ khiến mỗi nhà sáng tạo mất vài điểm mà không có lợi ích gì.
Tại sao phạm vi rộng hơn không có nghĩa là độ chính xác cao hơn
Thử nghiệm nhỏ quá nhỏ. Với 30 thumbnail, một thước đo về mức độ lan rộng của đánh giá có thể dao động mạnh do ngẫu nhiên, và hai yếu tố nhân đôi phạm vi nằm trong phạm vi dao động đó. Thử nghiệm nhỏ nên được đọc như một lý do để chạy một bài kiểm tra lớn hơn, chứ không phải là một kết quả.
Bài kiểm tra lớn hơn mang lại bài học thứ hai. Hai yếu tố, sự tò mò và rủi ro clickbait, thực sự đã lan rộng ra trên 322 thumbnail, nhưng xếp hạng vẫn không cải thiện. Phạm vi đánh giá rộng hơn chỉ hữu ích nếu độ rộng bổ sung phản ánh sự khác biệt thực sự giữa các video. Ở đây, nó phản ánh nhiễu, và nhiễu trông như sự tự tin thì còn tệ hơn là không có gì.
So sánh thumbnail trực tiếp thay vì chấm điểm từng cái
Chấm điểm từng thumbnail riêng lẻ rồi so sánh các con số không phải là cách mọi người chọn giữa các thumbnail; họ nhìn hai cái cạnh nhau. Vì vậy, chúng tôi yêu cầu mô hình làm điều đó: khi hiển thị cả hai video từ một cặp, cái nào vượt trội hơn? Mỗi trong 161 cặp được hiển thị hai lần, mỗi lần theo một thứ tự.
Trung bình trên cả hai thứ tự, người đánh giá trực tiếp đúng 62,7% thời gian, khớp chính xác với điểm số thông thường trên cùng 150 cặp được trả lời đầy đủ. Nhưng nó chọn thumbnail nào xuất hiện trước 64,7% thời gian, và với gần một phần ba số cặp, nó đưa ra câu trả lời ngược nhau chỉ dựa trên thứ tự. Độ chính xác bằng nhau nhưng ổn định kém hơn có nghĩa là nó không được áp dụng. Kết quả đầy đủ có trong bài viết riêng biệt của chúng tôi về việc yêu cầu AI so sánh thumbnail.
Bật chế độ lập luận của mô hình
Mô hình cung cấp một cài đặt khiến nó giải quyết vấn đề từng bước trước khi trả lời, ở nhiều mức độ nỗ lực. Ở ba mức thấp hơn, một phân tích đầy đủ của một thumbnail kiểm tra trả về cùng mười hai đánh giá như khi cài đặt bị tắt. Chỉ mức cao nhất mới thay đổi hành vi của mô hình.
Trong trung tâm dữ liệu châu Âu mà chúng tôi sử dụng, để đảm bảo thumbnail tải lên không bao giờ được xử lý bên ngoài EU, mức cao nhất này chưa bao giờ trả về câu trả lời, dù đã thử nhiều lần kéo dài đến ba phút. Chúng tôi xác nhận nó hoạt động ở khu vực Mỹ bằng một câu hỏi số học giả lập không liên quan đến thumbnail, và phát hiện nó viết lập luận dưới dạng văn bản thuần túy phía trước câu trả lời thay vì giữ riêng biệt. Việc chuyển tải lên sang Mỹ để tìm hiểu xem nó có giúp ích hay không không phải là sự đánh đổi mà chúng tôi sẵn sàng thực hiện.
Bốn kết quả đặt cạnh nhau
Mỗi thay đổi được so sánh với phiên bản gốc trên cùng các cặp, nên mọi sự khác biệt dưới đây đều là so sánh tương đương.
| Thay đổi | Tác động đến độ chính xác xếp hạng | Có giữ lại? |
|---|---|---|
| So sánh điểm số chưa làm tròn | 59,5% đến 62,0% trên 321 cặp, hoàn toàn từ các trường hợp hòa trước đó phân chia gần như đều | Có, như một phép đo công bằng hơn |
| Hướng dẫn chấm điểm được hiệu chỉnh | 64,6% đến 63,4% trên 161 cặp, không có sự khác biệt có thể phát hiện | Không |
| So sánh thumbnail trực tiếp | 62,7% so với 62,7% trên 150 cặp, với câu trả lời phụ thuộc vào thứ tự | Không |
| Chế độ lập luận mô hình | Không thay đổi ở các mức chạy được; mức cao nhất chưa bao giờ trả lời trong khu vực của chúng tôi | Không |
Mọi con số ở đây đều đến từ cùng một quy trình chấm điểm chạy khi bạn phân tích thumbnail và tiêu đề. Các bài kiểm tra chấm điểm các video thực tế thông qua sản phẩm chính, không thông qua một bản sao nghiên cứu riêng biệt.
Cách chúng tôi giữ cho các bài kiểm tra theo dõi này trung thực
Các thí nghiệm theo dõi là nơi các nghiên cứu thường sai, vì nhà nghiên cứu đã biết trước câu trả lời họ muốn. Năm quy tắc giữ cho điều đó được kiểm soát:
- Kết quả đã công bố không bao giờ bị thay đổi. Con số 59,5% đã đăng ký trước vẫn là tiêu đề chính, và mọi phân tích sau đó đều được ghi nhãn là công việc theo dõi.
- Các kênh được chia đôi trước khi bất kỳ thay đổi nào được kiểm tra. Các thí nghiệm sử dụng một nửa, và nửa còn lại được giữ lại để kiểm tra cuối cùng.
- Mỗi thay đổi được so sánh với phiên bản gốc trên cùng các cặp, chỉ đếm các cặp mà hai phiên bản không đồng ý, điều này nhạy cảm hơn nhiều so với so sánh hai phần trăm tổng thể.
- Một thử nghiệm nhỏ được coi là lý do để chạy một bài kiểm tra lớn hơn, không bao giờ được coi là kết quả riêng biệt.
- Mọi so sánh trực tiếp đều được hiển thị ở cả hai thứ tự, để sở thích vị trí không thể được coi là kỹ năng.
Không cần bằng thống kê để áp dụng những quy tắc này, và hầu hết chúng có thể áp dụng trực tiếp cho nhà sáng tạo khi kiểm tra thumbnail của chính họ: quyết định trước khi xem điều gì được coi là chiến thắng, so sánh tương đương với tương đương, và coi kết quả ban đầu nhỏ là lý do để tiếp tục kiểm tra.
Giới hạn của các kết quả theo dõi này
Tất cả bốn thí nghiệm đều sử dụng cùng các kênh tiếng Anh đã được thiết lập như bài kiểm tra ban đầu, và một mô hình. Các ý tưởng được chọn sau khi kết quả ban đầu được biết, chính xác là tình huống có xu hướng làm đẹp một phát hiện, và là một lý do nữa để tiêu đề vẫn giữ ở con số đã đăng ký trước.
Mỗi thay đổi chỉ được thử một lần, ở một hình thức. Cách diễn đạt khác cho hướng dẫn có thể đã hiệu quả hơn, và kết quả chế độ lập luận mô tả điều có sẵn trong một khu vực vào tháng 9 năm 2026. Không có kết quả nào trong số này nói rằng điểm số không thể cải thiện; chúng nói rằng bốn con đường này không cải thiện nó.
Câu hỏi thường gặp
Tại sao không báo cáo 62,0% làm độ chính xác?
Vì các quy tắc cho bài kiểm tra đã được cố định trước khi bất kỳ dữ liệu nào tồn tại, và chúng coi các trường hợp hòa là thất bại. Thay đổi một quy tắc sau khi xem kết quả chính là điều mà việc đăng ký trước tồn tại để ngăn chặn, ngay cả khi thay đổi đó hợp lý. Con số 62,0% được công bố như một phép đo theo dõi được ghi nhãn rõ ràng, bên cạnh con số 59,5% mà nó không thay thế.
Một mô hình AI thông minh hơn có làm cho điểm số chính xác hơn không?
Có thể, nhưng đó sẽ là một thí nghiệm mới. Cài đặt lập luận của mô hình hiện tại của chúng tôi không giúp ích trong khu vực chúng tôi sử dụng, và một mô hình khác sẽ cần được kiểm tra trên cùng các cặp, theo cùng cách, trước khi bất kỳ tuyên bố nào có thể được đưa ra. Mới hơn không tự động có nghĩa là tốt hơn ở nhiệm vụ cụ thể này.
Tại sao một bài kiểm tra trên 30 thumbnail lại trông thuyết phục đến vậy?
Mẫu nhỏ tạo ra sự dao động lớn do ngẫu nhiên, và một sự dao động lớn trông như một phát hiện. Với 30 thumbnail, hai yếu tố dường như nhân đôi phạm vi lan rộng nằm trong biến thiên bình thường; ở 322 thumbnail, hiệu ứng gần như biến mất. Đây là cùng cái bẫy như việc đánh giá một phong cách thumbnail mới dựa trên hai lần tải lên.
Điều này có ý nghĩa gì đối với việc kiểm tra thumbnail của tôi?
Các quy tắc tương tự vẫn áp dụng. Quyết định trước khi xem điều gì được coi là thành công, so sánh với phạm vi bình thường của kênh bạn thay vì một video trước đó duy nhất, chạy đủ ví dụ để ngẫu nhiên không thể giải thích kết quả, và nếu bạn yêu cầu bất kỳ công cụ nào so sánh hai lựa chọn, hãy kiểm tra xem câu trả lời của nó có tồn tại khi hoán đổi chúng hay không.
Liệu điểm số vẫn đáng dùng nếu những cải tiến này thất bại?
Điểm số đã được kiểm tra trên kết quả thực tế và vượt trội hơn so với ngẫu nhiên một cách rõ ràng. Những bài theo dõi này cho thấy bốn thay đổi hấp dẫn không đẩy nó xa hơn, điều này hữu ích để biết thay vì là lý do để loại bỏ nó. Hãy coi nó như một đầu vào có thông tin trong số nhiều đầu vào, không phải là dự đoán về lượt xem.