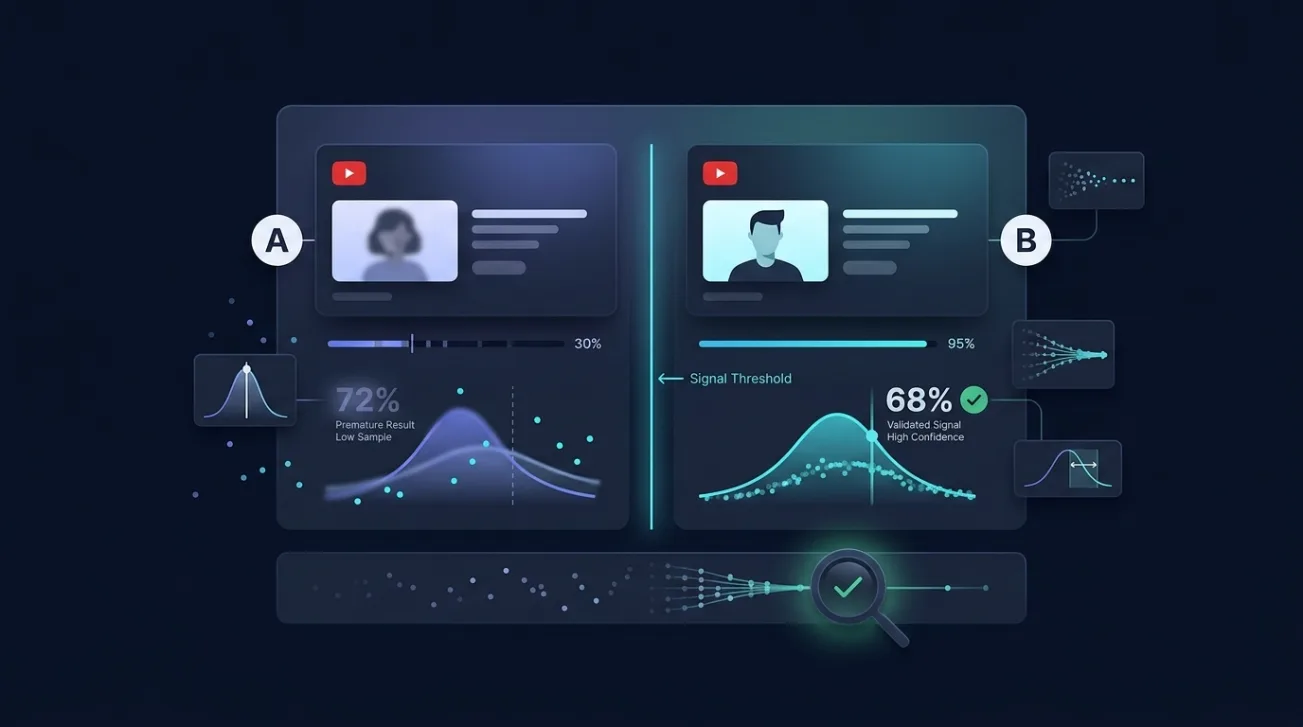
Вы меняете миниатюру, следующее видео набирает больше просмотров и делаете вывод, что новый стиль работает. Этот вывод обычно неверен — не потому что миниатюра не повлияла, а потому что сравнение не могло выявить, повлияла ли она. Вот как отличить реальный результат оформления от случайности, используя те же правила, что мы применили при тестировании нашей собственной модели оценки на 321 паре видео.
Ключевые выводы
- Сравнение видео со средним показателем по всему каналу измеряет рост канала, а не качество оформления.
- Сравнивайте вместо этого с медианой десяти загрузок до и после, исключая само видео.
- Двух видео никогда не достаточно. Небольшие различия между отдельными видео неотличимы от обычных недельных колебаний.
- Определите, что считается победой до просмотра данных, иначе вы всегда найдёте «победу» где-то в данных.
- Тест, который не может дать отрицательный результат, не является тестом. Запишите, какой результат заставит вас отказаться от идеи.
Почему большинство результатов тестов миниатюр не реальны
Типичный тест создателя сравнивает одно видео с предыдущим. Это сравнение включает всё, что изменилось между двумя загрузками: тему, день недели, продолжительность, случайно ли алгоритм продвинул видео, и оформление. Приписывание всей разницы миниатюре предполагает, что другие переменные остались неизменными — а они никогда не остаются.
В результате почти любое изменение выглядит как работающее, потому что количество просмотров само по себе сильно колеблется. Разброс между последовательными загрузками на здоровом канале обычно затмевает эффект от дизайнерского решения.
Это не повод прекращать тестирование. Это повод построить сравнение так, чтобы шум учитывался, а не принимался за сигнал.
С чем следует сравнивать видео
Сравнивайте каждое видео с его ближайшими соседями, а не с историей канала. Возьмите десять загрузок до него и десять после, найдите медианное количество просмотров этих двадцати, и выразите просмотры самого видео как кратное этой медианы. Видео с показателем 1.0 показало результат, как у его окружения. При 2.5 — в два с половиной раза лучше.
Два нюанса важны и оба легко ошибиться. Используйте медиану, а не среднее, потому что одно вирусное видео в окне иначе переопределит базовый уровень для его двадцати соседей. И исключите само видео из собственного базового уровня, иначе каждое видео будет смещено к 1.0, а экстремальные значения, которые вас интересуют, будут сглажены.
| Метод сравнения | Что он учитывает | Где он не работает |
|---|---|---|
| С предыдущим видео | Почти ничего | Один шумный показатель против другого |
| Со средним по всему каналу | Ничего о времени | Растущий канал делает каждое недавнее видео похожим на хит |
| С последними 30 днями | Примерно размер канала | Сезонность и одно вирусное видео, искажающее среднее |
| С скользящей медианой соседей | Размер канала, рост, эпоха | Всё ещё не может отделить тему от оформления |
Почему окно соседей работает
Канал, который вырос в три раза за восемнадцать месяцев, покажет, что каждое недавнее видео превосходит средний показатель за всю историю, а каждое старое — отстаёт. При таком ранжировании вывод об оформлении на самом деле является заявлением о времени публикации каждого видео.
Скользящее окно устраняет это, потому что соседи видео были опубликованы в примерно одинаковом канале, с одинаковым размером аудитории и одинаковыми алгоритмическими условиями. То, что остаётся, более правдоподобно связано с самим видео.
Какой разрыв считать реальным
Полезный порог — фактор в два раза. Когда мы отбирали пары для собственного исследования, мы требовали, чтобы видео с лучшим результатом имело как минимум вдвое большее кратное просмотров, чем худшее. Всё более узкое — это требовать от теста различать два видео, которые канал мог бы легко разделить сам по себе из-за шума.
Соотношения ниже примерно 1.3 следует считать отсутствием результата. Это не строгий универсальный порог — он зависит от того, насколько изменчив ваш канал — но он гораздо ближе к истине, чем считать 10%-ное различие доказательством.
Вторая половина вопроса — сколько сравнений вам нужно. Одна пара практически ничего не говорит. Неприятная арифметика в том, что надёжное обнаружение скромного эффекта оформления требует сотен сравнений, поэтому отдельные создатели испытывают трудности с доказательством чего-либо о своём канале, и честный подход — рассматривать одиночные результаты как слабые доказательства, а не как доказательства.
Чек-лист для тестирования оформления на вашем канале
Эти пять шагов превращают впечатление в нечто ближе к измерению. Никакие из них не требуют инструментов, кроме электронной таблицы.
- Запишите заранее, до начала, какой результат убедит вас, что изменение не сработало. Тест без возможности провала — не тест.
- Вычислите кратное просмотров каждого видео относительно медианы его соседних загрузок, а не относительно любого показателя за всю историю.
- Соберите как минимум десять видео в каждом условии, прежде чем делать выводы, и сопротивляйтесь искушению смотреть промежуточные итоги.
- Исключите Shorts, стримы, коллаборации и всё, что моложе шести недель, поскольку все четыре имеют драйверы производительности, не связанные с оформлением.
- Проверьте, не подходит ли более простое объяснение — тема, которую вы никогда не освещали, видео, которое поделились где-то, сезонный всплеск.
Третий шаг — тот, который люди пропускают, и остановка теста в момент, когда он выглядит благоприятно, — самый эффективный способ убедить себя в ложном.
Если вы хотите оценить оформление до публикации видео, а не через недели, вы можете оценить миниатюру и заголовок по двенадцати факторам оформления и сравнить два варианта рядом — прогноз, который затем можно проверить по результату, когда видео созреет.
Ошибки, делающие тест ложным, когда он не таков
Четыре режима сбоя объясняют большинство ложных выводов, и у каждого есть простое исправление.
Остановка, когда ответ выглядит хорошо
Проверка результатов по мере их накопления и остановка при первом благоприятном моменте даст положительный результат от чистого шума при достаточном терпении. Заранее зафиксируйте размер выборки и проанализируйте один раз. В нашем собственном исследовании мы намеренно полностью убрали решение об остановке: выборка была той, что дали предустановленные правила, что составило 321 пару против целевых 400.
Мы сообщили об этом недостатке как о недостаточной мощности, а не тихо расширяя сбор, потому что правило остановки, которое кто угодно может применить, наблюдая за результатом, — это как нулевой результат становится находкой.
Перерезание, пока что-то не сработает
Если общий результат плоский, соблазнительно проверить, сработало ли это для длинных видео, или для одной категории, или для видео, опубликованных по вторникам. Протестируйте достаточно подгрупп, и одна будет выглядеть значимой просто по случайности. Решите, какие сравнения важны, прежде чем смотреть, и помечайте всё остальное как исследовательское при отчёте.
Как мы применили эти правила к 321 паре видео
Наше собственное исследование точно следовало этой структуре. Шестьдесят каналов по шести категориям, до 300 загрузок каждый, 17 250 видео рассмотрено после исключений. Видео оценивались относительно скользящей медианы их соседей, а пары формировались только внутри одного канала, опубликованных в медиане через шесть дней, с превосходящим видео, превосходящим отстающее в медиане в 4,7 раза.
Каждое правило — исключения, ограничения пар, основной тест, четыре контроля и формулировка для публикации, если результат окажется нулевым — было записано и временно отмечено до оценки любого видео. Оценка выбрала видео с лучшим результатом в 59,5% пар против базового уровня 50%.
Часть, достойная копирования, — не размер выборки. Это то, что анализ не оставлял никаких решений к моменту поступления данных.
Часто задаваемые вопросы
Сколько видео нужно для тестирования стиля миниатюры?
Больше, чем большинство каналов могут быстро произвести. Надёжное обнаружение скромного эффекта оформления требует сотен сравнений, поэтому результаты одного видео — слабые доказательства. С десятью видео на условие вы можете заметить крупный эффект; вы не можете заметить тонкий, и считать небольшую разницу доказательством при таком размере выборки — самая распространённая ошибка тестирования.
С чем следует сравнивать просмотры видео?
С медианным количеством просмотров десяти загрузок до него и десяти после, исключая само видео. Это примерно удерживает размер канала, рост и эпоху постоянными, так что оставшееся с большей вероятностью связано с видео. Сравнение со средним за всю историю измеряет, насколько вырос ваш канал.
Почему использовать медиану вместо среднего?
Потому что одно необычно успешное видео внутри окна подтянет средний базовый уровень вверх и заставит все двадцать соседей выглядеть как аутсайдеры. Медиана почти не затрагивается одним выбросом, поэтому базовый уровень продолжает описывать типичное видео за тот период, а не исключительное.
Как долго ждать перед оценкой производительности видео?
Как минимум шесть недель. Просмотры накапливаются неравномерно, и рейтинг видео относительно его соседей может существенно измениться в первый месяц. В нашем исследовании мы исключили всё, опубликованное в течение 45 дней до даты измерения, по этой же причине, а также всё, старше двух лет.
Можно ли доверять тесту миниатюры, который сравнивает только два видео?
Рассматривайте это как подсказку, а не как результат. Два видео различаются по теме, времени, продолжительности и десяткам других способов, поэтому приписывание всей разницы оформлению предполагает, что всё остальное осталось неизменным. Это стоит заметить и стоит повторить, но это не основа для изменения общеканального подхода.
Что такое кратное просмотров и как его рассчитать?
Разделите количество просмотров видео на медиану просмотров его соседних загрузок, исключая само видео. Результат 1,0 означает, что оно показало результат, как у его окружения, 2,0 — в два раза лучше, 0,5 — в два раза хуже. Это преобразует сырые показатели просмотров, которые сильно зависят от времени публикации видео, в цифру, которую можно сравнивать по всей истории вашего канала.