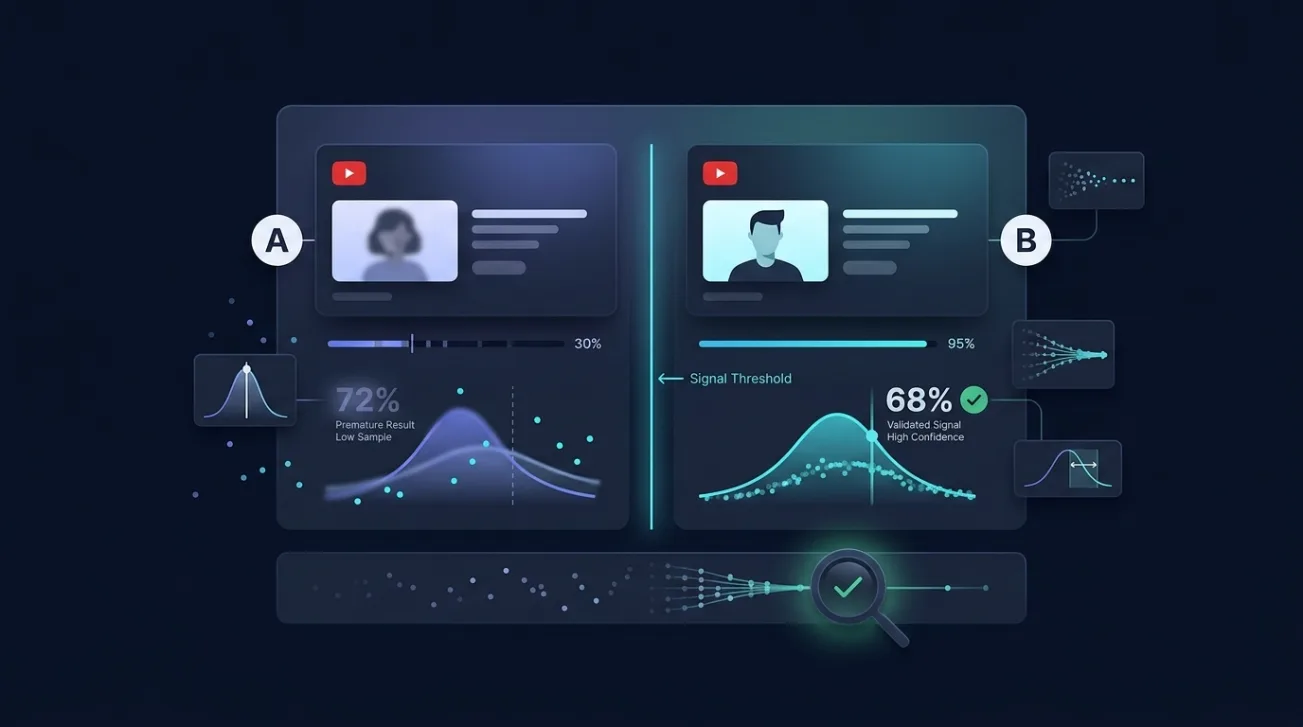
Vous changez une miniature, la vidéo suivante performe mieux, et vous en concluez que le nouveau style fonctionne. Cette conclusion est généralement fausse — non parce que la miniature n’a rien fait, mais parce que la comparaison n’aurait pas pu détecter si elle avait eu un effet. Voici comment distinguer un résultat réel de packaging d’une coïncidence, en utilisant les mêmes règles que celles que nous avons appliquées lors du test de notre propre modèle de notation sur 321 paires de vidéos.
Points clés
- Comparer une vidéo à la moyenne historique de votre chaîne mesure la croissance de votre chaîne, pas la qualité du packaging.
- Comparez-la plutôt à la médiane des dix publications avant et après, en excluant la vidéo elle-même.
- Deux vidéos ne suffisent jamais. De petites différences entre vidéos uniques sont indiscernables des variations hebdomadaires ordinaires.
- Définissez ce qui compte comme une victoire avant d’examiner les données, sinon vous en trouverez toujours une quelque part.
- Un test qui ne peut pas donner de résultat négatif n’est pas un test. Notez ce résultat qui vous ferait abandonner l’idée.
Pourquoi la plupart des résultats de test de miniature ne sont pas réels
Le test typique d’un créateur compare une vidéo à celle qui la précède. Cette comparaison inclut tout ce qui a changé entre les deux publications : le sujet, le jour de la semaine, la durée, si l’algorithme l’a poussée, et le packaging. Attribuer toute la différence à la miniature suppose que les autres variables sont restées constantes — ce qui n’arrive jamais.
Le résultat est que presque tout changement semble fonctionner, car les vues varient beaucoup d’elles-mêmes. La variance entre publications consécutives sur une chaîne saine dépasse régulièrement l’effet d’une décision de conception.
Ce n’est pas une raison d’arrêter de tester. C’est une raison de construire la comparaison de manière à ce que le bruit soit pris en compte, plutôt que confondu avec le signal.
Ce contre quoi vous devriez comparer une vidéo
Comparez chaque vidéo à ses voisines immédiates, pas à l’historique de votre chaîne. Prenez les dix publications avant et les dix après, trouvez la médiane du nombre de vues de ces vingt vidéos, et exprimez les vues de la vidéo comme un multiple de cette médiane. Une vidéo à 1,0 a performé exactement comme son voisinage. À 2,5, elle a fait deux fois et demie mieux.
Deux détails importent et sont faciles à mal faire. Utilisez la médiane plutôt que la moyenne, car une seule vidéo virale dans la fenêtre redéfinirait la base pour ses vingt voisines. Et excluez la vidéo elle-même de sa propre base, sinon chaque vidéo est tirée vers 1,0 et les extrêmes qui vous intéressent sont aplatis.
| Méthode de comparaison | Ce qu’elle contrôle | Où elle échoue |
|---|---|---|
| Contre la vidéo précédente | Presque rien | Un point de données bruyant contre un autre |
| Contre votre moyenne historique | Rien concernant le timing | Une chaîne en croissance fait paraître chaque vidéo récente comme un succès |
| Contre les 30 derniers jours | Taille de la chaîne, approximativement | Saisonnalité, et une vidéo virale qui fausse la moyenne |
| Contre la médiane mobile des voisines | Taille, croissance, époque de la chaîne | Ne peut toujours pas séparer sujet et packaging |
Pourquoi la fenêtre de voisinage fonctionne
Une chaîne qui a triplé de taille en dix-huit mois montrera chaque publication récente dépassant sa moyenne historique et chaque ancienne en dessous. Classées ainsi, la conclusion sur le packaging que vous tirez est en réalité une déclaration sur la date de publication de chaque vidéo.
La fenêtre mobile supprime cela, car les voisines d’une vidéo ont été publiées dans une chaîne, une audience et des conditions algorithmiques similaires. Ce qui reste est plus plausible comme étant lié à la vidéo elle-même.
Quelle différence compte comme une différence réelle
Un seuil utile est un facteur de deux. Lorsque nous avons sélectionné des paires pour notre propre étude, nous avons exigé que la vidéo performante ait au moins deux fois le multiple de vues de la moins performante. Tout ce qui est plus étroit demande au test de distinguer entre deux vidéos que le bruit propre à la chaîne aurait pu facilement séparer.
Les ratios inférieurs à environ 1,3 doivent être considérés comme aucun résultat. Ce n’est pas un seuil universel rigoureux — cela dépend de la variabilité de votre chaîne — mais c’est bien plus proche de la vérité que de traiter une différence de 10 % comme une preuve.
L’autre moitié de la question est le nombre de comparaisons nécessaires. Une paire ne vous dit essentiellement rien. L’arithmétique inconfortable est que détecter un effet modeste de packaging de manière fiable nécessite des centaines de comparaisons, ce qui explique pourquoi les créateurs individuels peinent à prouver quoi que ce soit sur leur propre chaîne, et pourquoi la démarche honnête est de considérer les résultats uniques comme une faible preuve, pas une preuve.
Une liste de vérification pour tester le packaging sur votre propre chaîne
Ces cinq étapes transforment une impression en quelque chose de plus proche d’une mesure. Aucune ne nécessite d’outils au-delà d’un tableur.
- Écrivez, avant de commencer, quel résultat vous convaincrait que le changement n’a pas fonctionné. Un test sans issue négative n’est pas un test.
- Calculez le multiple de vues de chaque vidéo par rapport à la médiane de ses publications voisines, plutôt qu’à toute figure historique.
- Collectez au moins dix vidéos par condition avant de tirer une conclusion, et résistez à l’envie de regarder le total en cours.
- Excluez les Shorts, les lives, les collaborations et tout contenu âgé de moins de six semaines, car les quatre ont des facteurs de performance indépendants du packaging.
- Vérifiez s’il existe une explication plus simple — un sujet jamais abordé, une publication partagée quelque part, un pic saisonnier.
L’étape trois est celle que les gens sautent, et arrêter un test dès qu’il semble favorable est le moyen le plus efficace de vous convaincre de quelque chose de faux.
Si vous souhaitez évaluer le packaging avant la publication d’une vidéo plutôt que des semaines après, vous pouvez noter une miniature et un titre selon douze facteurs de packaging et comparer deux options côte à côte — une prédiction que vous pourrez ensuite vérifier contre le résultat une fois la vidéo mature.
Erreurs qui font paraître un test concluant alors qu’il ne l’est pas
Quatre modes d’échec expliquent la plupart des conclusions fausses, et chacun a une solution simple.
Arrêter dès que la réponse semble bonne
Vérifier les résultats au fur et à mesure et arrêter au premier moment favorable produira un résultat positif à partir du bruit pur, avec assez de patience. Fixez la taille de l’échantillon à l’avance et analysez une fois. Dans notre propre étude, nous avons délibérément supprimé toute décision d’arrêt : l’échantillon était ce que les règles prédéfinies produisaient, soit 321 paires contre un objectif de 400.
Nous avons rapporté ce déficit comme sous-puissant plutôt que d’étendre discrètement la collecte, car une règle d’arrêt que n’importe qui peut appliquer en observant le résultat est la manière dont un résultat nul devient une découverte.
Re-découper jusqu’à ce que quelque chose fonctionne
Si le résultat global est plat, il est tentant de vérifier si cela a fonctionné pour les vidéos longues, ou pour une catégorie, ou pour les vidéos publiées un mardi. Testez suffisamment de sous-groupes et l’un d’eux semblera significatif par hasard. Décidez quelles comparaisons comptent avant de regarder, et étiquetez tout le reste comme exploratoire lorsque vous le rapportez.
Comment nous avons appliqué ces règles à 321 paires de vidéos
Notre propre étude a suivi exactement cette structure. Soixante chaînes dans six catégories, jusqu’à 300 publications chacune, 17 250 vidéos considérées après exclusions. Les vidéos ont été notées selon la médiane mobile de leurs voisines, et les paires ont été formées uniquement au sein d’une même chaîne, publiées avec une médiane de six jours d’écart, la performante dépassant la moins performante par un facteur médian de 4,7.
Chaque règle — les exclusions, les contraintes de jumelage, le test principal, les quatre contrôles et la formulation à publier si le résultat était nul — a été écrite et horodatée avant que toute vidéo ne soit notée. La note a choisi la vidéo performante dans 59,5 % des paires contre une base de 50 %.
La partie à copier n’est pas la taille de l’échantillon. C’est que l’analyse n’avait plus aucune décision à prendre une fois les données arrivées.
Questions fréquentes
Combien de vidéos ai-je besoin pour tester un style de miniature ?
Plus que la plupart des chaînes peuvent en produire rapidement. Détecter un effet modeste de packaging de manière fiable nécessite des centaines de comparaisons, ce qui explique pourquoi les résultats sur une seule vidéo sont une faible preuve. Avec dix vidéos par condition, vous pouvez repérer un effet important ; vous ne pouvez pas repérer un effet subtil, et traiter une petite différence comme une preuve à cette taille d’échantillon est l’erreur de test la plus courante.
Contre quoi devrais-je comparer les vues d’une vidéo ?
La médiane du nombre de vues des dix publications avant et des dix après, en excluant la vidéo elle-même. Cela maintient la taille, la croissance et l’époque de votre chaîne à peu près constantes, donc ce qui reste est plus susceptible d’être lié à la vidéo. Comparer à une moyenne historique mesure plutôt la croissance de votre chaîne.
Pourquoi utiliser la médiane plutôt que la moyenne ?
Parce qu’une publication exceptionnellement réussie dans la fenêtre tirerait une base moyenne vers le haut et ferait paraître ses vingt voisines comme des sous-performantes. La médiane est à peine affectée par un seul outlier, donc la base continue de décrire une vidéo typique de cette période plutôt qu’une exceptionnelle.
Combien de temps dois-je attendre avant d’évaluer la performance d’une vidéo ?
Au moins six semaines. Les vues s’accumulent de manière inégale, et le classement d’une vidéo par rapport à ses voisines peut changer considérablement durant le premier mois. Dans notre étude, nous avons exclu tout contenu publié dans les 45 jours précédant la date de mesure pour cette raison exacte, ainsi que tout contenu âgé de plus de deux ans.
Puis-je faire confiance à un test de miniature qui ne compare que deux vidéos ?
Considérez-le comme un indice plutôt qu’un résultat. Deux vidéos diffèrent par le sujet, le timing, la durée et des dizaines d’autres façons, donc attribuer tout l’écart au packaging suppose que tout le reste est resté constant. Cela vaut la peine d’être noté et répété, mais ce n’est pas la base pour changer une approche à l’échelle de la chaîne.
Qu’est-ce qu’un multiple de vues et comment le calculer ?
Divisez le nombre de vues d’une vidéo par la médiane des vues de ses publications voisines, en excluant elle-même. Un résultat de 1,0 signifie qu’elle a performé comme son voisinage, 2,0 signifie deux fois mieux, 0,5 signifie la moitié. Cela convertit les nombres bruts de vues, fortement dépendants de la date de publication, en un chiffre comparable à travers l’historique de votre chaîne.