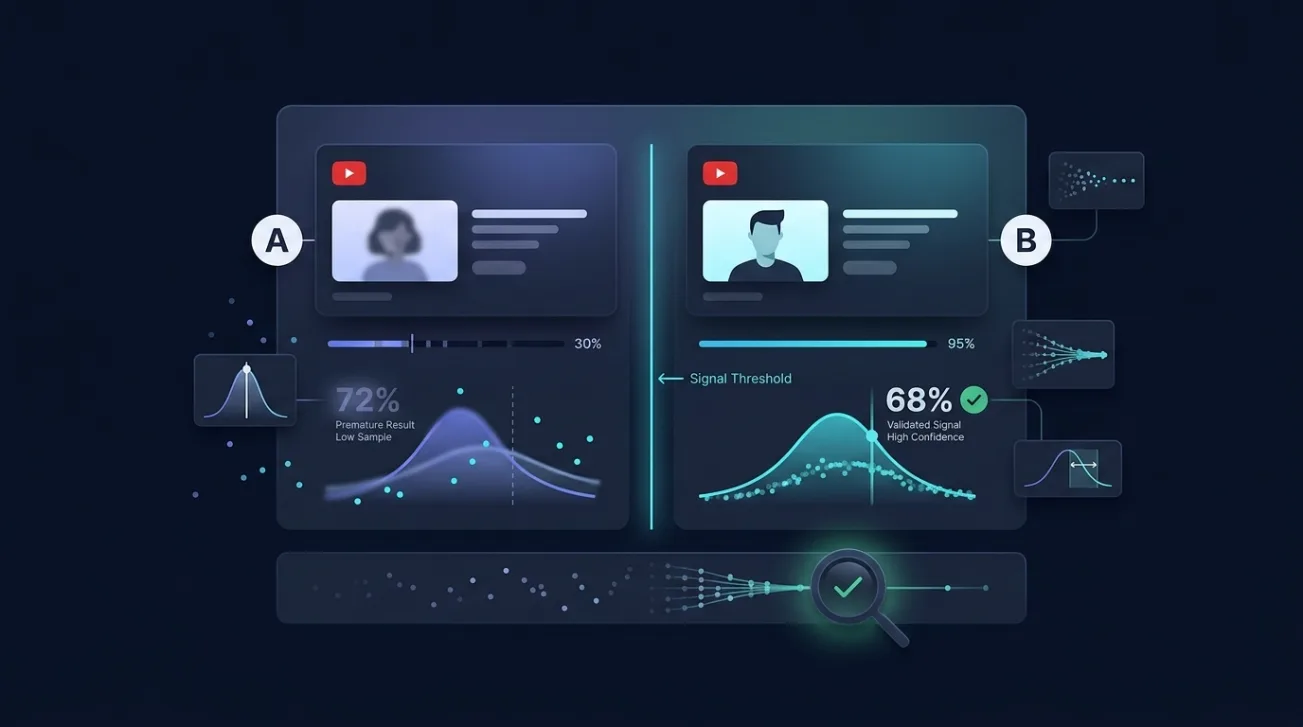
Você muda uma thumbnail, o próximo vídeo performa melhor e conclui que o novo estilo funciona. Essa conclusão geralmente está errada — não porque a thumbnail não fez nada, mas porque a comparação não poderia ter detectado se ela fez. Aqui está como diferenciar um resultado real de embalagem de uma coincidência, usando as mesmas regras que aplicamos ao testar nosso próprio modelo de pontuação contra 321 pares de vídeos.
Principais conclusões
- Comparar um vídeo com a média histórica do seu canal mede o quanto seu canal cresceu, não quão boa foi a embalagem.
- Compare em vez disso com a mediana dos dez uploads antes e depois dele, excluindo o próprio vídeo.
- Dois vídeos nunca são suficientes. Pequenas diferenças entre vídeos únicos são indistinguíveis da variação semanal normal.
- Decida o que conta como vitória antes de olhar, ou você sempre encontrará algo nos dados.
- Um teste que não pode dar resultado negativo não é um teste. Anote qual resultado o faria abandonar a ideia.
Por que a maioria dos resultados de teste de thumbnail não é real
O teste típico de criador compara um vídeo com o anterior. Essa comparação contém tudo que mudou entre os dois uploads: o tema, o dia da semana, a duração, se o algoritmo o impulsionou e a embalagem. Atribuir toda a diferença à thumbnail assume que as outras variáveis permaneceram estáveis — e elas nunca ficam.
O resultado é que quase qualquer mudança parece ter funcionado, porque as visualizações variam muito por si só. A variação entre uploads consecutivos em um canal saudável geralmente supera o efeito de uma decisão de design.
Isso não é motivo para parar de testar. É motivo para construir a comparação de forma que o ruído seja considerado, em vez de ser confundido com o sinal.
O que você deve comparar com um vídeo
Compare cada vídeo com seus vizinhos imediatos, não com o histórico do seu canal. Pegue os dez uploads anteriores e os dez posteriores, encontre a mediana das visualizações desses vinte e expresse as visualizações do próprio vídeo como múltiplo dessa mediana. Um vídeo em 1.0 performou exatamente como seu entorno. Em 2.5, performou duas vezes e meia melhor.
Dois detalhes importam e ambos são fáceis de errar. Use a mediana em vez da média, porque um único upload viral na janela redefiniria a linha de base para seus vinte vizinhos. E exclua o próprio vídeo de sua própria linha de base, ou todos os vídeos serão puxados para 1.0 e os extremos que você quer ver serão achatados.
| Método de comparação | O que controla | Onde falha |
|---|---|---|
| Contra o vídeo anterior | Quase nada | Um ponto de dados ruidoso contra outro |
| Contra sua média histórica | Nada sobre o momento | Um canal em crescimento faz todo vídeo recente parecer um sucesso |
| Contra os últimos 30 dias | Tamanho do canal, aproximadamente | Sazonalidade e um único vídeo viral distorcendo a média |
| Contra a mediana móvel dos vizinhos | Tamanho do canal, crescimento, era | Ainda não consegue separar tema de embalagem |
Por que a janela de vizinhança funciona
Um canal que triplicou de tamanho em dezoito meses mostrará todos os uploads recentes superando sua média histórica e todos os antigos ficando aquém. Classificados assim, a conclusão sobre embalagem que você chega é na verdade uma afirmação sobre quando cada vídeo foi publicado.
A janela móvel remove isso, porque os vizinhos de um vídeo foram publicados em um canal aproximadamente igual, com o mesmo tamanho de audiência e as mesmas condições algorítmicas. O que sobra é mais plausivelmente sobre o próprio vídeo.
Quão grande uma diferença conta como diferença real
Um limite útil é um fator de dois. Quando selecionamos pares para nosso próprio estudo, exigimos que o vídeo com melhor desempenho tivesse pelo menos o dobro do múltiplo de visualizações do pior. Qualquer coisa mais estreita está pedindo ao teste que distinga entre dois vídeos que o ruído do próprio canal poderia facilmente separar sozinho.
Razões abaixo de cerca de 1.3 devem ser tratadas como nenhum resultado. Isso não é um limite universal rigoroso — depende de quão variável é o seu canal — mas está muito mais próximo do correto do que tratar uma diferença de 10% como evidência.
A outra metade da pergunta é quantas comparações você precisa. Um par diz essencialmente nada. A aritmética desconfortável é que detectar um efeito modesto de embalagem de forma confiável exige centenas de comparações, o que explica por que criadores individuais lutam para provar algo sobre seu próprio canal e por que a atitude honesta é tratar resultados únicos como evidência fraca, não como prova.
Checklist para testar embalagem no seu próprio canal
Esses cinco passos transformam uma impressão em algo mais próximo de uma medição. Nenhum deles requer ferramentas além de uma planilha.
- Anote, antes de começar, qual resultado o convenceria de que a mudança não funcionou. Um teste sem resultado negativo não é um teste.
- Calcule o múltiplo de visualizações de cada vídeo contra a mediana de seus uploads vizinhos, em vez de qualquer número histórico.
- Reúna pelo menos dez vídeos em cada condição antes de tirar qualquer conclusão, e resista a olhar o total acumulado no meio.
- Exclua Shorts, transmissões ao vivo, colaborações e qualquer coisa com menos de seis semanas, pois todos os quatro têm fatores de desempenho não relacionados à embalagem.
- Verifique se uma explicação mais simples se encaixa — um tema que você nunca abordou, um upload que foi compartilhado em algum lugar, um pico sazonal.
O passo três é o que as pessoas pulam, e parar um teste assim que ele parece favorável é a maneira mais eficaz de convencer a si mesmo de algo falso.
Se você quiser uma avaliação da embalagem antes do vídeo ser publicado, em vez de semanas depois, pode avaliar uma thumbnail e título contra doze fatores de embalagem e comparar duas opções lado a lado — uma previsão que você pode então verificar contra o resultado assim que o vídeo amadurecer.
Erros que fazem um teste parecer conclusivo quando não é
Quatro modos de falha explicam a maioria das conclusões falsas, e cada um tem uma correção simples.
Parar quando a resposta parece boa
Verificar resultados à medida que se acumulam e parar no primeiro momento favorável produzirá um resultado positivo apenas pelo ruído, dada paciência suficiente. Fixe o tamanho da amostra antecipadamente e analise uma vez. Em nosso próprio estudo, removemos deliberadamente a decisão de parada: a amostra foi o que as regras pré-definidas produziram, que resultou em 321 pares contra uma meta de 400.
Relatamos essa deficiência como subdimensionada em vez de estender silenciosamente a coleta, porque uma regra de parada que qualquer um pode aplicar enquanto observa o resultado é como um resultado nulo se torna uma descoberta.
Re-dividir até algo funcionar
Se o resultado geral for plano, é tentador verificar se funcionou para vídeos longos, ou para uma categoria, ou para vídeos publicados às terças. Teste o suficiente de subgrupos e um parecerá significativo apenas por acaso. Decida quais comparações importam antes de olhar, e rotule tudo o mais como exploratório ao relatar.
Como aplicamos essas regras a 321 pares de vídeos
Nosso próprio estudo seguiu exatamente essa estrutura. Sessenta canais em seis categorias, até 300 uploads cada, 17.250 vídeos considerados após exclusões. Os vídeos foram pontuados contra a mediana móvel de seus vizinhos, e pares foram formados apenas dentro de um único canal, publicados com mediana de seis dias de diferença, com o vencedor superando o perdedor por um fator mediano de 4,7.
Cada regra — as exclusões, as restrições de pareamento, o teste principal, os quatro controles e a redação para publicar se o resultado fosse nulo — foi escrita e carimbada antes de qualquer vídeo ser pontuado. A pontuação escolheu o vídeo com melhor desempenho em 59,5% dos pares contra uma linha de base de 50%.
A parte que vale a pena copiar não é o tamanho da amostra. É que a análise não tinha decisões restantes quando os dados chegaram.
Perguntas frequentes
Quantos vídeos preciso para testar um estilo de thumbnail?
Mais do que a maioria dos canais pode produzir rapidamente. Detectar um efeito modesto de embalagem de forma confiável exige centenas de comparações, o que explica por que resultados de vídeo único são evidência fraca. Com dez vídeos por condição, você pode identificar um efeito grande; não pode identificar um sutil, e tratar uma pequena diferença como prova nesse tamanho de amostra é o erro de teste mais comum.
Contra o que devo comparar as visualizações de um vídeo?
A mediana das visualizações dos dez uploads anteriores e dos dez posteriores, excluindo o próprio vídeo. Isso mantém o tamanho, crescimento e era do seu canal aproximadamente constantes, então o que resta é mais provável que seja sobre o vídeo. Comparar com uma média histórica mede o quanto seu canal cresceu em vez disso.
Por que usar a mediana em vez da média?
Porque um upload incomum e bem-sucedido dentro da janela puxaria a linha de base média para cima e faria todos os seus vinte vizinhos parecerem subdesempenhadores. A mediana é pouco afetada por um único outlier, então a linha de base continua descrevendo um vídeo típico desse período, em vez de um excepcional.
Quanto tempo devo esperar antes de julgar o desempenho de um vídeo?
Pelo menos seis semanas. As visualizações se acumulam de forma desigual, e a classificação de um vídeo contra seus vizinhos pode mudar substancialmente no primeiro mês. Em nosso estudo, excluímos qualquer coisa publicada nos últimos 45 dias da data de medição por exatamente esse motivo, além de qualquer coisa com mais de dois anos.
Posso confiar em um teste de thumbnail que compara apenas dois vídeos?
Trate como uma dica, não como um resultado. Dois vídeos diferem em tema, momento, duração e dezenas de outras formas, então atribuir toda a diferença à embalagem assume que tudo o mais permaneceu estável. Vale a pena notar e repetir, mas não é base para mudar uma abordagem em todo o canal.
O que é um múltiplo de visualizações e como calculo?
Divida a contagem de visualizações de um vídeo pela mediana das visualizações de seus uploads vizinhos, excluindo ele mesmo. Um resultado de 1,0 significa que performou como seu entorno, 2,0 significa duas vezes melhor, 0,5 significa metade. Isso converte contagens brutas de visualizações, que dependem fortemente de quando o vídeo foi publicado, em um número que pode ser comparado ao longo da história do seu canal.