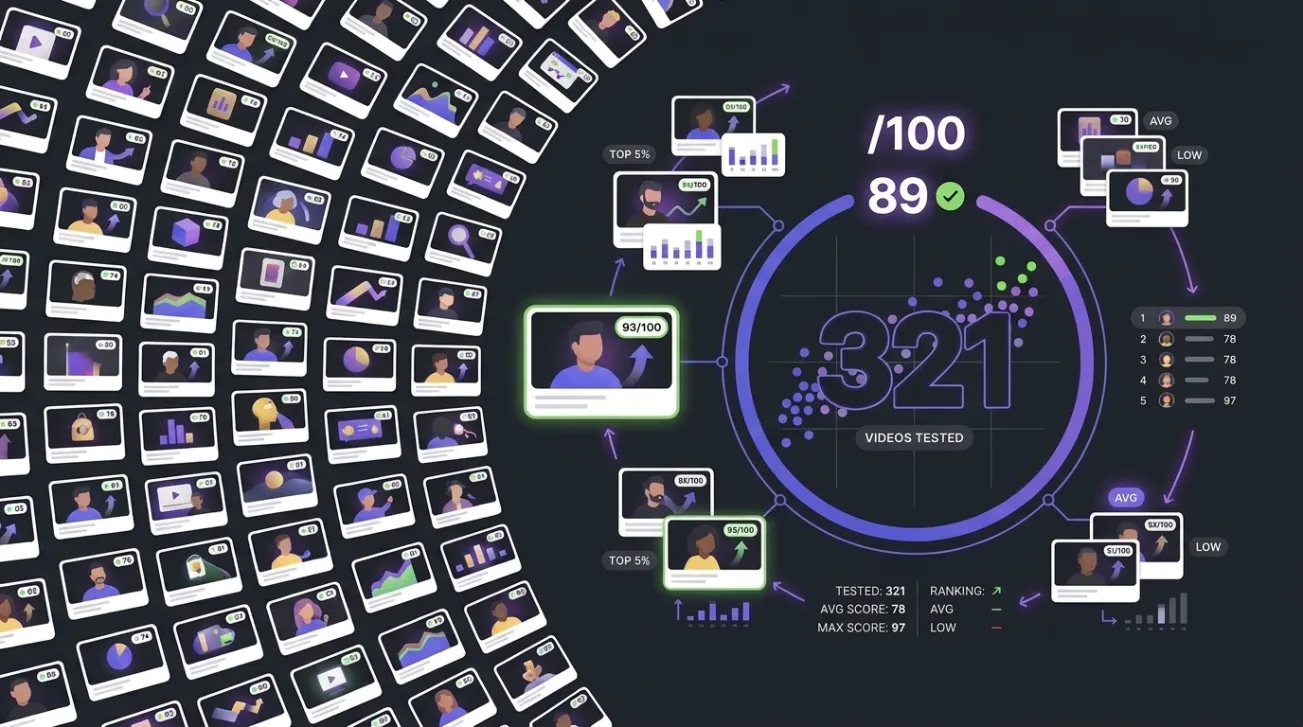
サムネイルスコアの価値は、YouTube上で実際に起こることと一致しているかどうかにかかっています。そこで、私たちが恥をかく可能性のあるテストを実施しました:321組の実際の動画ペア(各ペアは同一チャンネルから、片方はそのチャンネルの平均を上回り、もう片方は下回る)、事前に方法を記録してから分析を開始しました。スコアは59.5%の確率で、よりパフォーマンスの高い動画を正しく選択しました(コインフリップの50%と比較)。
主要なポイント
- 321組のペア全体で、スコアは59.5%の確率でよりパフォーマンスの高い動画を上位にランク付けしました(p = 0.00079)。偶然の確率は50%です。
- 異なるチャンネル間で動画を比較すると、視聴者数を測定することになり、パッケージングの評価にはなりません。本テストではすべてのペアが同一チャンネルから、中央値で6日間隔で公開されています。
- すべてのサムネイルが同じテンプレートに従うチャンネルでは、精度は48.7%に低下しました。これは私たちが望んでいた結果です:読み取れる差がなく、信号も見つからない状態です。
- タイトルの長さ、単語数、ファイルサイズ、コントラストといった4つの単純なヒューリスティックはすべて偶然の確率にとどまりました。スコアはこれらいずれの代理指標でもありません。
- モデルが2つの動画の間に置いた差が大きいほど、正解率は高くなりました:1〜3ポイント差で56%、15ポイント以上で76.5%。
YouTubeサムネイルスコアは実際にパフォーマンスを予測できるのか?
本テストでは、はい — ただし控えめで測定可能な範囲でです。同一チャンネルの2本の動画(片方は明確に自らのベースラインを上回り、もう片方は下回る)に対して、スコアは59.5%の確率で正しく順位付けしました。偶然の確率は50%です。95%信頼区間は53.9%から64.9%の範囲であり、効果は実在しますが小さいです。
「小さい」が正直な答えであり、それ以上を主張する人は何かを売っているのです。パッケージングは多くの要因の1つにすぎません。トピック、投稿タイミング、その週のアルゴリズムの気分、プラットフォーム外での拡散など、すべてがサムネイルよりも視聴数に影響を与えます。90%の精度を主張するスコアは、存在しないYouTubeを描いているのです。
59.5%が実際には何を意味するか:同じ動画の2つの選択肢の間で選ぶ場合、スコアは単なる推測より優れており、片方を強く好むほどより有用です。
異なるチャンネル間でサムネイルを比較しても意味がない理由
このテストの最も単純なバージョンは、一連のサムネイルにスコアを付け、視聴数と相関させる方法です。しかし、これはチャンネル規模を測定しているにすぎません。視聴数は、登録者数、トピック、動画の年齢によってパッケージングよりもはるかに大きく左右され、大きなチャンネルは優れたデザイナーを雇えるだけでなく、大規模な視聴者層も持っています — つまり、相関関係は誤解を招く方向に働きます。
このテストを実行すると、意味のない良好な正の相関が得られます。1人の懐疑的な読者でさえ、その結果を疑うでしょう。
公平な比較に必要な一定条件
同一チャンネルの2本の動画を比較することで、登録者数、視聴者層、予算、デザイン能力の4つを同時に排除できます。なぜなら、これらはペア内で同一だからです。さらに、2本の動画が近い期間に公開されていることを条件とすることで、チャンネルの成長傾向やその期間のアルゴリズムの状態も排除できます。
残るのは、帰無仮説の下で答えがわかっている問いです:チャンネルの視聴者が明らかに異なる反応を示した2本の動画に対して、スコアはどちらがどちらかを判別できるか?
321組のマッチングペアで公平なテストを構築した方法
6つのカテゴリー(テック、教育、料理、ゲーム、フィットネス、ライフスタイル)に属する60チャンネルから、各チャンネルの直近のアップロード最大300本を抽出しました。除外処理を経て、検討対象の動画は17,250本、使用可能なペアは321組となりました。すべてのペアは同一チャンネルで、中央値で6日間隔で公開され、上位動画は下位動画を中央値で4.7倍上回っています。
パフォーマンスはチャンネル全体の平均ではなく、ローリングローカルベースラインで測定されます。各動画に対して、前後10本ずつの隣接アップロードの視聴数の中央値を基準とし、その倍率として自身の視聴数を表します。2年間で5倍成長したチャンネルの場合、早期の動画はすべて失敗、最近の動画はすべて成功と評価されてしまうため、カレンダーではなくパッケージングを測定するためです。
ペアリングルールは事前に固定されました:
- 両方の動画は同一チャンネルからであり、各動画は最大1つのペアにしか含まれません。
- 公開日は120日以内に限られます。
- 上位動画は下位動画を少なくとも2倍以上上回る必要があります。これにより「良い」「悪い」がノイズではなく明確な意味を持ちます。
- 1チャンネルあたり最大8ペアまでとし、多産なアップローダーがサンプルを支配しないようにします。
ショート動画、ライブストリーム、45日未満または2年以上前の動画は除外されました。スコアはサムネイルとタイトルのみを入力として受け取り(ユーザーがツールに送るのと同じ)、視聴数やペアのどちら側かといった情報は一切見ていません。
スコアが正解した内容とその頻度
モデルは321組中191組でよりパフォーマンスの高い動画を正しく選びました:59.5%、50%の帰無仮説に対する正確な二項分布p値は0.00079です。17組は完全に同点となり、すべて失敗としてカウントされました(分割や除外は結果を美化するため)。スコアが2つの入力を区別できない場合、それは差別化に成功していないと判断します。
同点を失敗としてカウントすることで、ヘッドラインの数字は控えめになります。まったく能力のないモデルはこのルール下で約47.4%の正解率を示すため、実際の偶然の水準よりわずかに高い基準をクリアするよう求められました。実際に区別できた304組では、正解率は62.8%でした。
信頼度が正解率と連動
結果が偶然ではなく測定値として振る舞うパターン:スコアが2つの動画の間に置いた差が大きいほど、正解率は高くなります。
1〜3ポイント差では56.0%、4〜7ポイントで64.1%、8〜14ポイントで63.2%、15ポイント以上で76.5%でした。ノイズを生成するモデルはこれらのカテゴリでフラットな線を示すはずです。本モデルは確信が高まるにつれて正解率が安定して向上しており、これは望ましい挙動であり、偽造できません。
私たちを間違っていると証明できた4つのチェック
失敗の可能性がない研究は証拠になりません。事前に4つのコントロールを指定し、いずれかがヘッドラインを無効化する可能性があるとし、結果が何であれすべてを公開することを約束しました。すべてが期待通りに振る舞いました。
| コントロール | 失敗が意味するもの | 結果 |
|---|---|---|
| 勝者/敗者のラベルを1,000回シャッフル | パイプラインが答えを漏らしている;結果全体が無効 | 47.1% — 理論が示す通りの位置 |
| サムネイルが固定テンプレートに従うチャンネル | スコアがパッケージング以外のものを読み取っている | 48.7% — 予想通りの偶然 |
| 単純なヒューリスティック:タイトル長、単語数、ファイルサイズ、コントラスト | 1行ルールがモデルと一致するため、モデルは追加価値がない | 46.7%〜54.5%、いずれも有意ではない |
| すべてのサムネイルを他の動画のタイトルに対して再スコアリング | タイトルは寄与せず、片方のみをスコアリングしている | 平均で11.3ポイント変動 |
テンプレートチェックが最も重要であり、その理由を明確に説明する価値があります。すべてのサムネイルに同一レイアウトを再利用するチャンネルでは、視覚モデルが比較できる要素はほとんどありません。もし私たちのスコアがここで勝者を確信を持って選んでいたなら、それはパッケージングではなくチャンネルのアイデンティティや投稿時期を読み取っていたことになります。これらのチャンネルでは48.7%、それ以外では61.0%の精度でした。この差こそが、測定しているものが私たちが主張するものであるという最も強い証拠です。
勝者と敗者を分けるスコアリング次元
この部分は確認的ではなく探索的であり、YouTube全体ではなく本サンプルを記述しています。12のサブスコアを2つのグループの差の大きさで順位付けした結果、最も明確な差を示したのは「約束の明確さ」で、次いで「見逃し恐怖」のシグナルと「緊急性」でした。感情の強さはほとんど差を生みませんでした。
「約束の明確さ」 — パッケージングが視聴者に何を視聴するかを明確に伝える度合い — が上位に来るのは、モデルの満足度側が設計された目的と一致しています。最も弱い差別化要因が感情の強さであることは、より興味深い点です:本サンプルでは、サムネイルの強い感情が過剰パフォーマーと低パフォーマーを区別していませんでした。これは多くのサムネイルアドバイスが想定していることとは異なります。
これらの次元を自分のパッケージングで個別に確認したい場合は、本研究と同じスコアリングパイプラインでサムネイルとタイトルを評価できます — これはデモ版ではなく、完全に同一のコードパスです。
本テストが証明していないこと
4つの制限事項で、すべてはデータ存在前に記録されました。
本テストはスコアを検証しており、アドバイスを検証しているわけではありません。提案されたタイトルを実際に適用することで、実際の動画のパフォーマンスが向上するかどうかは、私たちが実施していない別の実験です。これは因果関係ではなく観察的です:サムネイルを変更すると視聴数が変わるという証明ではなく、スコアがすでに存在する差と関連していることを示しています。
サンプルが結果の適用対象を決定
ペアはパフォーマンスが大きく異なることを意図して選ばれたため、59.5%は「明確な過剰パフォーマー対明確な低パフォーマー」の母集団を記述しており、ランダムに選んだ2本の動画を対象としていません。すべてのチャンネルは確立されており、英語圏で、安定したベースラインを持つ十分な規模でした。12本のアップロードしかなく、測定可能な履歴のないチャンネルにはこの結果は一般化できません。
視聴数は1日分のデータで取得され、その後も増加し続けます。全体はスナップショットであり、スナップショットを正直に扱う方法は、後日もう1回撮影することです。
よくある質問
59.5%の精度はサムネイルスコアとして良いですか?
実際の結果に対する単一のパッケージング信号としては、はい。視聴数は主にトピック、視聴者規模、タイミング、アルゴリズムの運に依存するため、サムネイルとタイトルのスコアはその一部しか説明できません。90%に近い数字は、より良いモデルではなく、テスト設計の漏れを示唆します。有用な捉え方は、推測より優れており、自信があるほどより明確に勝つことです。
なぜサムネイルスコアと視聴数を直接比較しないのですか?
それはチャンネル規模を測定するからです。登録者数、トピック、動画の年齢はパッケージングよりも視聴数に大きく影響し、大きなチャンネルは優れたデザイナーと大規模な視聴者層の両方を持つ傾向があるため、相関関係はサムネイルとは無関係な理由で正の値になります。同一チャンネルの2本の動画を比較することで、これらすべてを一挙に排除できます。
同点を失敗としてカウントしたのはなぜですか?
17組のペアが両方の動画に同じスコアを付与されました。分割したり除外したりすると結果を美化するため、すべてをミスとして記録しました。2つの入力を区別できないスコアは、差別化に成功していないと判断します。これにより、報告された59.5%は代替処理の場合より低くなります。
高いサムネイルスコアはより多くの視聴数を意味しますか?
いいえ。本研究は多数のペア間の関連性を示しており、個々の動画に対する約束ではありません。約4割のペアは逆の順位付けでした。パッケージングは複数のレバーの1つにすぎず、誰も見たいと思わない動画のスコアが高くても、それを救うことはできません。
60チャンネルはどのように選ばれましたか?
データ収集前に固定されたルールに基づいています:長期間のアップロード履歴を持つ広く知られたチャンネル、6つのコンテンツカテゴリーそれぞれ10チャンネルずつ、サムネイルの特徴ではなくカテゴリーのカバレッジを重視して選定。リストはスコアリング開始前に凍結・記録され、結果が現れた後にチャンネルを追加・削除することはできませんでした。
方法論を自分で確認できますか?
完全な事前登録(除外条件、ペアリングルール、主要テスト、4つのコントロール、帰無結果に対する事前に承諾した文言)は、動画のスコアリング前に作成・タイムスタンプされました。集計結果はここに報告されていますが、YouTubeのAPI利用規約に従い、基となる動画データは再公開されていません。