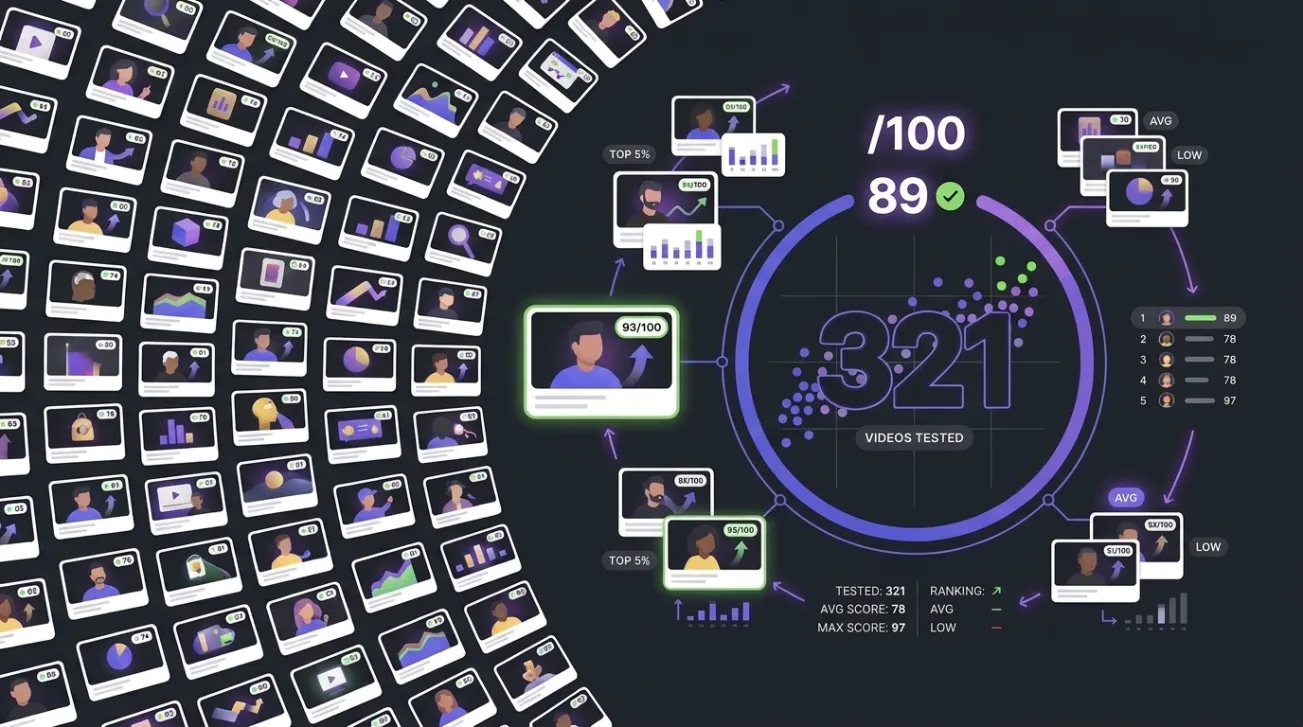
คะแนนภาพปกมีค่าก็ต่อเมื่อมันสะท้อนสิ่งที่เกิดขึ้นจริงบน YouTube ดังนั้นเราจึงทำการทดสอบที่อาจทำให้เราอับอาย: คู่วิดีโอจริง 321 คู่ แต่ละคู่มาจากช่องเดียวกัน หนึ่งคลิปที่ทำได้ดีกว่าค่าเฉลี่ยของช่องนั้น และอีกคลิปที่ทำได้แย่กว่า เราเขียนวิธีการไว้ล่วงหน้าก่อนจะดูข้อมูลใดๆ คะแนนนี้เลือกวิดีโอที่ทำได้ดีกว่าถูกต้อง 59.5% ของเวลา เทียบกับการโยนเหรียญที่มีโอกาส 50%
ข้อสรุปสำคัญ
- จาก 321 คู่ คะแนนจัดอันดับวิดีโอที่ทำได้ดีกว่าสูงกว่า 59.5% ของเวลา (p = 0.00079) โอกาสแบบสุ่มคือ 50%
- การเปรียบเทียบวิดีโอข้ามช่องวัดจำนวนผู้ติดตาม ไม่ใช่การแพ็คเกจ — ทุกคู่ในที่นี้มาจากช่องเดียวกัน โดยเผยแพร่ห่างกันเฉลี่ย 6 วัน
- ในช่องที่ภาพปกทุกอันใช้เทมเพลตเดียวกัน ความแม่นยำลดลงเหลือ 48.7% นี่คือผลลัพธ์ที่เราต้องการ: ไม่มีความแตกต่างให้อ่าน ไม่มีสัญญาณให้ค้นหา
- กฎง่ายๆ สี่ข้อ — ชื่อยาวกว่า คำมากกว่า ไฟล์ใหญ่กว่า คอนทราสต์สูงกว่า — ล้วนอยู่ในระดับโอกาส คะแนนนี้ไม่ใช่ตัวแทนของสิ่งใดสิ่งหนึ่งในนั้น
- ยิ่งช่องว่างที่โมเดลให้ระหว่างวิดีโอสองคลิปมากเท่าไร ยิ่งถูกต้องบ่อยขึ้น: 56% ที่ช่องว่าง 1-3 คะแนน, 76.5% ที่ 15 คะแนนหรือมากกว่า
คะแนนภาพปก YouTube สามารถทำนายผลลัพธ์ได้จริงหรือไม่?
ในการทดสอบนี้ ใช่ — อย่าง modest และวัดได้ เมื่อให้วิดีโอสองคลิปจากช่องเดียวกัน หนึ่งคลิปที่ทำได้ดีกว่าค่าฐานของช่องนั้นอย่างชัดเจน และอีกคลิปที่ทำได้แย่กว่าอย่างชัดเจน คะแนนของเราจัดอันดับถูกต้อง 59.5% ของเวลา โอกาสแบบสุ่มคือ 50% ช่วงความเชื่อมั่น 95% อยู่ที่ 53.9% ถึง 64.9% ดังนั้นผลลัพธ์จึงเป็นจริงแต่เล็กน้อย
เล็กน้อยคือคำตอบที่ซื่อสัตย์ และใครก็ตามที่อ้างว่ามากกว่านั้นกำลังขายสินค้า การแพ็คเกจเป็นเพียงหนึ่งในปัจจัยหลายอย่าง หัวข้อ เวลาอัปโหลด อารมณ์ของอัลกอริทึมในสัปดาห์นั้น หรือว่าวิดีโอถูกแชร์ที่ไหนนอกแพลตฟอร์ม — ทั้งหมดนี้ส่งผลต่อจำนวนวิวมากกว่าภาพปก คะแนนที่อ้างว่าแม่นยำ 90% จะอธิบาย YouTube ที่ไม่มีอยู่จริง
59.5% หมายถึงอะไรในทางปฏิบัติ: หากคุณกำลังเลือกระหว่างสองตัวเลือกสำหรับวิดีโอเดียวกัน คะแนนนี้ดีกว่าการเดา และยิ่งมีความมั่นใจมากเท่าไร ก็ยิ่งมีประโยชน์มากขึ้นเท่านั้น
ทำไมการเปรียบเทียบภาพปกข้ามช่องจึงไม่ให้ข้อมูลใดๆ
รูปแบบที่เห็นได้ชัดเจนที่สุดของการทดสอบนี้คือการให้คะแนนชุดภาพปกแล้วหาความสัมพันธ์กับจำนวนวิว นั่นวัดขนาดของช่อง จำนวนวิวถูกขับเคลื่อนโดยจำนวนผู้ติดตาม หัวข้อ และอายุวิดีโอมากกว่าการแพ็คเกจ และปัจจัยรบกวนนั้นไปในทิศทางที่ดูดี: ช่องใหญ่สามารถจ้างนักออกแบบที่ดี และ มีผู้ชมจำนวนมาก
ทำการทดสอบนั้นแล้วคุณจะได้ความสัมพันธ์เชิงบวกที่ไม่มีความหมาย มันจะอยู่รอดได้เพียงหนึ่งผู้อ่านที่สงสัย
สิ่งที่การเปรียบเทียบที่ยุติธรรมต้องคงไว้
การเปรียบเทียบวิดีโอสองคลิปจากช่องเดียวกันจะตัดจำนวนผู้ติดตาม ผู้ชม งบประมาณ และความสามารถในการออกแบบในขั้นตอนเดียว เพราะทั้งสี่อย่างนี้เหมือนกันภายในคู่นั้น การกำหนดให้ทั้งสองคลิปเผยแพร่ใกล้เคียงกันจะตัดเส้นโค้งการเติบโตของช่องและระบบที่อัลกอริทึมใช้ในช่วงเวลานั้นออกไปด้วย
สิ่งที่เหลืออยู่คือคำถามที่มีคำตอบที่รู้อยู่แล้วภายใต้สมมติฐานศูนย์: ให้วิดีโอสองคลิปที่ผู้ชมของช่องนั้นปฏิบัติต่ออย่างแตกต่างกันมาก คะแนนนี้สามารถบอกได้ว่าอันไหนคืออันไหนหรือไม่?
เราสร้างการทดสอบที่ยุติธรรมบนคู่ที่จับคู่กัน 321 คู่อย่างไร
เราเลือก 60 ช่องจากหกหมวดหมู่ — เทคโนโลยี การศึกษา การทำอาหาร เกมส์ ฟิตเนส และไลฟ์สไตล์ — และดึงอัปโหลดล่าสุดสูงสุด 300 คลิปจากแต่ละช่อง หลังจากตัดออกแล้วเหลือวิดีโอที่พิจารณา 17,250 คลิป และคู่ที่ใช้งานได้ 321 คู่ ทุกคู่มาจากช่องเดียวกัน เผยแพร่ห่างกันเฉลี่ย 6 วัน โดยคลิปที่ทำได้ดีกว่าเอาชนะคลิปที่ทำได้แย่กว่าด้วยอัตราส่วนเฉลี่ย 4.7 เท่า
ผลลัพธ์วัดจากค่าฐานท้องถิ่นแบบเลื่อน ไม่ใช่ค่าเฉลี่ยของช่องทั้งหมด สำหรับแต่ละวิดีโอ เราใช้ค่ามัธยฐานของจำนวนวิวจากอัปโหลดที่อยู่ใกล้เคียง 10 คลิปทั้งสองข้าง ไม่รวมตัวเอง และแสดงจำนวนวิวของตัวเองเป็นเท่าของค่านั้น ช่องที่เติบโตขึ้นห้าเท่าในสองปีจะมีวิดีโอทุกคลิปในช่วงแรกถูกติดป้ายว่าล้มเหลว และวิดีโอทุกคลิปในช่วงหลังถูกติดป้ายว่าประสบความสำเร็จ — วัดจากปฏิทิน ไม่ใช่การแพ็คเกจ
กฎการจับคู่ถูกกำหนดไว้ล่วงหน้า:
- วิดีโอทั้งสองมาจากช่องเดียวกัน และแต่ละวิดีโอปรากฏในคู่ได้ไม่เกินหนึ่งคู่
- เผยแพร่ภายใน 120 วันของกันและกัน
- คลิปที่ทำได้ดีกว่าเอาชนะคลิปที่ทำได้แย่กว่าอย่างน้อยสองเท่า เพื่อให้ "ดีกว่า" และ "แย่กว่า" มีความหมาย ไม่ใช่เพียงอธิบายเสียงรบกวน
- ไม่มีช่องใดมีส่วนร่วมเกินแปดคู่ เพื่อไม่ให้ผู้อัปโหลดที่ผลิตมากเกินไปครอบงำตัวอย่าง
วิดีโอประเภท Shorts ถูกตัดออก รวมถึงการถ่ายทอดสด วิดีโอที่อายุน้อยกว่า 45 วัน และวิดีโอที่อายุเกินสองปี คะแนนเห็นเพียงภาพปกและชื่อ — ตรงตามสิ่งที่เครื่องมือได้รับจากผู้ใช้ — และไม่มีข้อมูลใดๆ เกี่ยวกับจำนวนวิวหรือว่าเป็นด้านไหนของคู่นั้น
สิ่งที่คะแนนทำถูกต้อง และบ่อยแค่ไหน
โมเดลเลือกวิดีโอที่ทำได้ดีกว่าใน 191 จาก 321 คู่: 59.5% โดยมีค่า p แบบทวินามที่แน่นอน 0.00079 เทียบกับสมมติฐานศูนย์ที่ 50% คู่ 17 คู่ได้คะแนนเท่ากัน และทุกคู่นั้นถูกนับว่าล้มเหลว ไม่ใช่แบ่งหรือตัดออก เพราะคะแนนที่ไม่สามารถแยกสองอินพุตได้ ยังไม่ได้แยกแยะระหว่างพวกมัน
การนับการผูกกันเป็นความล้มเหลวทำให้ตัวเลขหลักนี้มีความระมัดระวัง โมเดลที่ไม่มีความสามารถเลยจะได้คะแนนประมาณ 47.4% ภายใต้กฎนี้ ไม่ใช่ 50% ดังนั้นการทดสอบจึงขอให้โมเดลของเราข้ามเกณฑ์ที่สูงกว่าระดับโอกาสจริงเล็กน้อย ระหว่าง 304 คู่ที่มันแยกได้จริง มันถูกต้อง 62.8% ของเวลา
ความมั่นใจสัมพันธ์กับความถูกต้อง
รูปแบบที่ทำให้ผลลัพธ์นี้ดูเหมือนการวัด ไม่ใช่เรื่องบังเอิญ: ยิ่งคะแนนให้ช่องว่างระหว่างวิดีโอสองคลิปมากเท่าไร ยิ่งถูกต้องบ่อยขึ้น
ที่ช่องว่าง 1-3 คะแนน ความแม่นยำคือ 56.0% ที่ 4-7 คะแนน 64.1% ที่ 8-14 คะแนน 63.2% ที่ 15 คะแนนหรือมากกว่า 76.5% โมเดลที่สร้างเสียงรบกวนจะแสดงเส้นตรงข้ามกลุ่มเหล่านี้ โมเดลนี้ดีขึ้นเรื่อยๆ เมื่อมันมั่นใจมากขึ้น ซึ่งเป็นพฤติกรรมที่คุณต้องการและไม่สามารถปลอมแปลงได้
การตรวจสอบสี่ข้อที่อาจพิสูจน์ว่าเราผิด
การศึกษาที่ไม่สามารถล้มเหลวได้ ไม่ใช่หลักฐาน เราได้ระบุการควบคุมสี่ข้อไว้ล่วงหน้า แต่ละข้อสามารถทำให้ข่าวหลักเป็นโมฆะ และสัญญาที่จะเผยแพร่ทั้งสี่ข้อไม่ว่าจะแสดงอะไร ทุกข้อแสดงพฤติกรรมตามที่ควรจะเป็น
| การควบคุม | สิ่งที่ความล้มเหลวจะหมายถึง | ผลลัพธ์ |
|---|---|---|
| สลับป้ายผู้ชนะ/ผู้แพ้ 1,000 ครั้ง | กระบวนการรั่วไหลคำตอบ; ผลลัพธ์ทั้งหมดเป็นโมฆะ | 47.1% ตรงตามที่ทฤษฎีบอกว่าต้องอยู่ |
| ช่องที่ภาพปกใช้เทมเพลตเดียว | คะแนนอ่านสิ่งอื่นนอกเหนือจากการแพ็คเกจ | 48.7% — โอกาส ตามที่คาดไว้ |
| กฎง่ายๆ: ความยาวชื่อ จำนวนคำ ขนาดไฟล์ คอนทราสต์ | กฎหนึ่งบรรทัดตรงกับโมเดล ดังนั้นโมเดลจึงไม่เพิ่มอะไร | 46.7%-54.5% ไม่มีสิ่งใดมีนัยสำคัญ |
| ให้คะแนนภาพปกทุกอันใหม่กับชื่อของวิดีโออีกอัน | ชื่อไม่มีส่วนร่วม และเราให้คะแนนเพียงครึ่งเดียว ไม่ใช่สองส่วน | คะแนนเปลี่ยนไปเฉลี่ย 11.3 คะแนน |
การตรวจสอบเทมเพลตคือสิ่งที่สำคัญที่สุด และควรชัดเจนว่าทำไม ในช่องที่ใช้เลย์เอาต์ภาพปกเดียวกันสำหรับทุกอย่าง มีสิ่งที่โมเดลภาพสามารถเปรียบเทียบได้น้อยมาก หากคะแนนของเราเลือกผู้ชนะอย่างมั่นใจที่นั่น มันจะอ่านตัวตนของช่องหรือยุคสมัยการอัปโหลด ไม่ใช่การแพ็คเกจ มันได้คะแนน 48.7% บนช่องเหล่านั้น และ 61.0% ทุกที่อื่น ช่องว่างนี้คือหลักฐานที่แข็งแกร่งที่สุดของงานวิจัยนี้ว่าสิ่งที่วัดอยู่คือสิ่งที่เราอ้าง
มิติการให้คะแนนใดที่แยกผู้ชนะจากผู้แพ้
ส่วนนี้เป็นการสำรวจ ไม่ใช่การยืนยัน และอธิบายตัวอย่างนี้ ไม่ใช่ YouTube โดยทั่วไป การจัดอันดับคะแนนย่อยสิบสองตัวตามความห่างที่แยกกลุ่มทั้งสอง ความชัดเจนของคำสัญญาเป็นสิ่งที่แยกได้ชัดเจนที่สุด ตามด้วยสัญญาณความกลัวว่าจะพลาดและแรงเร่ง อารมณ์เข้มข้นแทบไม่แยกพวกมันเลย
ความชัดเจนของคำสัญญา — ความชัดเจนที่การแพ็คเกจบอกคุณว่าคุณกำลังจะดูอะไร — นำหน้าตารางสอดคล้องกับสิ่งที่ด้านความพึงพอใจของโมเดลถูกสร้างขึ้นเพื่อจับ ด้านที่อ่อนแอกว่าคือความเข้มข้นของอารมณ์ดิบ ซึ่งน่าสนใจกว่า: อารมณ์แรงในภาพปกไม่ได้แยกแยะระหว่างวิดีโอที่ทำได้ดีกับที่ทำได้แย่ในตัวอย่างนี้ ซึ่งไม่ใช่สิ่งที่คำแนะนำภาพปกส่วนใหญ่สมมติ
หากคุณต้องการเห็นมิติเหล่านี้บนการแพ็คเกจของคุณเอง แทนที่จะเป็นในรูปแบบรวม คุณสามารถ นำภาพปกและชื่อผ่านกระบวนการให้คะแนนเดียวกันที่การศึกษานี้ใช้ — มันคือเส้นทางโค้ดเดียวกัน ไม่ใช่เวอร์ชันตัวอย่าง
การทดสอบนี้ไม่ได้พิสูจน์อะไร
สี่ข้อจำกัด ทั้งหมดถูกเขียนไว้ก่อนที่ข้อมูลจะมีอยู่
มันทดสอบคะแนน ไม่ใช่คำแนะนำ ว่าการดำเนินการตามชื่อที่แนะนำจะปรับปรุงวิดีโอจริงหรือไม่ เป็นการทดลองอีกแบบที่เราไม่ได้ทำ มันเป็นการสังเกต ไม่ใช่เหตุและผล: ไม่มีสิ่งใดที่นี่แสดงว่าการเปลี่ยนภาพปกจะเปลี่ยนจำนวนวิว เพียงแต่คะแนนนั้นสัมพันธ์กับความแตกต่างที่มีอยู่แล้ว
ตัวอย่างตัดสินว่าผลลัพธ์นี้ใช้กับใคร
คู่ถูกเลือกอย่างแม่นยำเพราะพวกมันแตกต่างกันอย่างชัดเจนในผลลัพธ์ ดังนั้น 59.5% จึงอธิบายประชากรนั้น — ผู้ทำได้ดีชัดเจนเทียบกับผู้ทำได้แย่ชัดเจน — ไม่ใช่วิดีโอสองคลิปที่เลือกมาแบบสุ่ม ทุกช่องมีความมั่นคง ใช้ภาษาอังกฤษ และใหญ่พอที่จะมีค่าฐานที่มั่นคง ไม่มีสิ่งใดที่นี่สามารถนำไปใช้กับช่องที่มีอัปโหลดเพียงสิบสองคลิปและไม่มีประวัติให้วัด
จำนวนวิวถูกบันทึกในวันเดียวและยังคงเพิ่มขึ้น ทั้งหมดนี้เป็นภาพถ่ายช่วงเวลาเดียว และวิธีที่ซื่อสัตย์ในการจัดการกับภาพถ่ายช่วงเวลาคือการถ่ายอีกครั้งในภายหลัง
คำถามที่พบบ่อย
ความแม่นยำ 59.5% ดีสำหรับคะแนนภาพปกหรือไม่?
สำหรับสัญญาณการแพ็คเกจเดียวเทียบกับผลลัพธ์ในโลกจริง ใช่ จำนวนวิวขึ้นอยู่กับหัวข้อ ขนาดผู้ชม เวลา และโชคของอัลกอริทึมเป็นหลัก ดังนั้นคะแนนภาพปกและชื่อจึงสามารถอธิบายได้เพียงส่วนหนึ่งเท่านั้น ตัวเลขที่ใกล้เคียง 90% มากกว่าจะบ่งชี้ว่ามีช่องโหว่ในออกแบบการทดสอบ ไม่ใช่โมเดลที่ดีกว่า กรอบที่มีประโยชน์คือมันดีกว่าการเดา และดีกว่าอย่างเด็ดขาดเมื่อมันมั่นใจ
ทำไมไม่เปรียบเทียบคะแนนภาพปกกับจำนวนวิวโดยตรงล่ะ?
เพราะนั่นวัดขนาดของช่อง จำนวนผู้ติดตาม หัวข้อ และอายุวิดีโอมีผลต่อจำนวนวิวมากกว่าการแพ็คเกจ และช่องใหญ่โดยทั่วไปมีนักออกแบบที่ดีกว่าและผู้ชมมากกว่า — ดังนั้นความสัมพันธ์จึงออกมาเป็นบวกด้วยเหตุผลที่ไม่มีความเกี่ยวข้องกับภาพปก การเปรียบเทียบวิดีโอสองคลิปจากช่องเดียวกันจะตัดสิ่งทั้งหมดนั้นออกในขั้นตอนเดียว
การนับการผูกกันเป็นความล้มเหลวหมายถึงอะไร?
คู่ 17 คู่ได้คะแนนเท่ากันทั้งสองด้าน แทนที่จะแบ่งหรือลบออก ซึ่งจะทำให้ผลลัพธ์ดูดีขึ้น แต่ละคู่ถูกบันทึกว่าผิดพลาด คะแนนที่ไม่สามารถแยกอินพุตสองตัวได้ ยังไม่ได้แยกแยะระหว่างพวกมัน สิ่งนี้ทำให้ 59.5% ที่รายงานต่ำกว่าการรักษาอื่นๆ ที่อาจผลิตได้
คะแนนภาพปกที่สูงกว่าหมายถึงวิวมากกว่าหรือไม่?
ไม่ การศึกษานี้แสดงความสัมพันธ์ข้ามหลายคู่ ไม่ใช่คำสัญญาเกี่ยวกับวิดีโอใดๆ หนึ่ง ประมาณสี่ในสิบคู่ถูกจัดอันดับผิดทาง การแพ็คเกจเป็นเพียงคันบังคับหนึ่งในหลายอย่าง และคะแนนที่แข็งแกร่งบนวิดีโอที่ไม่มีใครอยากดู จะไม่สามารถช่วยชีวิตมันได้
ช่อง 60 ช่องนี้เลือกอย่างไร?
โดยกฎที่กำหนดไว้ก่อนที่จะรวบรวมข้อมูลใดๆ: ช่องที่เป็นที่รู้จักอย่างกว้างขวาง มีประวัติการอัปโหลดยาวนาน ช่องละสิบช่อง จากหกหมวดหมู่เนื้อหา เลือกเพื่อครอบคลุมหมวดหมู่ ไม่ใช่เพื่อสิ่งใดเกี่ยวกับภาพปกของพวกเขา รายการถูกแช่แข็งและบันทึกไว้ก่อนเริ่มการให้คะแนน ดังนั้นไม่มีช่องใดสามารถเพิ่มหรือลบออกได้หลังจากผลลัพธ์เริ่มปรากฏ
ฉันสามารถดูวิธีการและตรวจสอบด้วยตัวเองได้ไหม?
การลงทะเบียนล่วงหน้าเต็มรูปแบบ — การตัดออก กฎการจับคู่ การทดสอบหลัก การควบคุมทั้งสี่ และคำพูดที่สัญญาไว้ล่วงหน้าสำหรับผลลัพธ์ศูนย์ — ถูกเขียนและประทับเวลาไว้ก่อนที่จะให้คะแนนวิดีโอใดๆ ผลลัพธ์รวมถูกรายงานที่นี่; ข้อมูลวิดีโอพื้นฐานไม่ได้เผยแพร่อีกครั้ง ตามข้อกำหนดของ API ของ YouTube